Mapa de enfermedades: cómo conectar genes y dolencias exprés
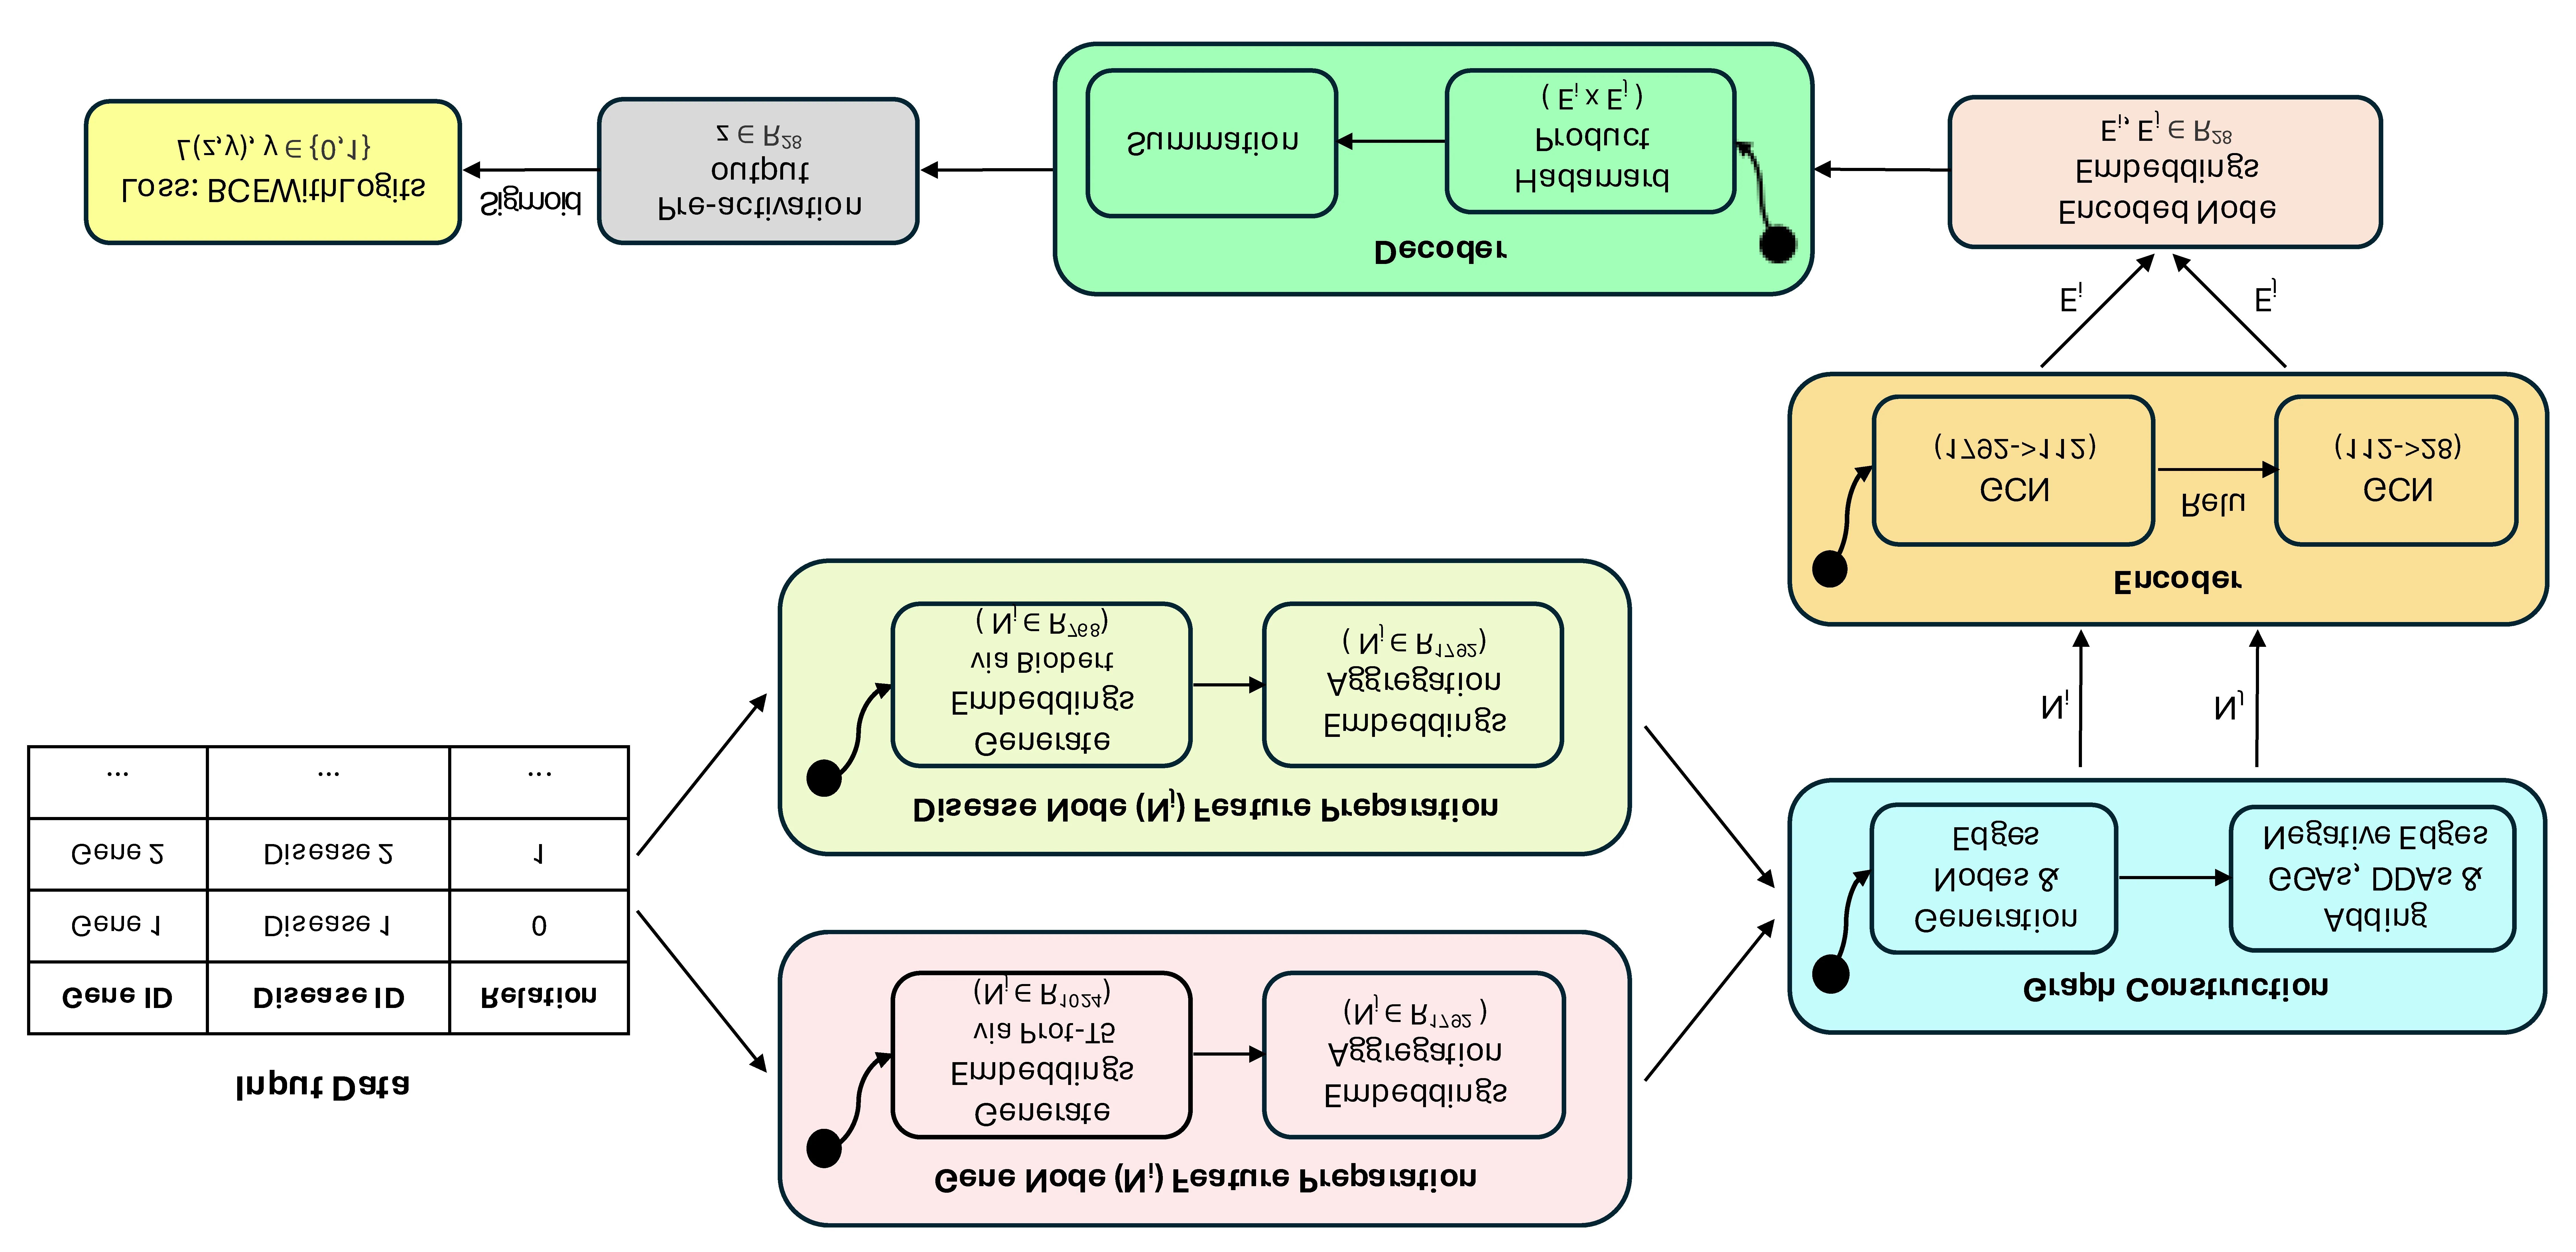
Dentro de cada célula hay un trabajo incesante: las proteínas se comunican, los genes se activan y se desactivan, y los fallos en este sistema conducen a enfermedades. Para encontrar al culpable de una dolencia, los científicos solían revisar manualmente artículos científicos y bases de datos, como un detective que interroga a los testigos uno por uno. Pero hay tantas conexiones que es imposible manejarlas en solitario.
El nuevo modelo GLaDiGAtor funciona como un grafo inteligente: construye un mapa donde los puntos son genes y enfermedades, y las líneas entre ellos son interacciones conocidas. Luego aprende de este mapa, como si fuera un conjunto de ejemplos, y predice dónde deberían estar las líneas que faltan. En el mapa también se integran pistas textuales: descripciones de enfermedades y secuencias de proteínas que el modelo lee como anotaciones en los puntos. Gracias a esto, no solo ve conexiones directas, sino también patrones ocultos.
Este enfoque acelera la búsqueda de genes diana para fármacos. En lugar de meses de trabajo manual, solo unas horas de cálculo. Y cuantos más datos se incorporan al mapa, más precisas son las predicciones. Quizás pronto podamos ver de antemano qué gen fallará en una enfermedad determinada y preparar el tratamiento antes de que aparezcan los síntomas.
Resumen original
tal como lo escribieron los autores, en inglés arXiv:2602.18769
Understanding disease-gene associations is essential for unravelling disease mechanisms and advancing diagnostics and therapeutics. Traditional approaches based on manual curation and literature review are labour-intensive and not scalable, prompting the use of machine learning on large biomedical data. In particular, graph neural networks (GNNs) have shown promise for modelling complex biological relationships. To address limitations in existing models, we propose GLaDiGAtor (Graph Learning-bAsed DIsease-Gene AssociaTiOn pRediction), a novel GNN framework with an encoder-decoder architecture for disease-gene association prediction. GLaDiGAtor constructs a heterogeneous biological graph integrating gene-gene, disease-disease, and gene-disease interactions from curated databases, and enriches each node with contextual features from well-known language models (ProtT5 for protein sequences and BioBERT for disease text). In evaluations, our model achieves superior predictive accuracy and generalisation, outperforming 14 existing methods. Literature-supported case studies confirm the biological relevance of high-confidence novel predictions, highlighting GLaDiGAtor's potential to discover candidate disease genes. These results underscore the power of graph convolutional networks in biomedical informatics and may ultimately facilitate drug discovery by revealing new gene-disease links. The source code and processed datasets are publicly available at https://github.com/HUBioDataLab/GLaDiGAtor.
El modelo utiliza dos lenguajes: uno "lee" secuencias de proteínas y el otro textos médicos, y los combina en un único mapa.