Cómo las modelos de lenguaje detectan repeticiones en las proteínas exprés
Las proteínas son cadenas de aminoácidos, y en ellas abundan los fragmentos repetidos. A veces las repeticiones son exactas, como una misma frase dicha dos veces. Otras veces llevan erratas: un par de letras cambiadas, pero el sentido sigue siendo el mismo. Estas repeticiones son importantes: ayudan a la proteína a plegarse en la forma adecuada y a realizar su función.
Los científicos ya sabían que las modelos de lenguaje entrenadas con millones de secuencias proteicas son capaces de encontrar estas repeticiones. Pero cómo lo hacían exactamente seguía siendo un misterio. En la nueva investigación, los autores se adentraron en el interior de la modelo y siguieron su funcionamiento paso a paso. Descubrieron que el mecanismo para repeticiones inexactas es más general: incluye también el mecanismo para repeticiones exactas, como si saber leer un texto con erratas te diera automáticamente la habilidad de leer un texto sin ellas.
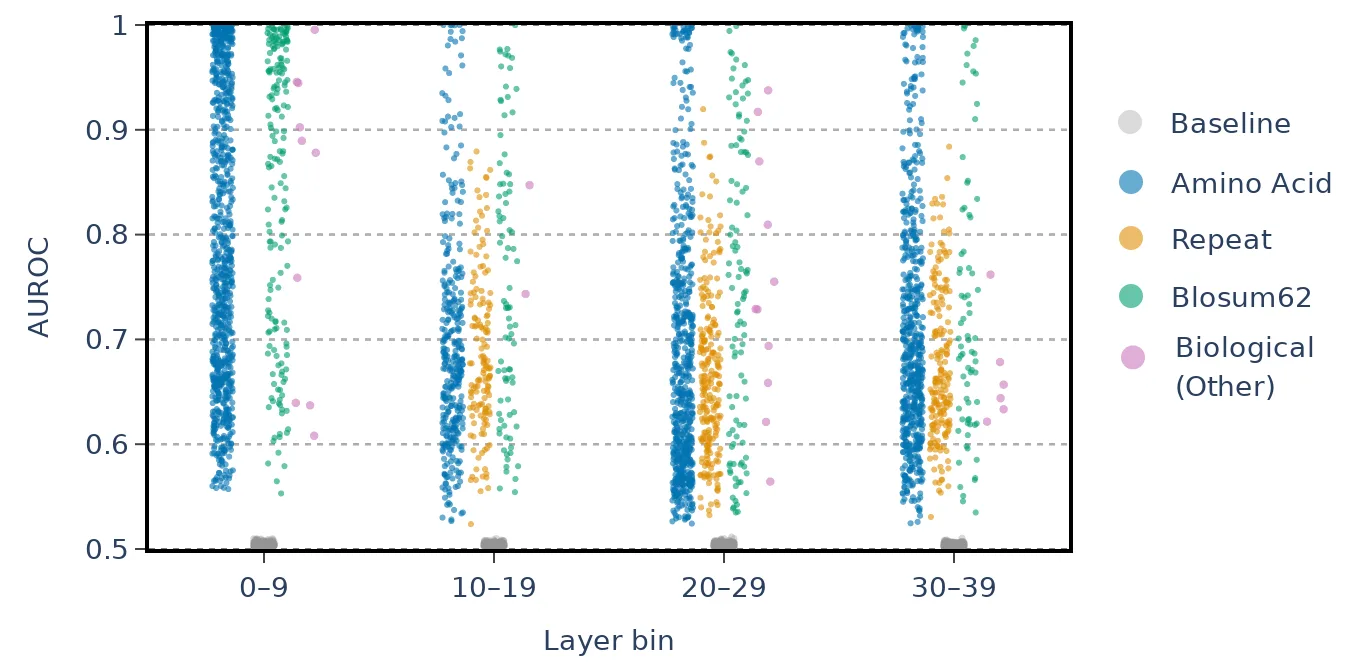
Después, las llamadas 'cabezas de inducción' de la atención localizan fragmentos iguales o similares en distintos puntos de la cadena y transfieren información entre ellos. Esto ayuda a la modelo a predecir qué aminoácido debería ocupar un hueco. Así, la modelo de lenguaje combina un mecanismo general de búsqueda de patrones con conocimientos biológicos sobre las propiedades de los aminoácidos.
Este hallazgo es un paso hacia la comprensión de cómo las modelos pueden captar procesos evolutivos más complejos inscritos en las secuencias proteicas. Y, por tanto, en el futuro podrán predecir mejor la estructura y la función de las proteínas, algo crucial para el desarrollo de fármacos y la biotecnología.
Resumen original
tal como lo escribieron los autores, en inglés arXiv:2602.23179
Protein sequences are abundant in repeating segments, both as exact copies and as approximate segments with mutations. These repeats are important for protein structure and function, motivating decades of algorithmic work on repeat identification. Recent work has shown that protein language models (PLMs) identify repeats, by examining their behavior in masked-token prediction. To elucidate their internal mechanisms, we investigate how PLMs detect both exact and approximate repeats. We find that the mechanism for approximate repeats functionally subsumes that of exact repeats. We then characterize this mechanism, revealing two main stages: PLMs first build feature representations using both general positional attention heads and biologically specialized components, such as neurons that encode amino-acid similarity. Then, induction heads attend to aligned tokens across repeated segments, promoting the correct answer. Our results reveal how PLMs solve this biological task by combining language-based pattern matching with specialized biological knowledge, thereby establishing a basis for studying more complex evolutionary processes in PLMs.
En las proteínas, las repeticiones pueden ser muy largas: por ejemplo, la titina, que confiere elasticidad a los músculos, contiene cientos de dominios repetidos, semejantes a los eslabones de una cadena.