46 formas de calcular el riesgo exprés
Los genetistas leen el ADN como una larga lista de letras. A partir de ella calculan una «puntuación de riesgo poligénico»: un número que indica si una persona tiene una probabilidad mayor o menor que la media de padecer, por ejemplo, diabetes. Actualmente existen decenas de métodos para calcular este riesgo, y cada uno lo hace a su manera: uno examina mil letras, otro un millón, un tercero requiere un ordenador potente, y un cuarto falla a mitad de los datos.
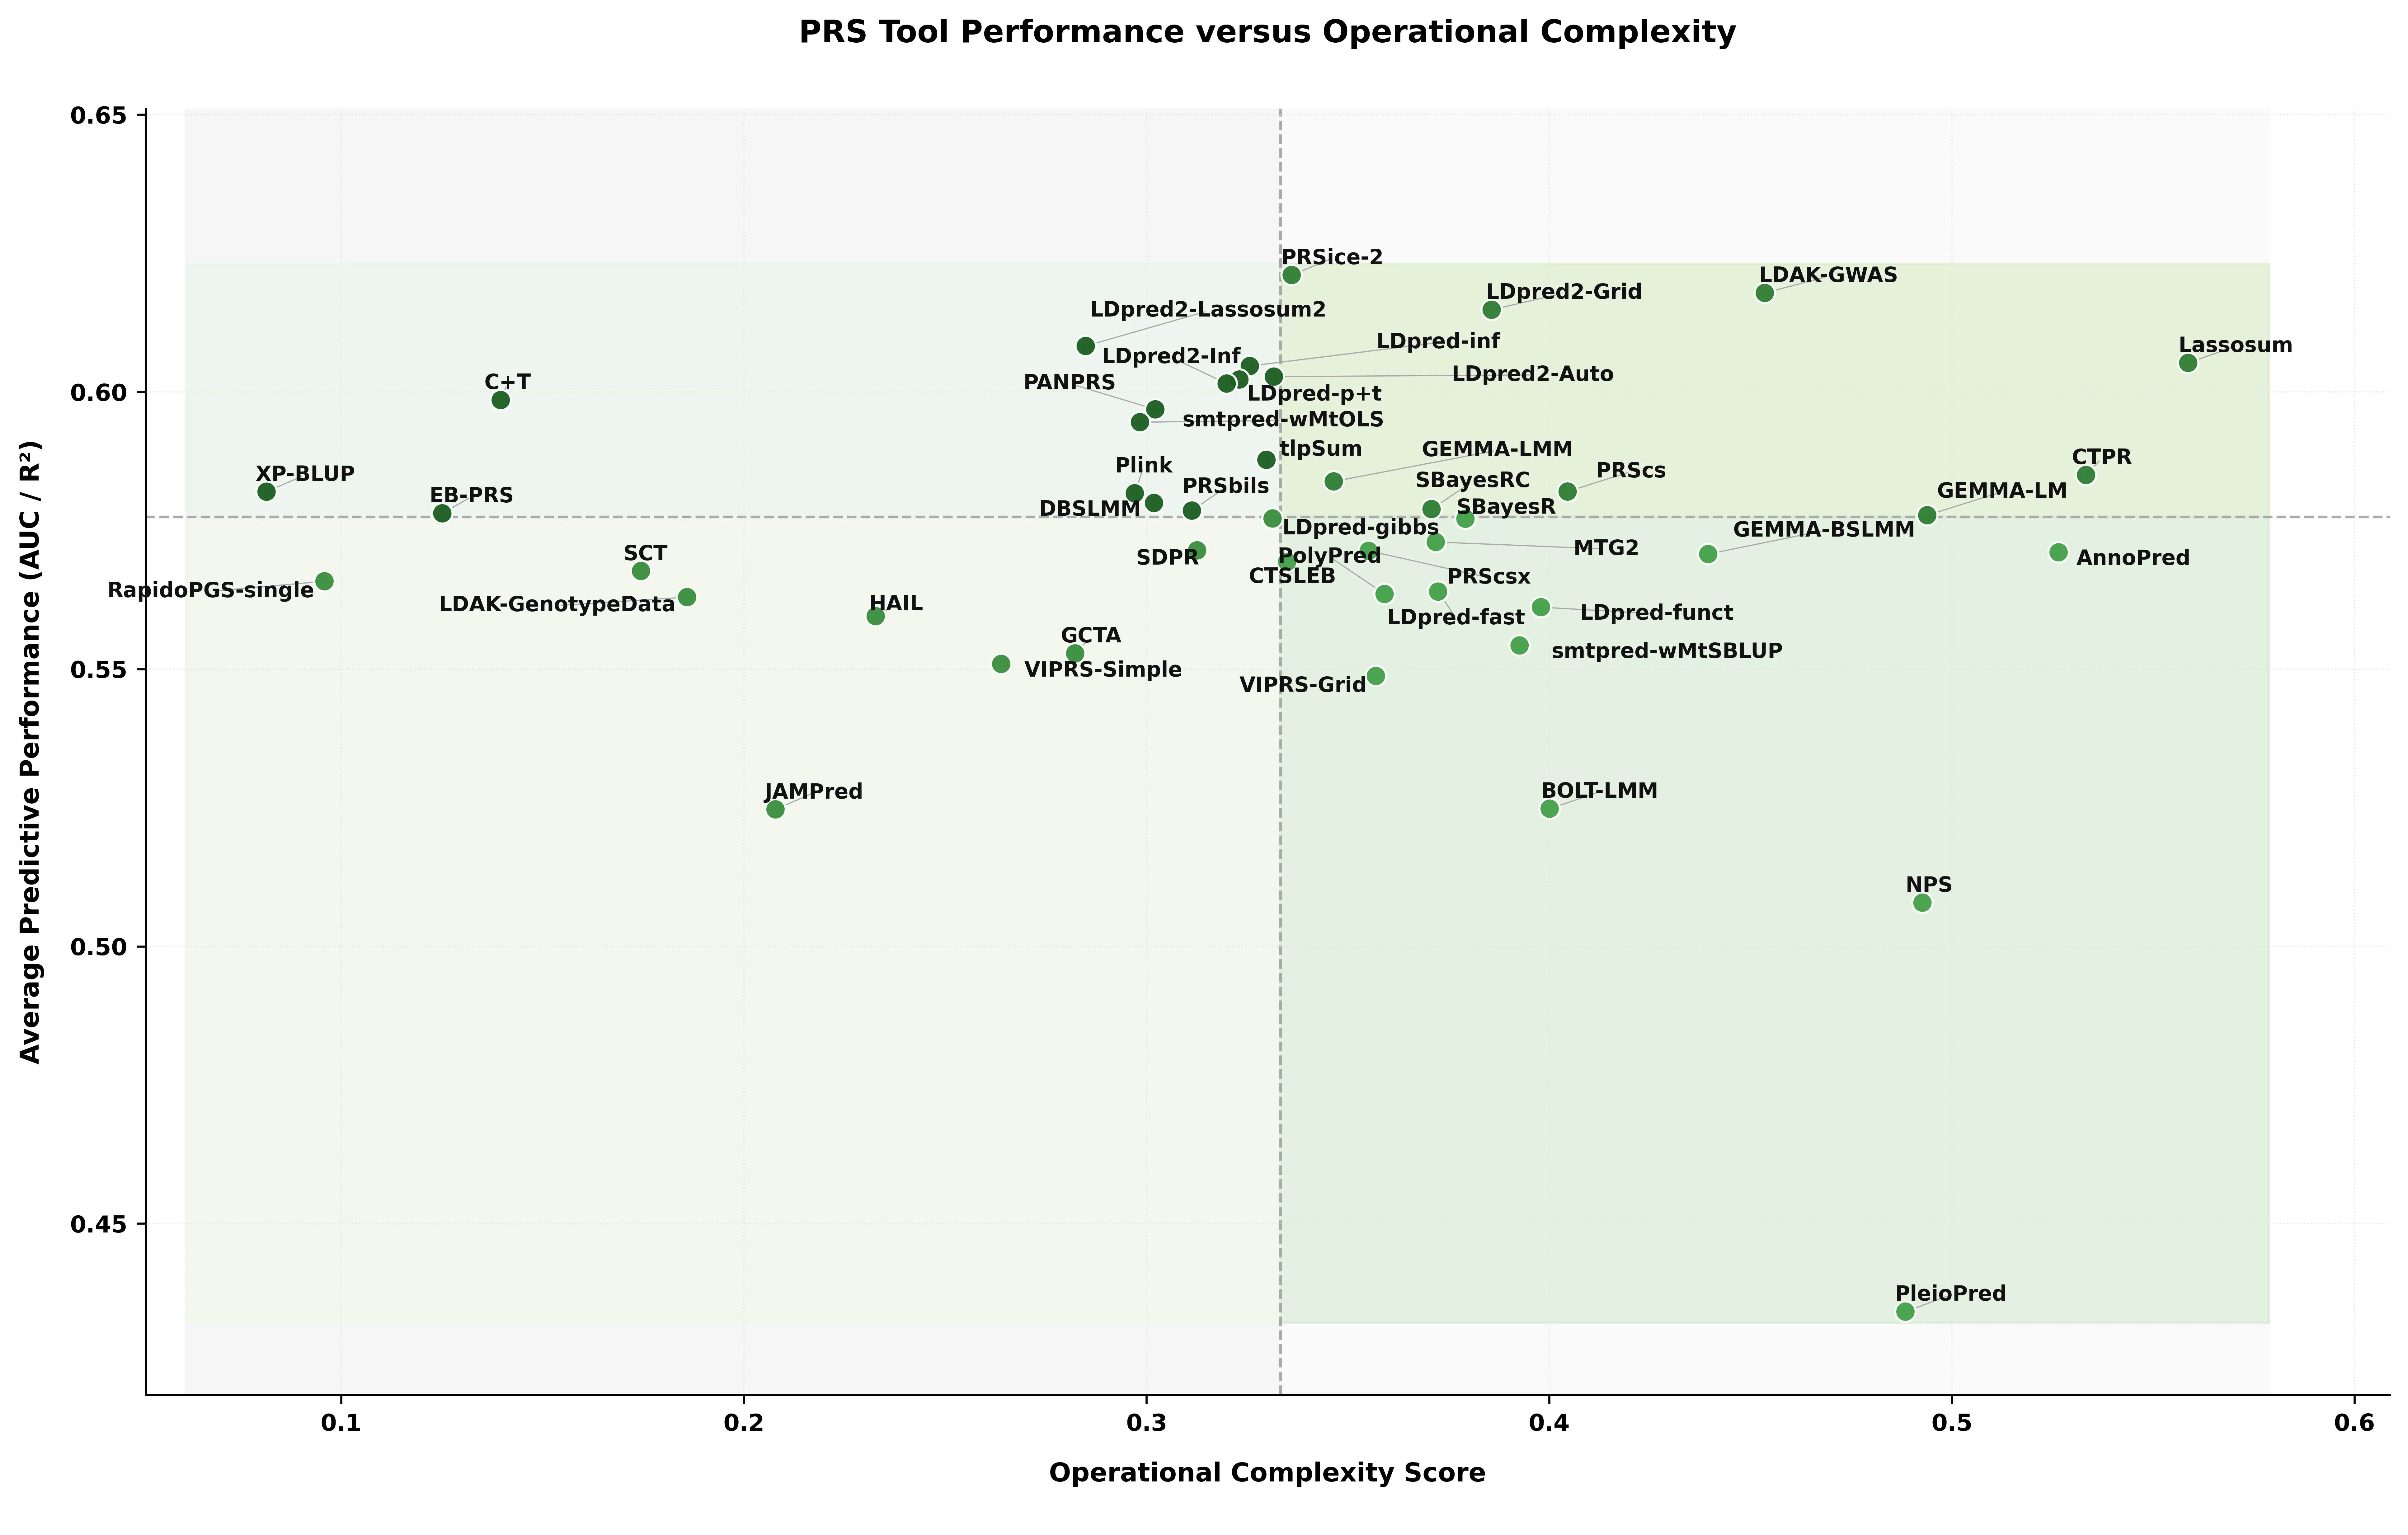
Los autores del estudio reunieron 46 de estas herramientas y les hicieron un examen justo. Tomaron datos del biobanco británico, que almacena muestras de ADN e historiales médicos de cientos de miles de personas. Cada herramienta debía predecir siete enfermedades y un rasgo común (por ejemplo, la altura). Las probaron en tres situaciones: sin datos adicionales, solo con ADN, y junto con edad, sexo y otra información. Resultó que no hay un ganador universal: una herramienta es buena para la diabetes, otra para el asma, y una tercera es la más rápida, aunque ligeramente menos precisa.
La conclusión práctica es sencilla: elegir una herramienta no es solo cuestión de matemáticas. Hay que considerar cuántos datos se tienen, la potencia del ordenador y si el programa es capaz de no fallar a mitad del cálculo. Los autores hicieron público su marco de trabajo para que cualquier investigador pueda repetir la comparación con sus propios datos y no tropezar con las mismas piedras.
Resumen original
tal como lo escribieron los autores, en inglés arXiv:2603.21201
Polygenic risk score (PRS) tools differ substantially in statistical assumptions, input requirements, and implementation complexity, making direct comparison difficult. We developed a harmonized, implementation-aware benchmarking framework to evaluate 46 PRS tools across seven binary UK Biobank phenotypes and one continuous trait under three model configurations: null, PRS-only, and PRS plus covariates. The framework integrates standardized preprocessing, tool-specific execution, hyperparameter exploration, and unified downstream evaluation using five-fold cross-validation on high-performance computing infrastructure. In addition to predictive performance, we assessed runtime, memory use, input dependencies, and failure modes. A Friedman test across 40 phenotype--fold combinations confirmed significant differences in tool rankings ($$\chi^2 = 102.29$$, $$p = 2.57 \times 10^{-11}$$), with no single method universally optimal. These findings provide a reproducible framework for comparative PRS evaluation and demonstrate that tool performance is shaped not only by statistical methodology but also by phenotype architecture, preprocessing choices, covariate structure, computational demands, software robustness, and practical implementation constraints.
Una de las herramientas de la prueba podía ocupar 100 veces más memoria que otra, con una precisión casi idéntica en las predicciones.