Cómo distinguir una mutación peligrosa de una inofensiva exprés
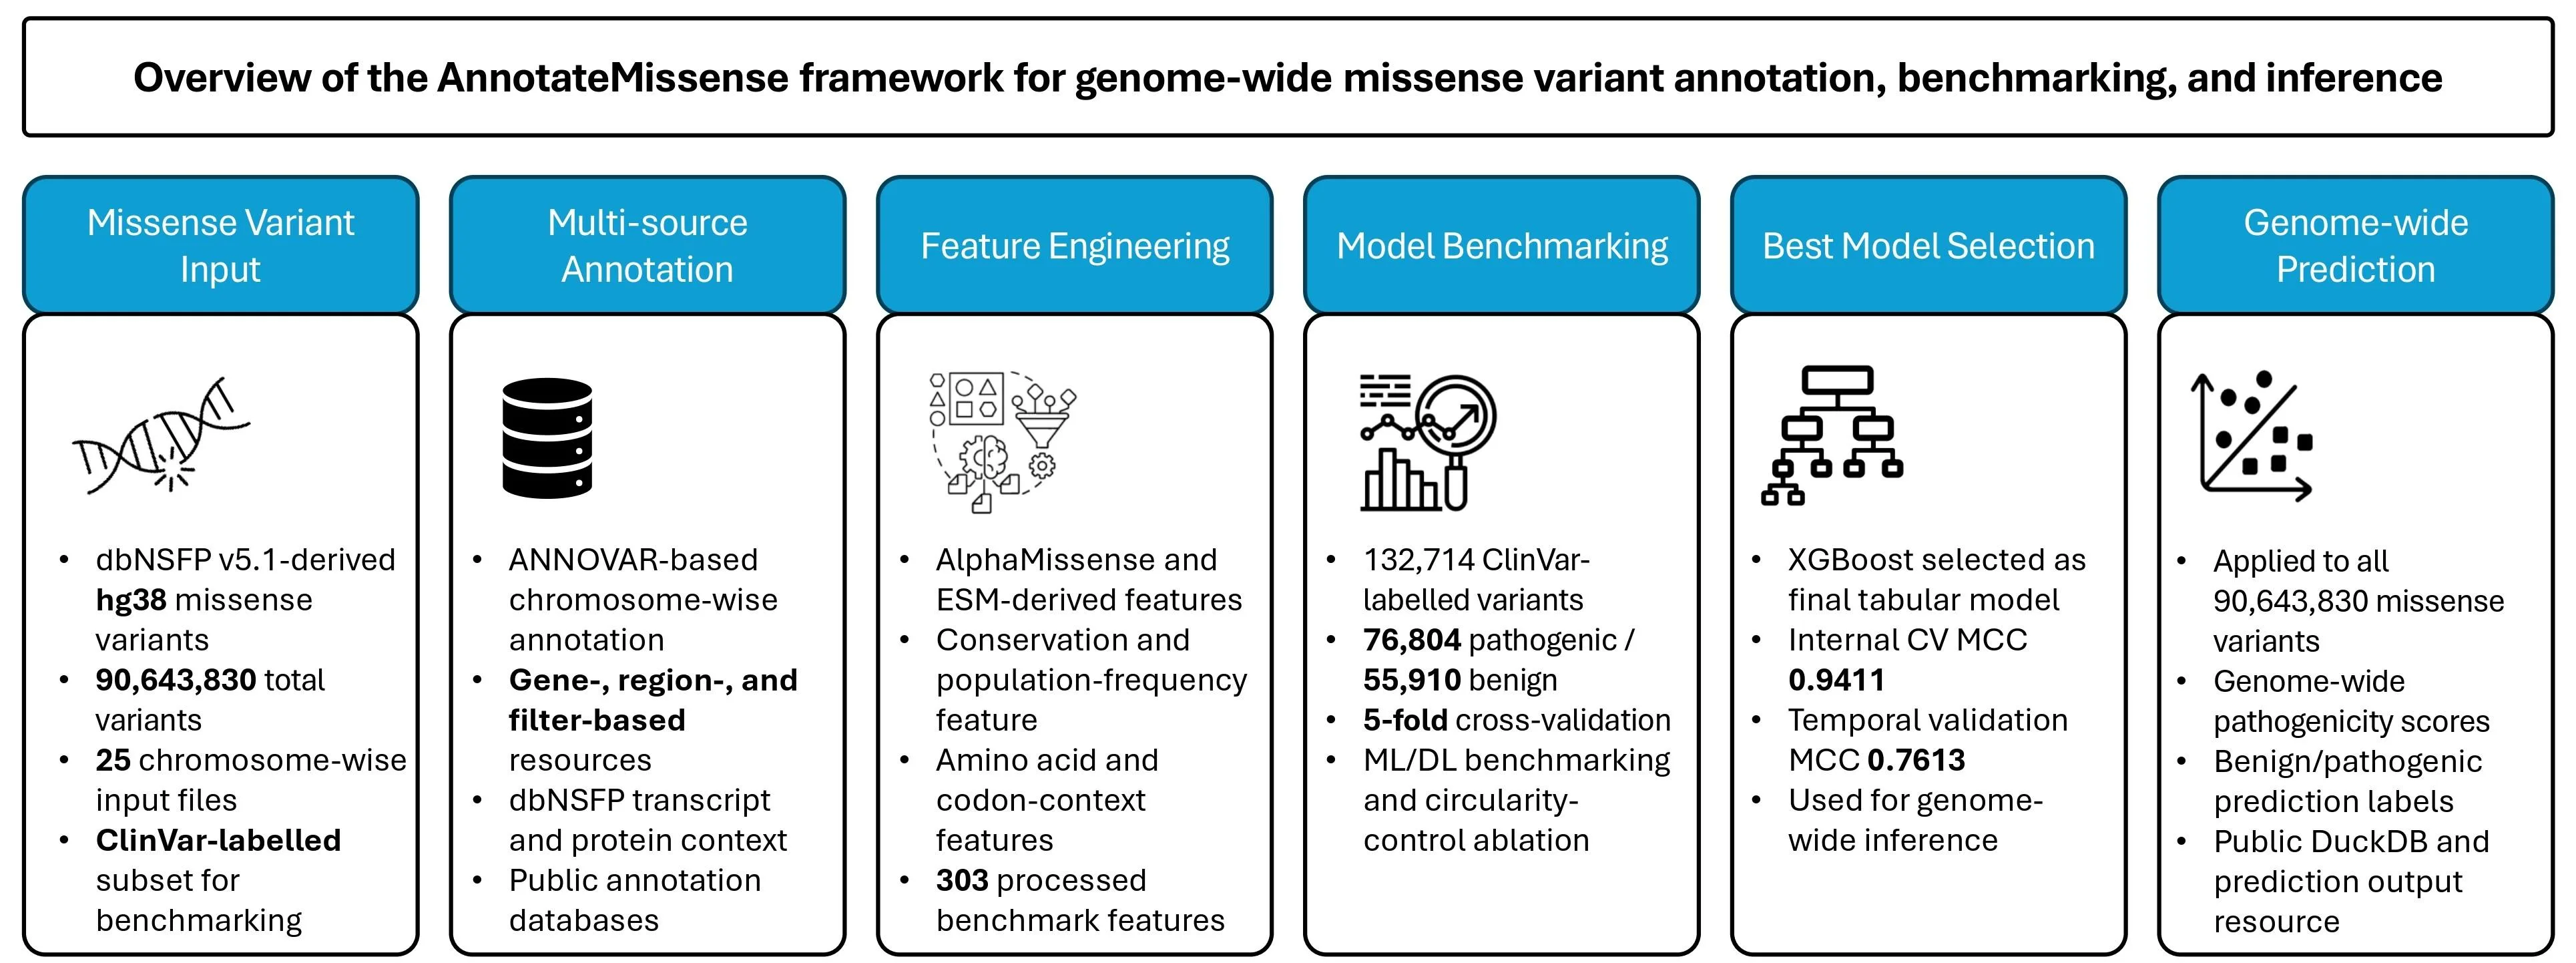
En una biblioteca enorme, donde cada libro es un gen, hay que encontrar una errata. El error puede ser inofensivo o puede cambiar por completo el sentido de la frase. Así, más o menos, los genetistas buscan mutaciones dañinas entre millones de diferencias inofensivas.
El programa, llamado AnnotateMissense, actúa como un corrector meticuloso. No solo observa la letra reemplazada, sino que reúne todas las pistas posibles: con qué frecuencia aparece ese cambio en personas sanas, cuánto cambia la forma de la proteína, qué dicen otros programas predictores e incluso cómo es la «caligrafía» de la evolución — si esa región se ha mantenido igual en distintas especies. En total, se reunieron 303 pistas.
Lo más interesante ocurrió cuando empezaron a quitarle pistas al programa. Sin los datos sobre la frecuencia de la mutación en la población y sin las pistas de otros predictores, la precisión caía en picada — como si el corrector hubiera perdido el diccionario y la gramática. En cambio, eliminar las evaluaciones de moda de los modelos de lenguaje de proteínas casi no afectó el resultado. La versión final se probó con datos nuevos, que aparecieron después del entrenamiento: la precisión se mantuvo alta, un 88%. Tras eso, el programa escaneó todo el genoma humano y asignó puntuaciones de peligro a 90 millones de mutaciones.
Resumen original
tal como lo escribieron los autores, en inglés arXiv:2605.24520
Missense variant interpretation remains challenging because pathogenicity depends on heterogeneous evidence from population frequency, evolutionary conservation, transcript context, amino acid substitution severity, prior pathogenicity predictors and protein-language-model-derived features. We present AnnotateMissense, a scalable annotation, benchmarking and genome-wide prediction framework for missense variant interpretation. AnnotateMissense integrates hg38 missense variants derived from dbNSFP v5.1 with ANNOVAR annotations, dbNSFP transcript/protein descriptors, AlphaMissense scores, ESM-derived features, conservation metrics, population-frequency variables, established pathogenicity predictors and engineered amino acid/codon-context features. Using 132,714 ClinVar-labelled missense variants, we benchmarked machine-learning and deep-learning models under controlled feature configurations. The full 303-feature benchmark set achieved the strongest performance with XGBoost, reaching mean MCC = 0.9411 and ROC-AUC = 0.9950 across stratified five-fold cross-validation. Restricted naive and location-oriented feature sets achieved lower best MCC values of 0.4989 and 0.5113, respectively. Circularity-controlled ablations showed that removing prior-predictor, population-frequency and clinically overlapping evidence reduced performance, whereas excluding AlphaMissense and ESM-derived features alone had minimal effect. Temporal ClinVar validation on newly observed pathogenic/benign variants achieved MCC = 0.7613, accuracy = 0.8798 and F1-score = 0.8750. The final model was applied to 90,643,830 hg38 missense variants to generate AnnotateMissense pathogenicity scores and binary prediction labels. Code and outputs are available at https://github.com/MuhammadMuneeb007/CAGI7_Annotate_All_Missense and https://doi.org/10.5281/zenodo.19981867.
La palabra «missense» en el nombre significa que la mutación cambia un solo aminoácido en la proteína — como cambiar una letra en una palabra. Pero incluso algo tan pequeño puede convertir «casa» en «caza».
En la película «Gattaca», la sociedad se dividía entre «válidos» e «inválidos» según un pronóstico genético — programas como este acercan un poco más ese escenario a la realidad.