Una división que no fragmenta la memoria exprés
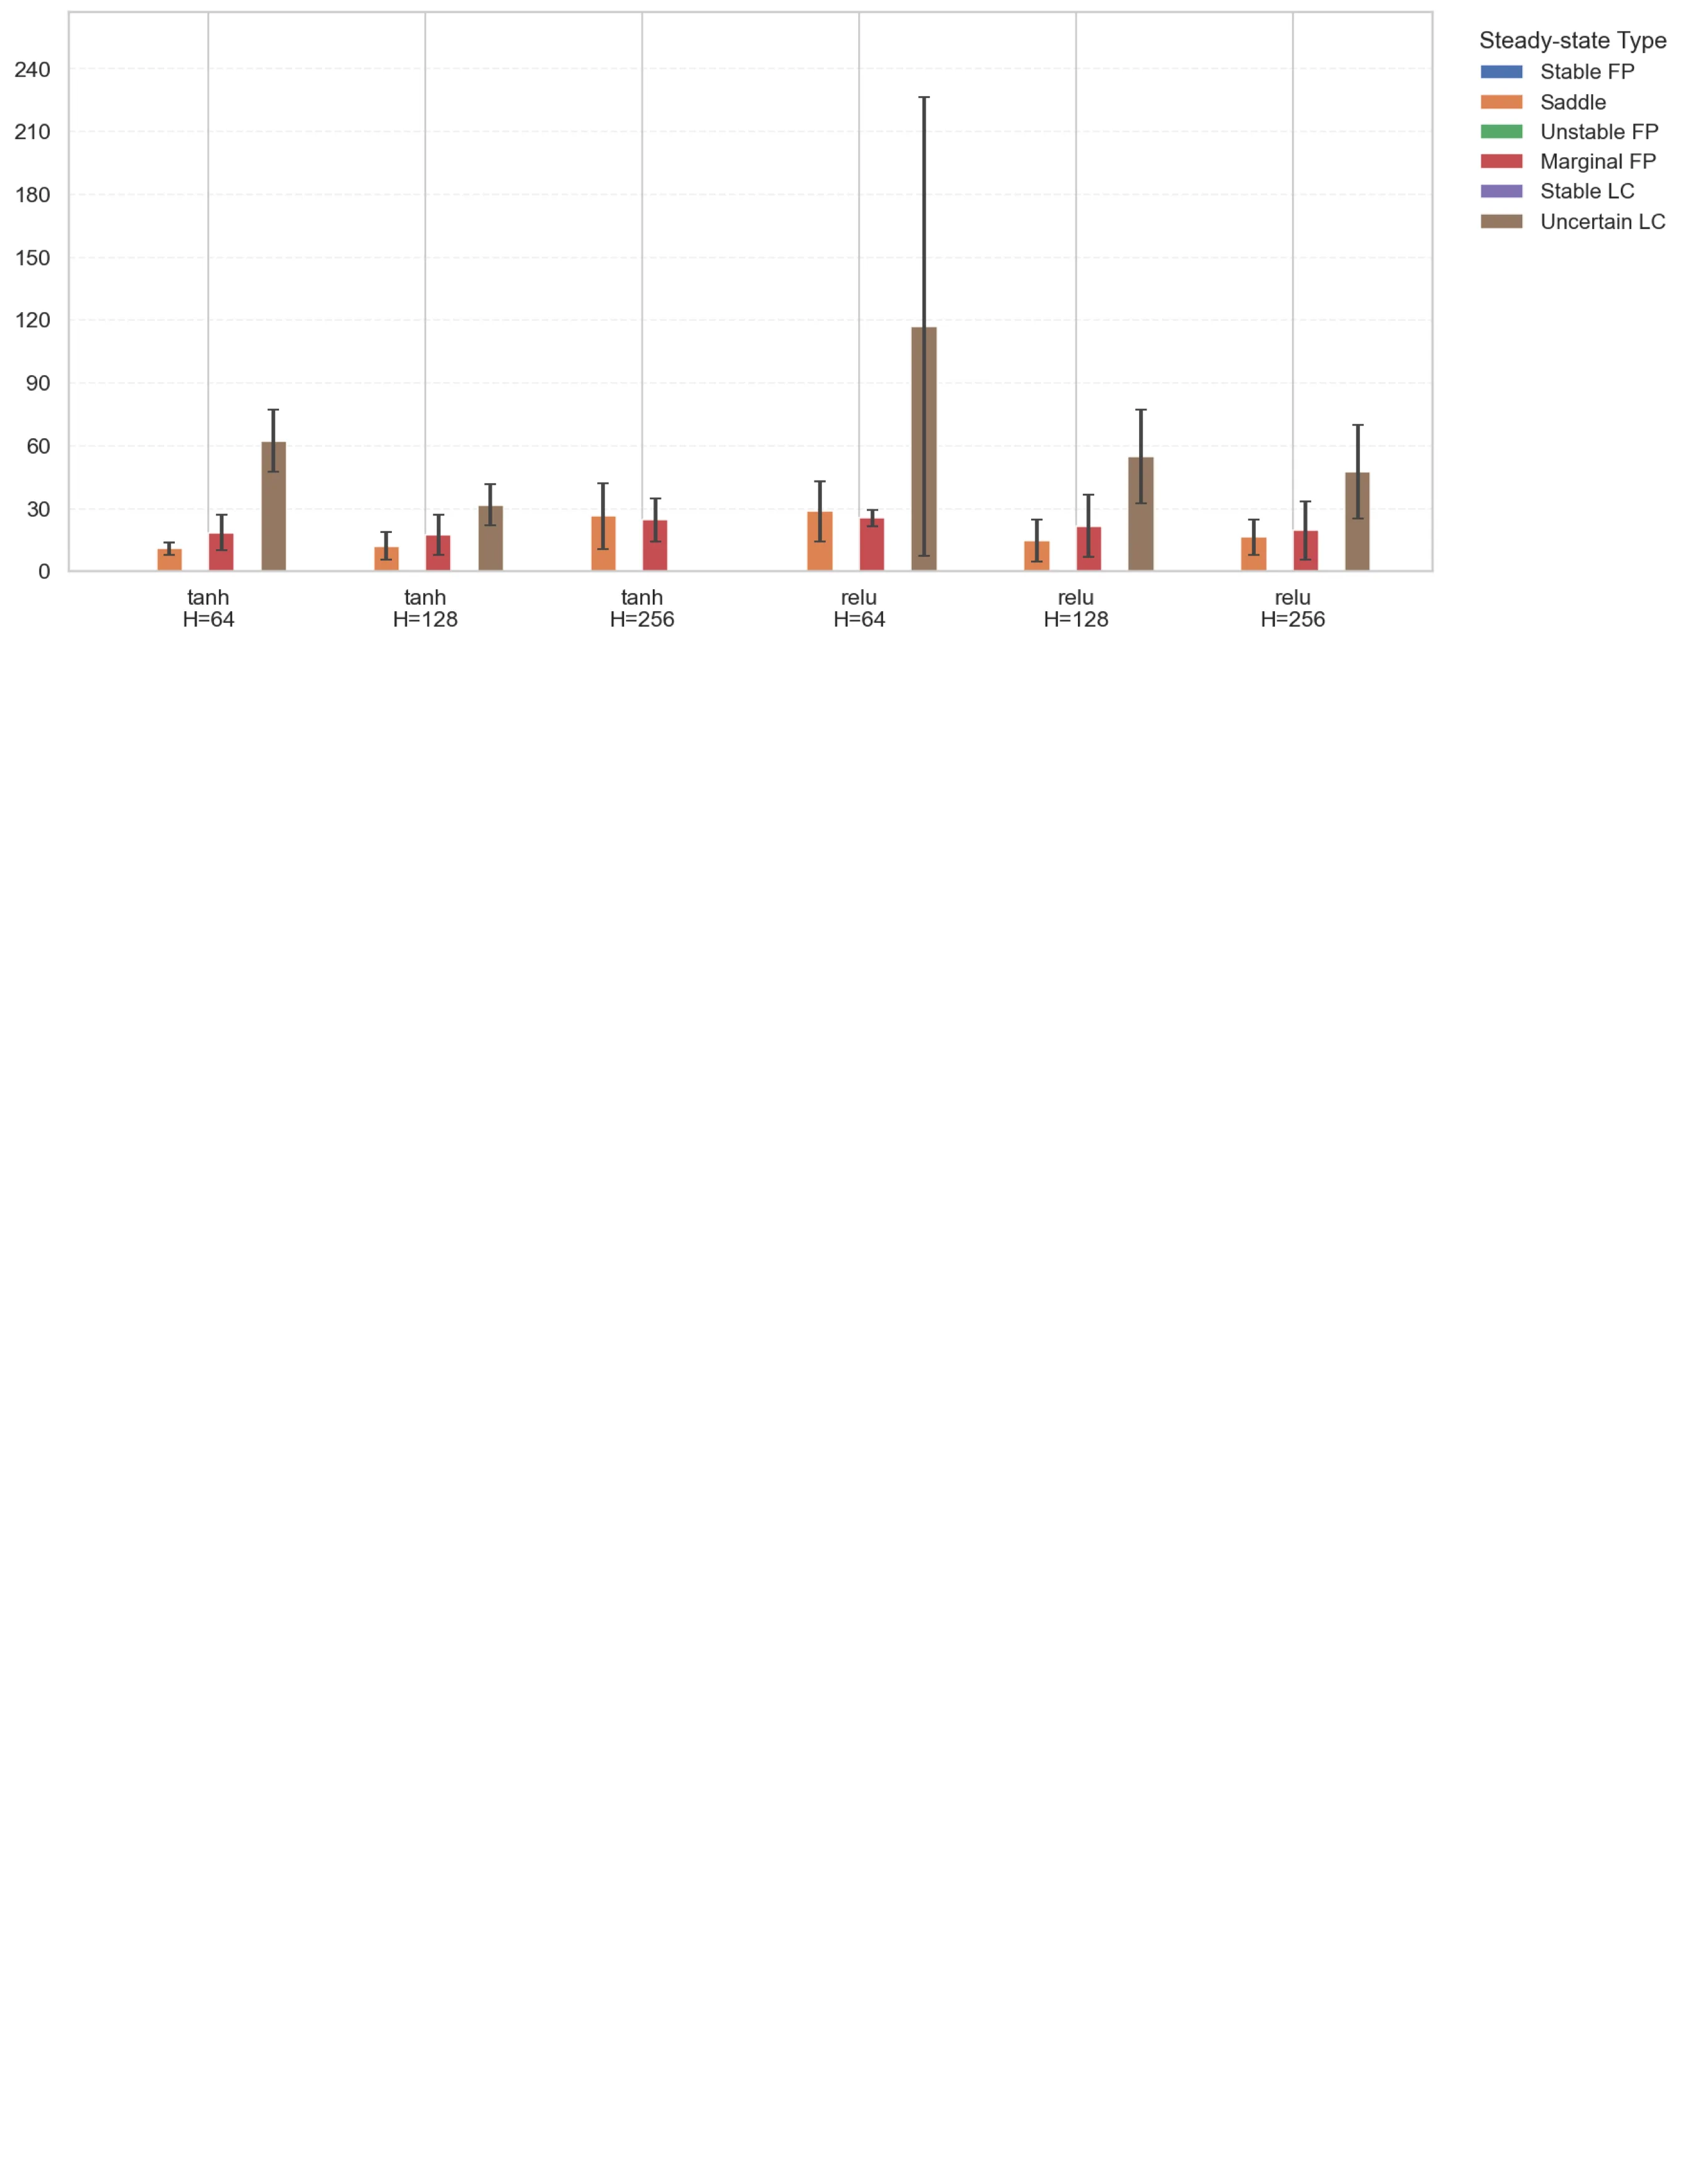
Mantener en la cabeza la posición exacta de un lápiz mientras se mueve lentamente es una tarea rutinaria para el cerebro. Para las redes neuronales artificiales, es casi imposible. Las redes recurrentes típicas, como GRU y LSTM, tienden a dividir el movimiento continuo en escalones rígidos: el lápiz no se desliza suavemente, sino que salta de un punto a otro. La red parece recordar no una línea, sino varios fotogramas sueltos.
Un grupo de investigadores propuso una red con división: la Recurrent Divisive Normalization Network (RDNN). Su secreto no está en restar señales inhibitorias, sino en dividirlas. Cuando una neurona está activa, no solo amortigua a la vecina, sino que reduce su salida de forma proporcional. Esto recuerda al control de volumen: si hay ruido en una habitación, no restamos el ruido del habla, sino que dividimos: hablamos más alto en relación con el fondo. Este mecanismo está muy extendido en la corteza cerebral, pero en las redes artificiales casi no se usa.
El análisis matemático mostró que la división crea en la red una variedad lenta: una senda suave por la que el estado de la memoria puede cambiar sin saltos. Cuando la red se entrena con retropropagación del error, la división escala automáticamente los pasos de aprendizaje: en las zonas muy activas, la actualización de parámetros se atenúa. Esto comprime el rango efectivo de la red: la dinámica se encoge por sí sola en un cauce estrecho de baja dimensión, evitando el sobreajuste y el caos.
En experimentos con tareas de memoria de trabajo, RDNN retuvo señales continuas con una precisión decenas de veces mayor que las redes convencionales. Y cuando se sustituyó la división por la resta, la red comenzó de inmediato a fragmentar la señal suave en escalones. Parece que la biología no eligió este mecanismo por casualidad: la división resultó matemáticamente necesaria para almacenar magnitudes continuas en un mundo cambiante.
Resumen original
tal como lo escribieron los autores, en inglés arXiv:2608.01947v1
The ability to robustly maintain and update continuous variables is a hallmark of working memory. While classical continuous attractor networks suffer from severe fine-tuning fragility, standard artificial recurrent neural networks (RNNs) like GRUs and LSTMs typically fail to stably learn continuous manifolds, instead shattering the state space into discretized point attractors. To bridge this gap, we draw inspiration from divisive normalization, a canonical neural computation widely observed across cortical circuits, and propose the Recurrent Divisive Normalization Network (RDNN), a minimal and algebraically isolated model of dynamic division. Through dynamical systems analysis on canonical working memory tasks, we demonstrate that this biophysical constraint allows the network to converge to robust, high-fidelity slow manifolds. Furthermore, we analyze the gradient dynamics of divisive normalization during Backpropagation Through Time (BPTT), showing that it introduces an activity-dependent local gradient scaling. This scaling dampens parameter updates in highly active regimes, which empirically aligns with a significant self-compression of the network's effective rank, confining the recurrent dynamics to a tight, low-dimensional subspace while avoiding the optimization pathologies associated with explicit low-rank factorization. Finally, ablations demonstrate that while subtractive inhibition can maintain static memories, divisive normalization is mathematically essential to prevent manifold shattering under time-varying inputs. Our findings identify divisive normalization not merely as a biological artifact, but as a critical computational mechanism for learning high-fidelity continuous representations.
La división de señales en las neuronas se describió por primera vez en la corteza visual: así el cerebro no se deslumbra con la luz brillante, sino que simplemente reduce la sensibilidad: divide, no resta.