El sobreajuste ocurre cuando un modelo estadístico describe el error aleatorio o el ruido en lugar de la relación subyacente. El modelo funciona bien con los datos de entrenamiento, pero mal con datos nuevos no vistos. Este es un problema central en el aprendizaje automático y la estadística, ya que el objetivo es construir modelos que generalicen, no que memoricen.
Historia
El concepto se conoce desde los primeros días de la estadística y el ajuste de curvas. El término 'sobreajuste' se hizo prominente en las décadas de 1960 y 1970 con el auge de las redes neuronales y los árboles de decisión.
Cómo funciona
Los modelos con alta flexibilidad (por ejemplo, muchos parámetros) pueden ajustar los datos de entrenamiento casi perfectamente, incluyendo sus peculiaridades. Cuando el modelo es demasiado complejo en relación con la cantidad de datos, captura patrones espurios que no existen en la población real. Esto conduce a una alta varianza: pequeños cambios en el conjunto de entrenamiento provocan grandes cambios en el modelo. Técnicas como la validación cruzada, la regularización y la poda se utilizan para detectar y prevenir el sobreajuste.
En la práctica
En el modelado predictivo, el sobreajuste es una preocupación constante. Los profesionales utilizan conjuntos de validación y regularización para asegurar que modelos como los de puntuación de crédito o pronóstico médico sigan siendo fiables con nuevos pacientes.
Dato curioso
Un modelo que memoriza perfectamente los datos de entrenamiento (por ejemplo, una tabla de consulta) tiene un error de entrenamiento cero, pero normalmente no se desempeña mejor que una suposición aleatoria con datos nuevos: un ejemplo clásico de sobreajuste.
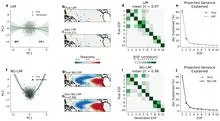
Un mapa del tesoro dibujado por una red neuronal promete mostrar dónde está enterrado el oro. Pero si trasladas el mapa a otra isla, las marcas pueden apuntar al vacío. Esto es precisamente lo que ocurrió con las explicaciones del modelo que estima el pulso a partir de grabaciones de video del rostro.
La red neuronal RhythmFormer capta cambios sutiles en el color de la piel causados por los latidos del corazón.
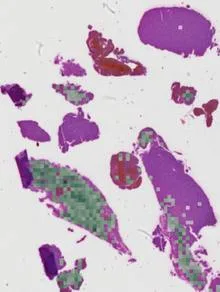
Imagina que intentas averiguar qué ocurrió en una habitación por el sonido que queda después de un disparo. El disparo ya no está, pero el eco aún resuena en las paredes. Así, aproximadamente, un neuropatólogo observa un corte de tejido cerebral en el que no aparece el tumor: la biopsia solo ha tomado tejido sano que ha reaccionado a la enfermedad.
Dos corredores parten en una pista con pendiente variable. Uno sale antes, el otro después, y el juez mide sus velocidades sin saber que hubo diferencia en la salida. Algo parecido ocurre con las variantes del virus: los datos llegan con retraso, y si esos retrasos no son iguales, la estimación de la ventaja competitiva puede ser gravemente errónea.
En el almacén hay cajas con manzanas y peras. Hay muchas manzanas y pocas peras. Pero cuando el encargado dice «fruta con piel lisa», por alguna razón recordamos más a menudo la rara pera que la frecuente manzana. Eso es el efecto de la tasa base inversa: un fallo persistente en cómo el cerebro resuelve la ambigüedad entre categorías.
Cien mil estrellas en el denso núcleo de un cúmulo globular se mueven como bolas de acero en una gigantesca máquina de pinball. Cada «empujón» —un encuentro gravitacional entre un sistema binario y una estrella solitaria— desencadena una cascada de eventos impredecibles.
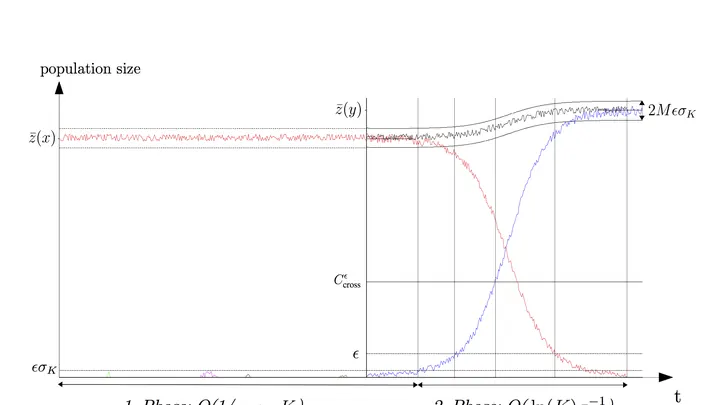
La evolución fluye como el agua. En un río ancho los cambios son suaves y lentos, mientras que un arroyo de montaña bulle con cada piedra. El tamaño de la población y la frecuencia de las mutaciones determinan el cauce: ancho y tranquilo o estrecho y lleno de rápidos.
El aprendizaje automático hace tiempo que dejó de ser una simple herramienta: se está convirtiendo en un investigador que extrae por sí mismo las leyes de la naturaleza de los datos. Pero, ¿cómo llega la mente de silicio a la comprensión?
Las señales gravitacionales de estrellas masivas moribundas son susurros que nos llegan desde los laboratorios más violentos del Universo. Einstein predijo estas ondas gravitacionales hace más de un siglo, pero solo hoy, con detectores como LIGO, comenzamos a escucharlas.
60 ratones, 1980 muestras, 234 pacientes con cáncer de pulmón. Detrás de cada número hay miles de genes. Su actividad se mide para entender la enfermedad. Pero los datos no son homogéneos: de un paciente se evalúa el nivel de proteína (número continuo), se le asigna un diagnóstico (sí/no) y se determina el subtipo de tumor (categoría).
Los modelos estadísticos son un intento de tender una telaraña matemática perfecta sobre el paisaje irregular de los datos. Cuando el modelo se resiste, emite tensión, pero nos hemos acostumbrado a ignorarla. Los investigadores pasan horas escudriñando gráficos de residuos, tratando de adivinar dónde el modelo «cruje por las costuras». Squealer traduce esa resistencia en sonido.
Un estudiante que durante años resolvió problemas de libros ajenos recibe de repente tres cuadernos con observaciones reales del océano. Hay pocos problemas, pero ya ha visto cientos de similares, y ahora le bastan un par de ejemplos para captar el estilo del nuevo maestro.
En un estadio de fútbol, las emociones de la multitud se componen de las conversaciones de cada aficionado. Si el ánimo pudiera ser alegre y triste a la vez, surgiría una superposición cuántica. Pero el murmullo de miles de voces transforma al instante esa mezcla en un único estado definido.
Entrenar un modelo aerodinámico preciso se asemeja al arte culinario: primero el chef domina cientos de recetas para captar los principios generales, y luego perfecciona fácilmente un plato concreto. Los ingenieros crearon AeroTransformer y le «alimentaron» con 30 mil formas diferentes de alas: toda una galaxia de ideas culinarias galaxia.
El núcleo de uranio se asemeja a una cartera apretada, cerrada con dos mitades. Para que reviente y libere energía —es decir, para que el núcleo se divida— hay que superar una barrera energética. La altura de ese umbral determina si la materia es estable o está lista para desintegrarse en cualquier momento.
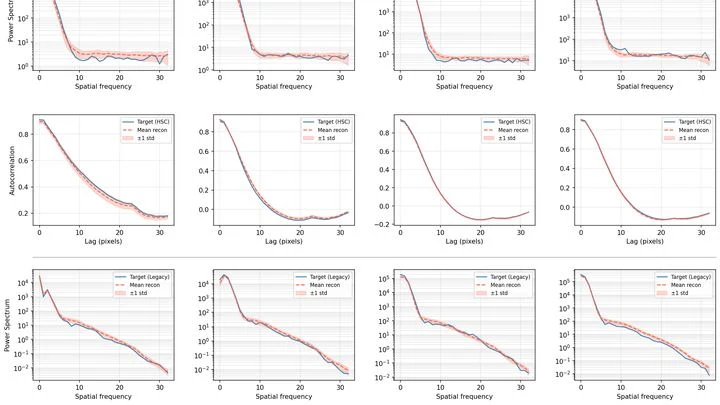
Si fotografiamos la misma montaña con una cámara de película y con un smartphone moderno, obtenemos imágenes diferentes: en una los colores son más vivos, en la otra los detalles aparecen borrosos.
Una computadora cuántica se parece a una orquesta donde cada músico toca su parte. Si el director falla, la música se desmorona. En las simulaciones cuánticas digitales, el papel del director lo desempeña una secuencia de operaciones simples, y los errores se acumulan como notas falsas. Pero a veces la orquesta suena limpia, incluso si el director no es perfecto.
El flujo turbulento del agua en una tubería y las oscilaciones de un péndulo parecen no tener nada en común. Pero en su interior comparten algo: ambos obedecen a sus propias leyes de movimiento que pueden describirse con números. Una red neuronal entrenada solo con una de estas «danzas» de números, de repente empieza a comprender la otra, sin un solo ejemplo adicional.
Una red neuronal se puede comparar con una residencia estudiantil donde cada residente tiene su propia habitación. Normalmente, cada característica de los datos ocupa una neurona separada, y el aprendizaje se realiza de forma secuencial: primero una característica, luego otra. Esto es lento y depende de los datos específicos que se encuentren.