Le ciel radio sur les épaules des bénévoles : comment la science citoyenne apprend à l'IA à voir les galaxies complexes ✛
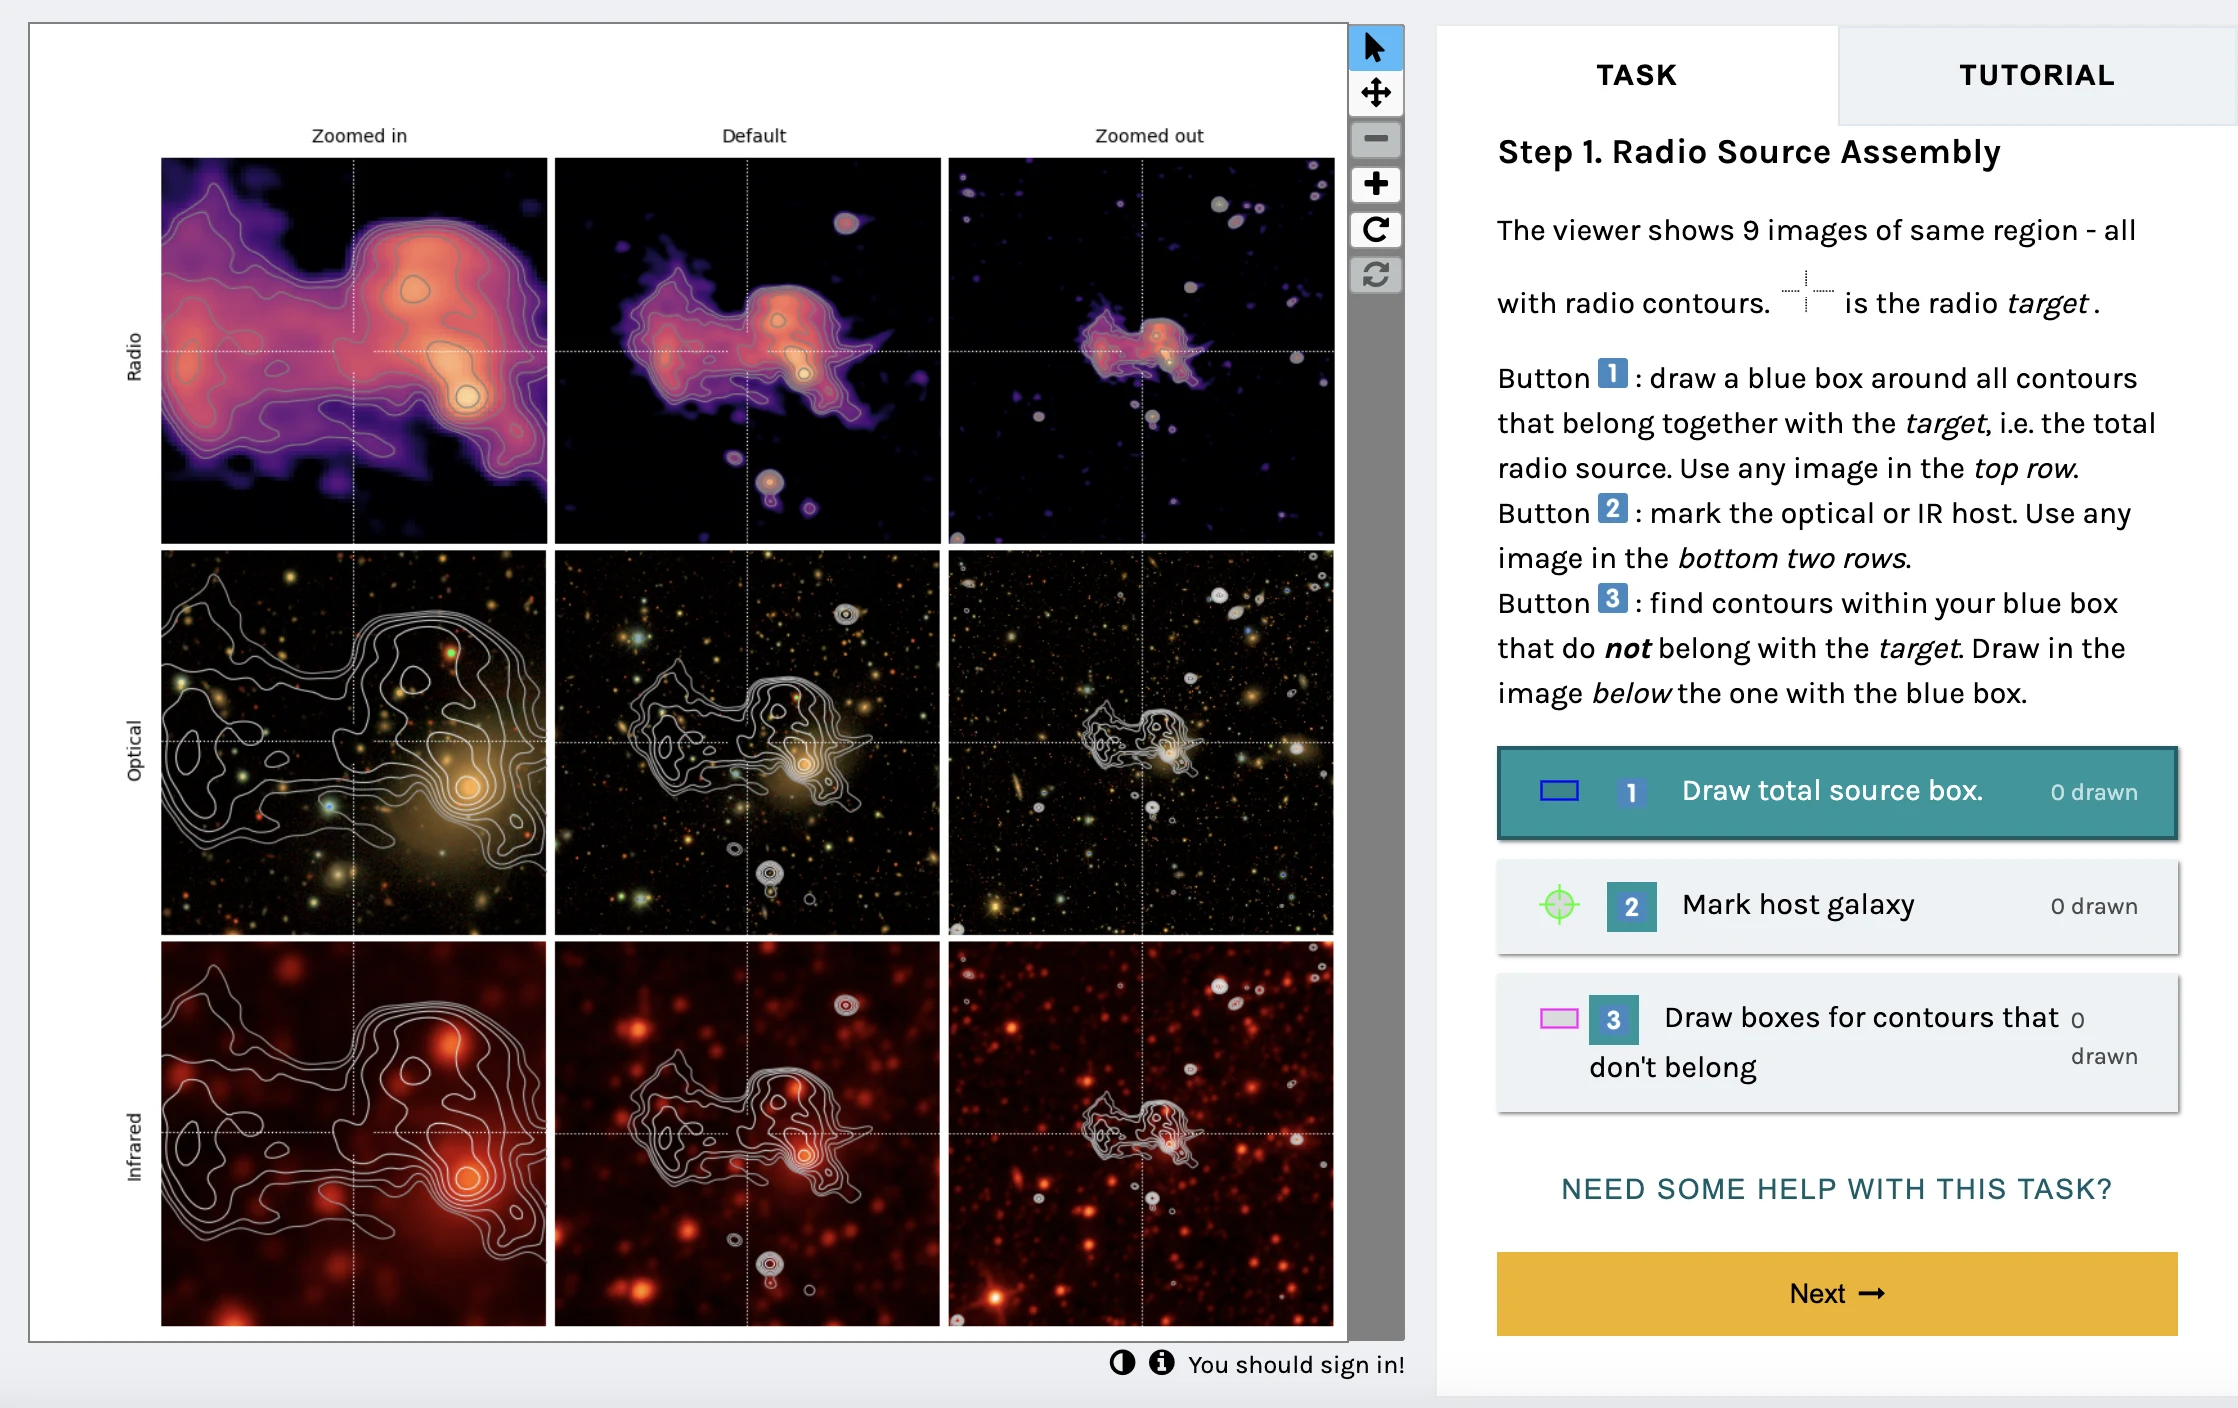
Le télescope ASKAP collecte en une seule nuit des données sur des millions de sources radio. Les algorithmes automatiques reconnaissent avec assurance les points compacts, mais butent sur les structures étendues avec leurs jets, ponts et bulles. Les bénévoles sont venus à la rescousse : lors de la première phase du projet Radio Galaxy Zoo EMU, plus de 2500 personnes ont réalisé 97 000 classifications de 6230 objets complexes.
La sélection repose sur la mesure de Kolmogorov : plus une image se compresse mal, plus sa structure interne est riche. On y ajoute la taille angulaire, afin que les bénévoles reçoivent les objets les plus intéressants et les plus grands. Sur la plateforme Zooniverse, les volontaires identifient les composantes liées, trouvent les galaxies hôtes et attribuent des étiquettes simples comme « sablier », « courbé », « traces de la galaxie hôte ». Ces étiquettes sont nées d'une taxonomie sémantique : d'abord, 22 traits morphologiques ont été extraits des descriptions, puis réduits à un ensemble d'environ dix libellés intuitifs. Il en résulte un vocabulaire commun, compréhensible par l'humain et par l'algorithme.
L'approche hybride apporte ce qui manquait aux projets voisins : des annotations de référence pour l'entraînement de modèles profonds. Auparavant, les algorithmes automatiques ne pouvaient pas reconnaître de manière fiable les morphologies rares, et les annotations d'experts manquaient. Désormais, un corpus annoté de 6230 sources étendues, avec des étiquettes fournies par des milliers de bénévoles, est disponible. Il peut être réutilisé à de multiples reprises et pour différentes tâches : de l'amélioration du catalogue EMUCAT à la préparation du Square Kilometre Array.
Au cours des cinq prochaines années, le projet s'étendra à l'ensemble du relevé EMU et couvrira environ quatre millions de sources étendues. L'apprentissage actif bouclera la boucle : les modèles proposeront les objets les plus informatifs à étiqueter, et les nouvelles annotations amélioreront les modèles. Ce cycle deviendra un banc d'essai pour une IA fiable avant le lancement du SKA, où les volumes de données augmenteront de plusieurs ordres de grandeur. Les bénévoles, qui ont commencé avec des étiquettes simples, se retrouveront co-auteurs d'un outil qui, un jour, fonctionnera en autonomie.
L'une des étiquettes de classification est « sablier » : c'est ainsi que l'on voit les radiogalaxies à deux lobes symétriques, évoquant la figure qui servait à mesurer le temps dans l'Antiquité.