Le ciel radio porté par des bénévoles : comment la science citoyenne apprend à l'IA à voir les galaxies complexes ✛
Contexte
La nouvelle génération de radiotélescopes à grand champ, comme ASKAP, collecte en une seule nuit des données sur des millions de sources. Les algorithmes automatiques gèrent bien les objets compacts, mais échouent face aux structures étendues à la morphologie singulière : jets, ponts, bulles. Autour de ce problème s'est déjà développé tout un domaine : certains groupes cherchent des signaux radio d'origine technologique, d'autres construisent des cartes de centaines de milliers de galaxies à l'aide de réseaux de neurones, d'autres encore capturent la lueur fantomatique aux abords des amas. Le travail de RGZ EMU se tient en marge : il ne découvre pas de nouvelles sources, mais crée des annotations de référence sans lesquelles toutes ces cartes et ces recherches resteraient brutes.
Méthodes
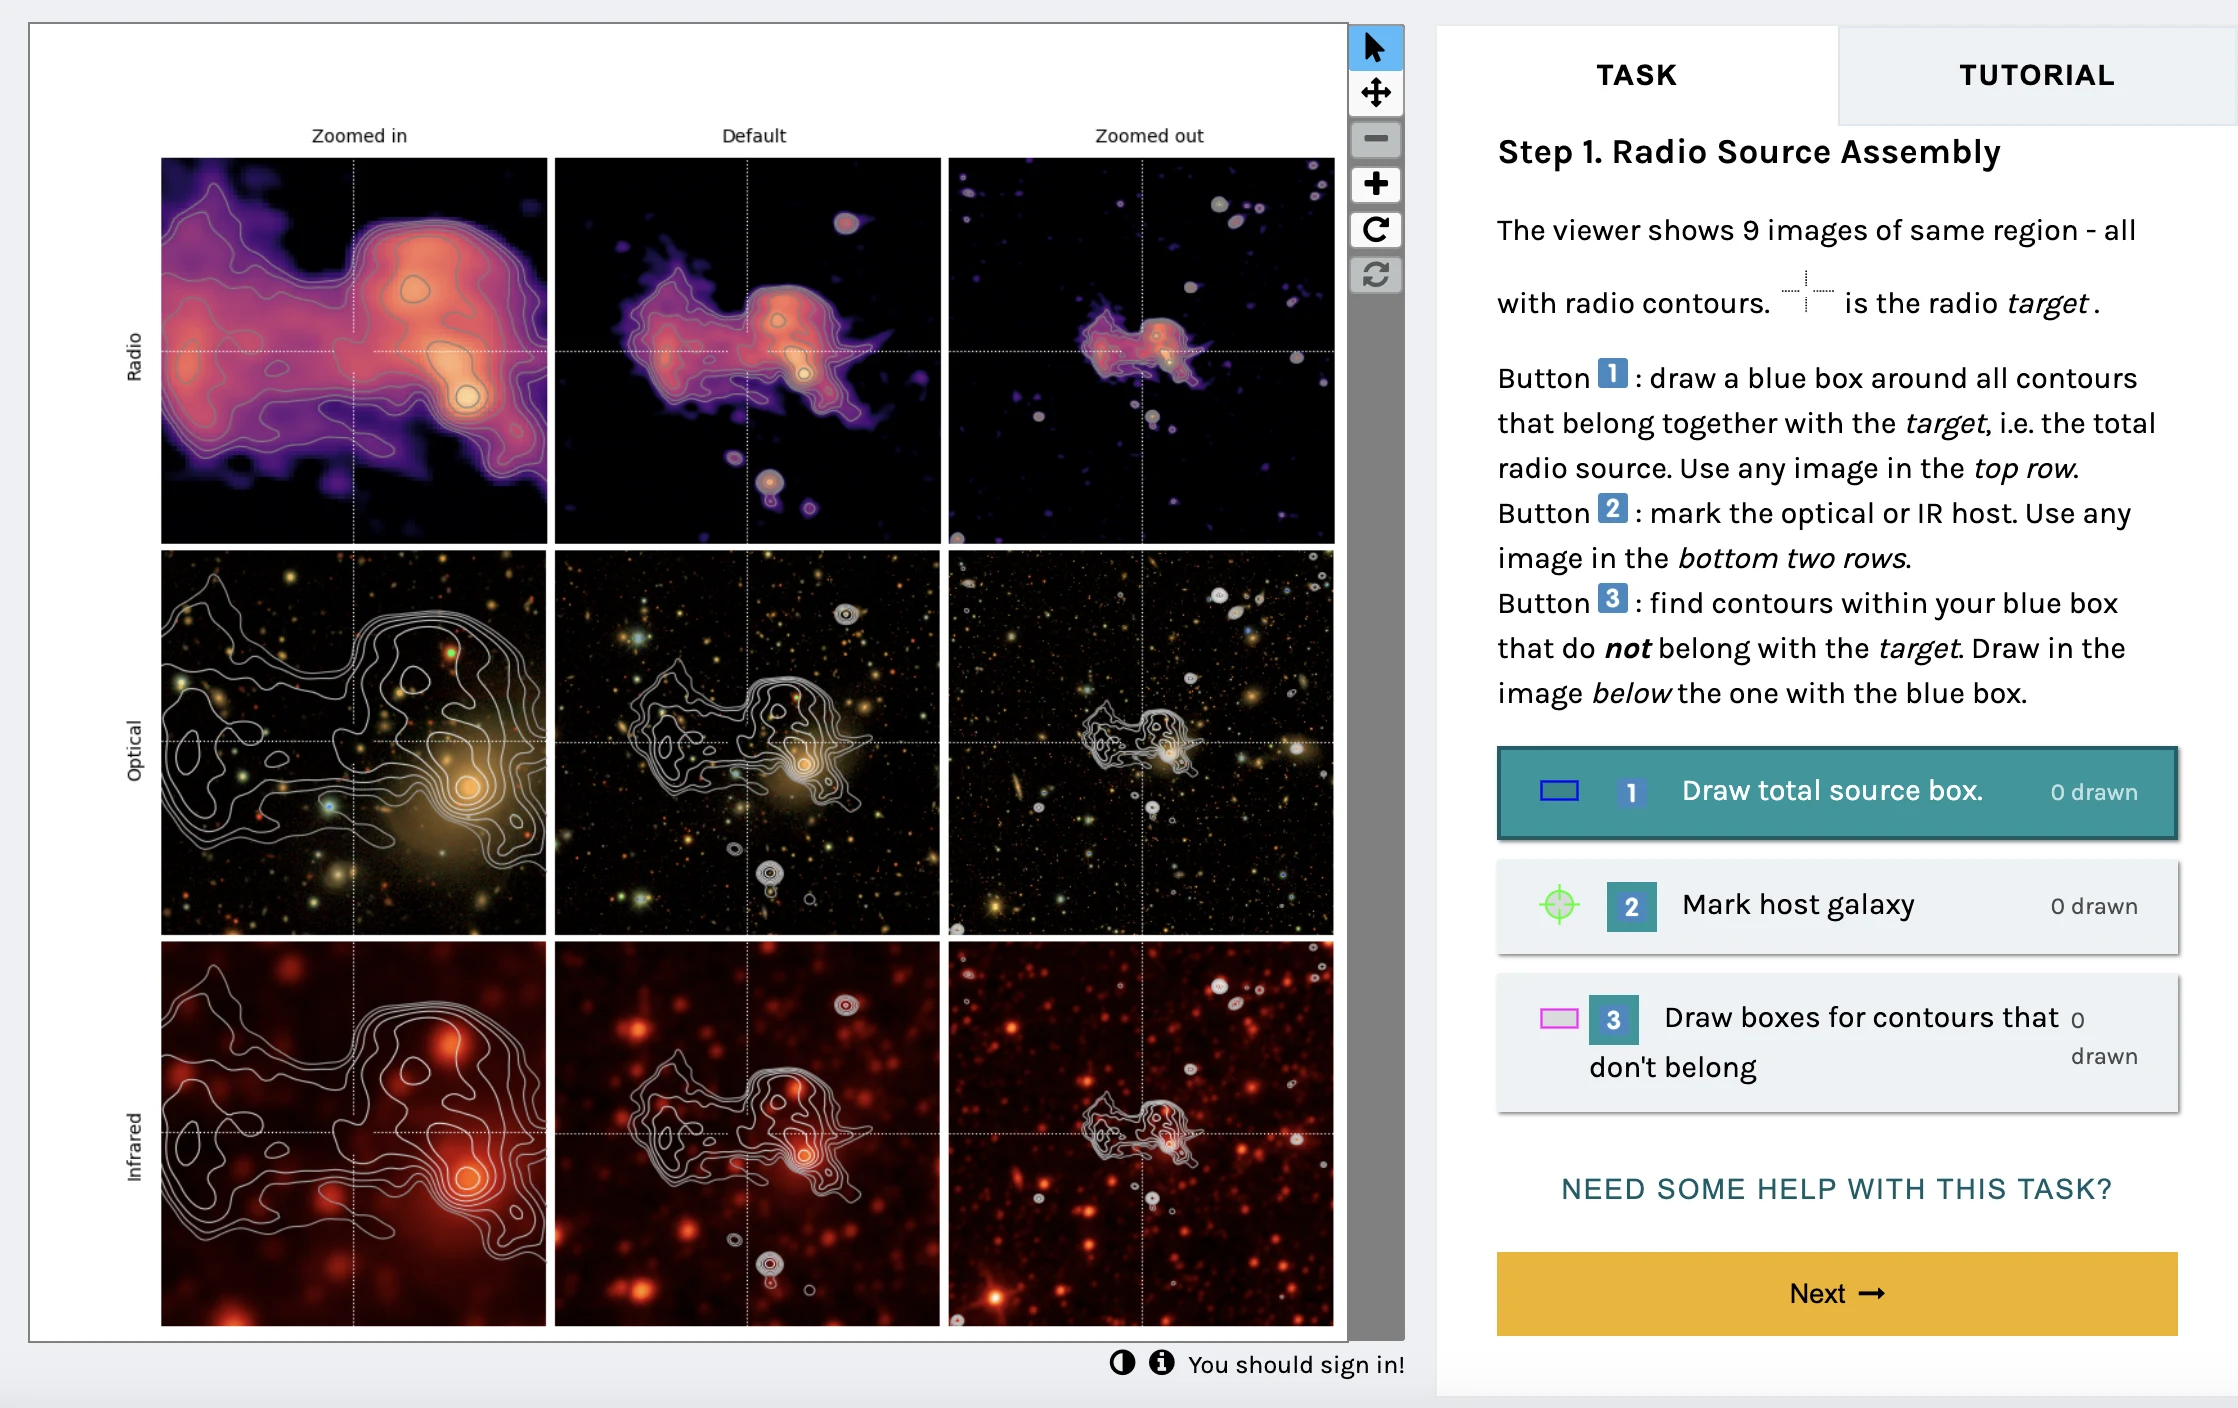
Au cœur du travail se trouve un pipeline hybride où l'humain et la machine se complètent. D'abord, on sélectionne dans le catalogue Selavy les sources à forte complexité morphologique : pour cela, on utilise une mesure grossière de Kolmogorov, qui évalue à quel point une image se compresse mal, c'est-à-dire à quel point sa structure interne est riche. Ensuite, on ajoute la taille angulaire à la complexité, afin que les volontaires reçoivent les objets les plus intéressants et les plus grands. Sur la plateforme Zooniverse, les bénévoles marquent les composantes radio liées, trouvent les galaxies hôtes et attribuent des étiquettes simples comme « sablier », « courbé », « traces de la galaxie hôte ». Ces étiquettes sont issues d'une taxonomie sémantique construite par des méthodes de traitement du langage naturel : d'abord, on a extrait 22 caractéristiques morphologiques des descriptions, puis on les a réduites à un ensemble d'environ dix étiquettes intuitives. Ainsi naît un vocabulaire commun, compréhensible par l'humain et par l'algorithme.
Résultats
Lors de la première phase, plus de 2500 bénévoles ont réalisé environ 97 000 classifications. Une analyse préliminaire montre que la précision collective des volontaires se rapproche du consensus des experts dès que l'on dispose d'un nombre suffisant de réponses indépendantes. Cela concorde avec les résultats antérieurs du projet Galaxy Zoo et confirme l'adéquation des « échantillons d'or » pour l'entraînement des modèles. Les sources rares et ambiguës sont particulièrement précieuses, car les pipelines automatiques y commettent plus d'erreurs. Le déploiement multilingue (grec, chinois, ourdou, japonais) souligne l'ouverture du projet et élargit le bassin de participants.
Implications
Ce travail fournit des annotations de référence pour l'entraînement de modèles profonds, ce qui manquait aux projets voisins qui s'appuyaient soit sur l'automatisation pure, soit sur des échantillons experts limités. La différence avec les plus proches voisins réside dans l'échelle et la systématicité : ici, on ne cherche pas de signaux extraterrestres et on ne construit pas de cartes avec un seul algorithme, mais on crée un corpus annoté, réutilisable à plusieurs reprises et pour différentes tâches. C'est le premier test de l'approche hybride sur les données réelles d'EMU, où la complexité des sources est plus élevée que dans les relevés précédents.
Développements futurs
Dans les cinq prochaines années, le projet s'étendra à l'ensemble du relevé EMU et couvrira environ quatre millions de sources étendues. L'apprentissage actif bouclera la boucle : les modèles proposeront les objets les plus informatifs à annoter, et les nouvelles annotations amélioreront les modèles. Un tel cycle deviendra un banc d'essai pour une IA fiable avant le lancement du Square Kilometre Array, où les volumes de données augmenteront de plusieurs ordres de grandeur.
Impact
Les résultats influenceront directement le catalogue EMUCAT et la préparation du SKA, ainsi que les recherches inter-longueurs d'onde avec les relevés POSSUM, WALLABY, PEGASUS et Euclid.
Prochaines étapes
Passage à l'échelle sur l'ensemble d'EMU, intégration de l'apprentissage actif et publication de la première version du catalogue avec classifications hybrides.
Problèmes ouverts clés
Pour la radioastronomie, la question reste ouverte de savoir comment reconnaître automatiquement les morphologies rares sans biais de l'échantillon d'entraînement. La science citoyenne offre un moyen de rassembler des exemples divers, mais ne résout pas le problème du biais : les bénévoles préfèrent eux aussi les objets brillants et inhabituels. La tâche à long terme est de comprendre où l'intuition humaine est irremplaçable et où l'algorithme la surpasse déjà.
Le regard de la machine du savoir
Cette section s'adresse à l'auteur du travail et à ses collègues. Les travaux voisins ont été trouvés par une recherche sémantique dans notre archive, et non par correspondance de mots. Nous n'évaluons pas : nous montrons le champ autour.
Ce que fait ce travail
L'article décrit le projet Radio Galaxy Zoo EMU : une annotation participative de 6230 sources radio complexes du relevé EMU, réalisée par 2500 bénévoles qui ont effectué environ 97 000 classifications. Un schéma hybride a été utilisé : une sélection automatique basée sur la complexité morphologique (mesure de Kolmogorov) et la taille angulaire, puis une annotation manuelle sur la plateforme Zooniverse avec des étiquettes issues d'une taxonomie sémantique construite par des méthodes de TALN. Le résultat sera un catalogue ouvert, EMUCAT, et des données d'entraînement pour les modèles préparant l'ère du SKA.
Où est sa force
La force de ce travail réside dans la création d'un corpus de référence annoté pour les sources radio étendues complexes, obtenu grâce à un vocabulaire d'étiquettes cohérent, compréhensible à la fois par les humains et les algorithmes. L'ampleur et la systématicité de l'approche fournissent une base pour l'apprentissage de modèles profonds là où les pipelines automatiques échouent souvent.
Vers où avancer
- Il pourrait être intéressant de comparer les annotations obtenues avec les résultats de la classification automatique décrite dans un article où un réseau de neurones, sans indications, découvre de nouvelles galaxies : cela permettrait d'évaluer dans quelle mesure les modèles entraînés sur les données RGZ EMU améliorent la détection de morphologies rares.appui : Un réseau de neurones découvre de nouvelles galaxies sans aide arXiv:2511.05439
- Un article voisin présente un réseau de neurones qui a cartographié 639 000 galaxies : on pourrait essayer d'utiliser les sources annotées RGZ EMU comme ensemble d'entraînement supplémentaire pour améliorer la qualité des cartes des structures étendues.appui : Le réseau de neurones ZooBot:3D a cartographié la structure de 639 000 galaxies arXiv:2606.16507
- Dans les archives, une analyse complète explore qui se cache dans la lumière radio des galaxies : elle discute du lien entre morphologie et physique des sources, et vos étiquettes pourraient aider à interpréter ces liens pour l'échantillon EMU.appui : Cartographie radio de trois galaxies : sources compactes contre fond diffus arXiv:2507.23332
À essayer
- Vérifier dans quelle mesure les étiquettes de la taxonomie sémantique corrèlent avec les paramètres physiques des sources (par exemple, le redshift, la puissance), en utilisant le catalogue issu de l'analyse complète.
- Entraîner un modèle sur les annotations actuelles et comparer ses prédictions avec le consensus des bénévoles sur de nouvelles données, afin d'évaluer le gain de précision.
- Utiliser l'approche TALN pour étendre automatiquement la taxonomie à partir des descriptions de sources rares signalées par les bénévoles.
Pourquoi cela peut compter
Les annotations de référence des sources radio complexes sont cruciales pour se préparer au flux de données du SKA, où la vérification manuelle de chaque objet deviendra impossible. Le corpus ouvert RGZ EMU pourrait devenir une référence pour l'entraînement et la validation des algorithmes de classification, améliorant la fiabilité des catalogues automatiques et libérant les experts pour l'analyse des objets véritablement inhabituels.
Travaux voisins dans notre archive
- Le réseau de neurones ZooBot:3D a cartographié la structure de 639 000 galaxiesproximité 0.52
- Cinq mille géants sur la carte radio du cielproximité 0.51
- Sirènes gravitationnelles : où chercher la clé de l'univers sombreproximité 0.50
- L'Univers entraîné à prédireproximité 0.50
- La lumière des galaxies lointaines : comment distinguer les calmes des turbulentesproximité 0.50
- Un réseau de neurones découvre de nouvelles galaxies sans aideproximité 0.49
- Cartographie radio de trois galaxies : sources compactes contre fond diffusproximité 0.49
L'archive est vide autour de ce travail : l'analyse la plus proche n'est qu'à 0.52, contre 0,64 d'ordinaire. Il semble qu'on ait peu foré à côté.
L'une des étiquettes de classification est « sablier » : c'est ainsi que l'on voit les radiogalaxies à deux lobes symétriques, évoquant la figure qui servait à mesurer le temps dans l'Antiquité.
Chiffres clés
- nombre de classifications: 97 000
- nombre de bénévoles: plus de 2500
- taille de l'échantillon Phase I: 6230 sources étendues
- sensibilité du relevé EMU-PS: 25–30 μJy/faisceau
- résolution angulaire: 11–18 secondes d'arc