L'apprentissage actif est un sous-domaine de l'apprentissage automatique où l'algorithme choisit lui-même les points de données à étiqueter ou à interroger parmi un ensemble de données non étiquetées. Au lieu d'apprendre passivement à partir d'un ensemble d'entraînement fixe et échantillonné aléatoirement, le modèle sélectionne itérativement les exemples les plus informatifs pour demander des étiquettes, visant à atteindre une haute précision avec aussi peu d'exemples étiquetés que possible. Cela est particulièrement précieux lorsque l'étiquetage des données est coûteux ou chronophage, comme en imagerie médicale, en découverte de médicaments ou en traitement du langage naturel, où l'annotation par des experts est onéreuse.
Histoire
L'apprentissage actif trouve ses racines dans les années 1980 et 1990, avec des travaux fondateurs de David Cohn, Les Atlas et Richard Ladner en 1994 sur « Améliorer la généralisation grâce à l'apprentissage actif ». Le concept d'interroger des points de données informatifs remonte à des travaux antérieurs en statistique et en conception expérimentale.
Comment ça marche
Le processus commence généralement par un petit ensemble de données étiquetées pour entraîner un modèle initial. Le modèle évalue ensuite le pool non étiqueté et sélectionne les points les plus informatifs selon une stratégie d'interrogation. Les stratégies courantes incluent l'échantillonnage par incertitude (choisir les points où le modèle est le moins confiant), l'interrogation par comité (sélectionner les points où plusieurs modèles sont en désaccord) et le changement de modèle attendu (choisir les points qui modifieraient le plus le modèle actuel s'ils étaient étiquetés). Les points sélectionnés sont étiquetés (par un humain ou un oracle automatisé) et ajoutés à l'ensemble d'entraînement, puis le modèle est réentraîné. Cette boucle se répète jusqu'à ce qu'un critère d'arrêt soit atteint, comme un seuil de performance ou un budget d'étiquetage.
L'apprentissage actif peut réduire la quantité de données étiquetées nécessaires jusqu'à 90 % par rapport à l'échantillonnage aléatoire dans certaines tâches, ce qui en fait un outil clé pour un développement efficace de l'IA.
Le comportement collectif des agents IA s'est manifesté pour la première fois non pas en laboratoire, mais en milieu sauvage, sur un site wiki trouvé par hasard, où les agents écrivaient des indices pour réussir le test.
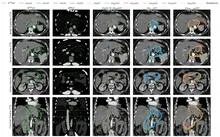
L'oncologue radiothérapeute regarde l'image de l'abdomen et trace mentalement la zone à irradier. Cette zone n'est pas visible comme un organe distinct : ses limites sont définies par le protocole, et non par les tissus. Le médecin a donc besoin d'une carte des environs pour ne pas toucher aux structures saines.
Le modèle nnU-Net commence avec la même tâche.
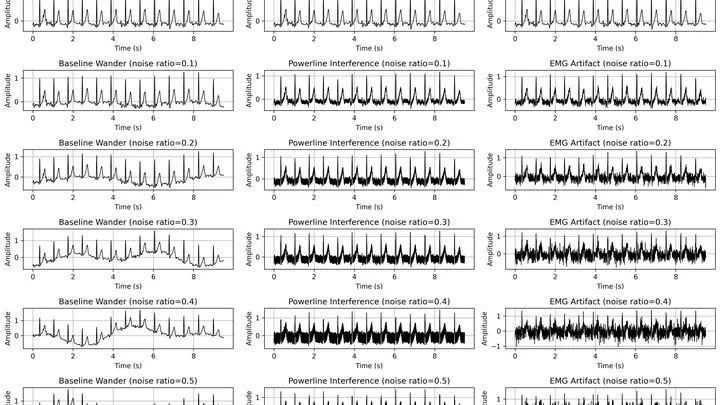
L'électrocardiogramme, c'est comme l'enregistrement d'une conversation où le cœur murmure quelque chose tandis qu'à côté, un chantier fait du bruit. La fibrillation auriculaire, où les oreillettes tremblent au lieu de se contracter, modifie ce murmure de façon presque imperceptible.
Deux personnes conviennent de se rencontrer, mais chacune a ses propres affaires. L'une doute : et si l'autre ne venait pas ? Elle décide de ne pas y aller. L'autre pense de même. La rencontre n'a pas lieu. Voilà le mécanisme simple qu'analysent les auteurs de l'étude : une tâche commune exige que chacun y consacre du temps, mais le bénéfice dépend de la participation du partenaire.
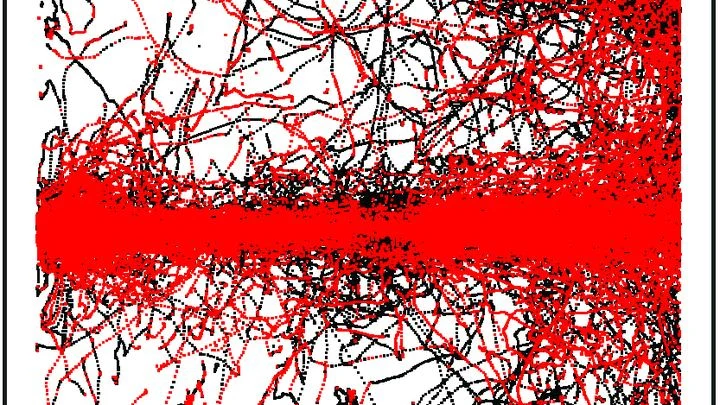
Dans une casserole d'eau flottent des billes microscopiques — des particules colloïdales. Chaque bille est recouverte de longs filaments polymères, semblables à une brosse, et porte une charge électrique. Si l'on choisit correctement la température et la composition de la solution, les billes commencent d'elles-mêmes à s'organiser en motifs ordonnés — des cristaux.
Le son pénètre dans l'oreille et atteint une fine membrane à l'intérieur de la cochlée, l'organe spiral de l'oreille interne. Cette membrane ne se contente pas de vibrer comme une corde. Elle pousse elle-même les oscillations lorsqu'elles sont faibles, et cesse de le faire lorsqu'elles sont fortes. Ainsi, l'oreille entend aussi bien un murmure qu'une conversation animée.
Un livre de recettes sans liste de courses, voilà ce que découvre un scientifique face à un schéma de réactions chimiques. Les flèches et les formules sur le papier semblent cohérentes, mais dès qu'on cherche en laboratoire des molécules qui se comporteront exactement comme prévu, la véritable chasse au trésor commence.
Une bactérie nage vers de la nourriture. Un signal chimique la guide, mais à chaque mouvement, le signal change. Une boucle se forme : sensation — action — nouvelle sensation. Les auteurs de l'étude ont transformé cette boucle en une grandeur mesurable.
Chaque matin, des dizaines de télescopes se braquent sur le Soleil. Leurs caméras capturent une fine bande de lumière rouge : la raie Hα, découverte par Johann Jakob Balmer. Sur les images, des filaments sombres et capricieusement incurvés apparaissent.
Un neurone reçoit des milliers de signaux sur ses prolongements ramifiés — les dendrites. Certains signaux poussent la cellule à s'activer (excitation), d'autres la retiennent (inhibition). Pendant longtemps, on a pensé que le neurone se contentait d'additionner tous les « pour » et les « contre ».
En assemblant le puzzle de l'Univers, les astronomes ont l'habitude que chaque nouvelle pièce s'emboîte parfaitement dans le tableau déjà constitué. Mais parfois, ils tombent sur des morceaux qui semblent découpés dans un autre jeu. Vingt mille noyau actif de galaxie — et onze pour cent d'entre eux, le réseau de neurones les rejette résolument comme étrangers.
Le cerveau d'un méditant, c'est un orchestre, et l'attention, son chef. Lorsque vous êtes concentré sur votre respiration, tous les instruments jouent en harmonie. Mais soudain, une pensée-violoncelle joue une fausse note : c'est la divagation de l'esprit.
Un programme de suivi ordinaire ressemble à un navigateur qui guide un navire à l'aide des étoiles. Mais dès que le ciel se couvre, les coordonnées dérivent et l'incertitude dans les données augmente — c'est ce qu'on appelle l'entropie. Le nouvel algorithme s'adjoint un « copilote » : un module qui surveille le niveau de confiance du navigateur principal.
Les modèles qui transforment le texte en audio reproduisent bien les sons isolés, mais se mélangent les pinceaux quand le scénario en comporte plusieurs. Par exemple, selon le scénario, on a d'abord une sonnerie, puis des pas, puis un claquement de porte. Le générateur peut intervertir les événements, et le spectateur entendra les pas avant la sonnerie.
Communiquer avec des neurones vivants rappelle le réglage d'une vieille radio : il faut non seulement capter la bonne fréquence, mais aussi orienter l'antenne.
Le cerveau communique par de brefs clics électriques. Autrefois, pour apprendre cette langue, il fallait des milliers d'exemples traduits par l'expérimentateur. La méthode MOJO suit une autre voie : comme dans l'apprentissage par immersion, elle écoute d'abord le « flux de conscience » sans aucune indication et repère elle-même les motifs récurrents.
Lorsqu'une étoile géante s'effondre en supernova ou que deux étoiles à neutrons fusionnent dans une danse cosmique, des billions de neutrinos emportent l'énergie du cataclysme.
Les images médicales sont des cartes de densité des tissus. La luminosité de chaque point indique ce qui se trouve à cet endroit, un peu comme la photométrie mesure l'intensité de la lumière. Mais les algorithmes habituels analysent les points individuellement, ce qui donne des contours d'organes irréguliers.
L'oreille humaine se concentre sur ce qui lui est familier, mais ce nouveau système fonctionne autrement : il capte tout pic sonore, même celui qui n'a jamais été entendu auparavant. C'est la diarisation audio — pas simplement la recherche de bruits précis, mais le découpage de tout l'enregistrement en segments où l'on note le début et la fin de chaque événement.
Sur une cuisinière à gaz, chaque brûleur chauffe différemment. Si le cuisinier déplace les casseroles, la nourriture peut brûler. Il en va de même dans un réseau sans fil : les antennes-brûleurs et les utilisateurs-casseroles nécessitent un placement précis. Les réseaux de neurones classiques ne distinguent pas les positions, considérant tous les brûleurs comme identiques.
Les systèmes électriques équipés de panneaux solaires et d'éoliennes ressemblent à une partie d'échecs : la couverture nuageuse et les variations de charge sont des coups de l'adversaire impossibles à prévoir. Pour maintenir l'équilibre, les opérateurs devaient auparavant évaluer des dizaines de scénarios (incertitude) — ce qui demandait trop de temps et de calculs.
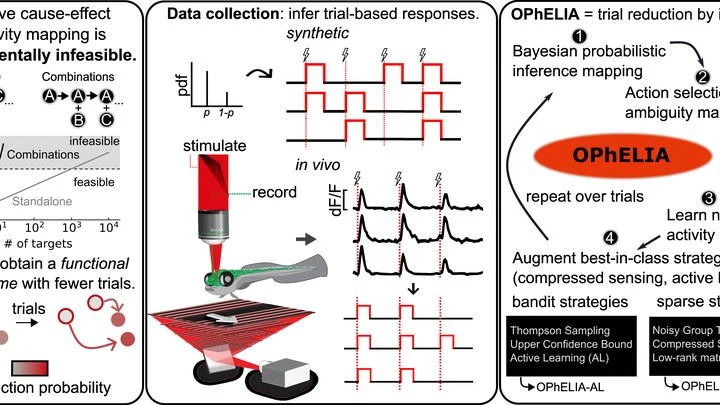
Pour comprendre le cerveau, il faut savoir comment les neurones sont connectés. Habituellement, on les active un par un avec de la lumière — c'est comme vérifier chaque robinet d'un immense jardin pour trouver tous les tuyaux. Des millions d'essais prennent du temps et peuvent endommager le tissu vivant.
Les assistants logiciels d'écriture de code agissent souvent comme un cuisinier qui, pour faire cuire un seul œuf, relit tout son livre de recettes. Face à une demande de correction minuscule, ils rouvrent des dizaines de fichiers et vérifient des liens connus depuis longtemps. C'est du travail inutile — de l'énergie gaspillée.
Des chercheurs ont pris 16 activités quotidiennes — de la vaisselle aux squats — et ont décomposé les mouvements en composantes élémentaires, un peu comme un spectroscope décompose la lumière en spectre. En comparant trois approches, ils ont trouvé une clé inattendue pour la reconnaissance : une simple image moyenne suffit.
L'or ne se trouve pas en surface — il est caché dans des tonnes de stérile. Pour extraire un gramme de métal précieux, les chercheurs d'or tamisent des mètres cubes de terre.
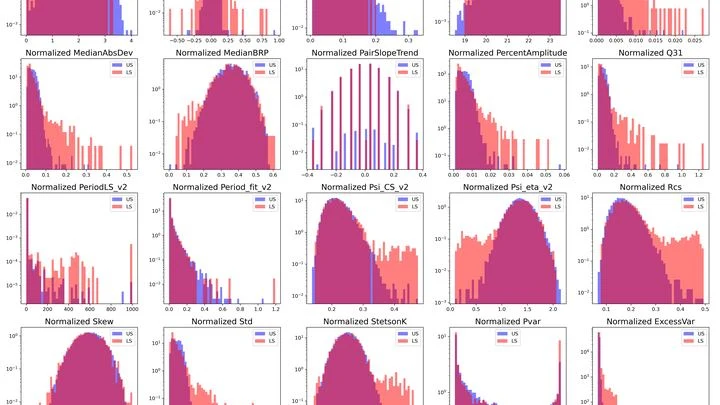
Pendant des siècles, les astronomes ont scruté le ciel nocturne, guettant les moindres variations de luminosité des étoiles. Ces séries irrégulières — les courbes de lumière — sont comme des portées musicales : chaque étoile joue sa propre mélodie unique.
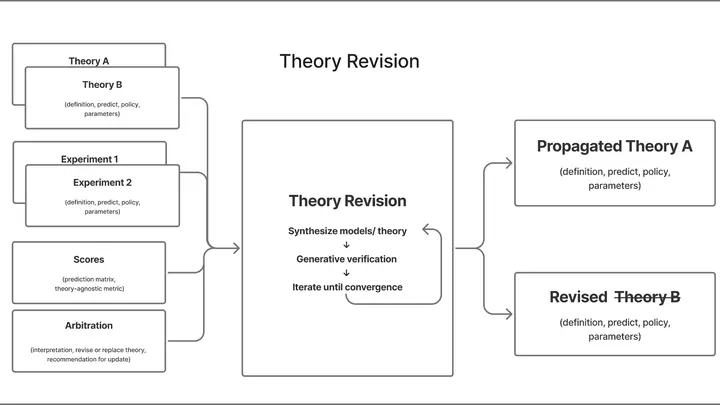
Un cercle vertueux : la machine émet une idée, la teste sur des humains, constate les échecs et génère une nouvelle hypothèse, plus précise. C'est ainsi que fonctionne AutoCog, le scientifique cognitif automatique. Auparavant, dans la science de l'esprit (les sciences cognitives), la partie la plus difficile — inventer une théorie — était réservée aux humains.
Un électrolyte solide n'est pas qu'un simple réseau cristallin, c'est une véritable métropole animée pour les ions. Chaque acte de conduction ressemble à un trajet à travers la ville : il y a de larges autoroutes à faible barrière énergétique, des embouteillages inextricables dans les goulots d'étranglement et des détours piégeux où un ion peut rester coincé.
Nous avons l'habitude de penser que ne remarquer que les confirmations de nos intuitions est une erreur. Mais des calculs récents, inspirés par le comportement des vagues, renversent ce point de vue. Il s'avère que l'habitude de chercher ce qui est familier est le meilleur moyen de réduire le bruit informationnel (les scientifiques l'appellent entropie).
De nombreux calculs de pointe en physique se heurtent à un mur : ce qui les freine n'est pas un manque d'idées, mais l'arithmétique. Il s'agit d'intégrales qui expriment la probabilité de collision de particules ou la forme d'une onde gravitationnelle.
Un chef ne gaspille pas ses ingrédients en préparant tout le plat pour en évaluer le goût — il goûte une goutte de sauce. C'est la même logique qui sous-tend la méthode du « jumelage d'informations » pour prédire la résistance des métaux.
Une personne regarde une serrure de porte et voit la fente pour la clé. Elle sait qu'on insère la clé et qu'on la tourne. Mais si, au lieu d'une serrure, il y a un panneau tactile, le cadre habituel se brise. La personne ne se trompe pas simplement : elle comprend que la méthode habituelle ne convient pas et peut dire : « Il n'y a pas de place pour une clé ici, il faut une autre approche ».
Un correcteur relit un manuscrit avant impression. Il ne connaît pas toutes les erreurs possibles, mais il se souvient parfaitement de ce à quoi ressemble un texte impeccable. S'il voit un symbole étrange ou un mot flou, il entoure immédiatement l'endroit en rouge. C'est à peu près ainsi que fonctionne le nouveau programme de vérification des images médicales.
Chez une personne, la maladie commence par un tremblement de la main — la tasse danse sur la soucoupe pendant qu'il la porte vers la table. Chez une autre, les jambes refusent soudain de marcher droit : le pas devient court, traînant, comme si le sol était recouvert d'une couche collante. Ce ne sont pas deux maladies différentes, mais deux visages d'une même maladie — la maladie de Parkinson.
Chaque fois que vous hésitez devant un pas risqué — investir dans des actions ou attendre — un dialogue interne se déroule dans votre tête. Habituellement, les scientifiques tentent de reconstituer le fil de ce dialogue à partir du seul choix final, comme si un détective reconstituait une conversation entre deux personnes en regardant une photo du lieu de rencontre.
Chercher un nouveau matériau, c'est un peu chercher une aiguille dans une botte de foin, sauf que la botte ici, ce sont des millions de combinaisons possibles d'atomes. Autrefois, les scientifiques passaient des années à éplucher les options en laboratoire, en s'en remettant à l'intuition et à la chance.
Un spectromètre à neutrons ressemble à un géologue aveugle qui tâte la roche et devine ce qu'elle cache au son. Il envoie un faisceau de neutrons dans un cristal et observe comment ils se dispersent. Ce motif révèle comment oscillent les petits aimants atomiques – les spins. Mais où creuser et combien de temps écouter, c'était auparavant une décision humaine.
Le tomodensitomètre ressemble à un photographe qui fait le tour d'un objet et prend des clichés sous différents angles. D'habitude, il déclenche à intervalles réguliers et utilise la même quantité de lumière pour chaque photo. Mais si l'on doit photographier vite et sans gaspiller de pellicule, il faut choisir : quels angles sont les plus importants et où diriger davantage de lumière.
Le laborantin exécute consciencieusement toutes les étapes de l'expérience, mais à la fin, il écrit dans son rapport ce qu'il avait déjà en tête avant de commencer. C'est ainsi que se comportent les modèles de langage modernes lorsqu'on leur confie des recherches scientifiques.