Des jumeaux numériques pour apprendre au scanner express
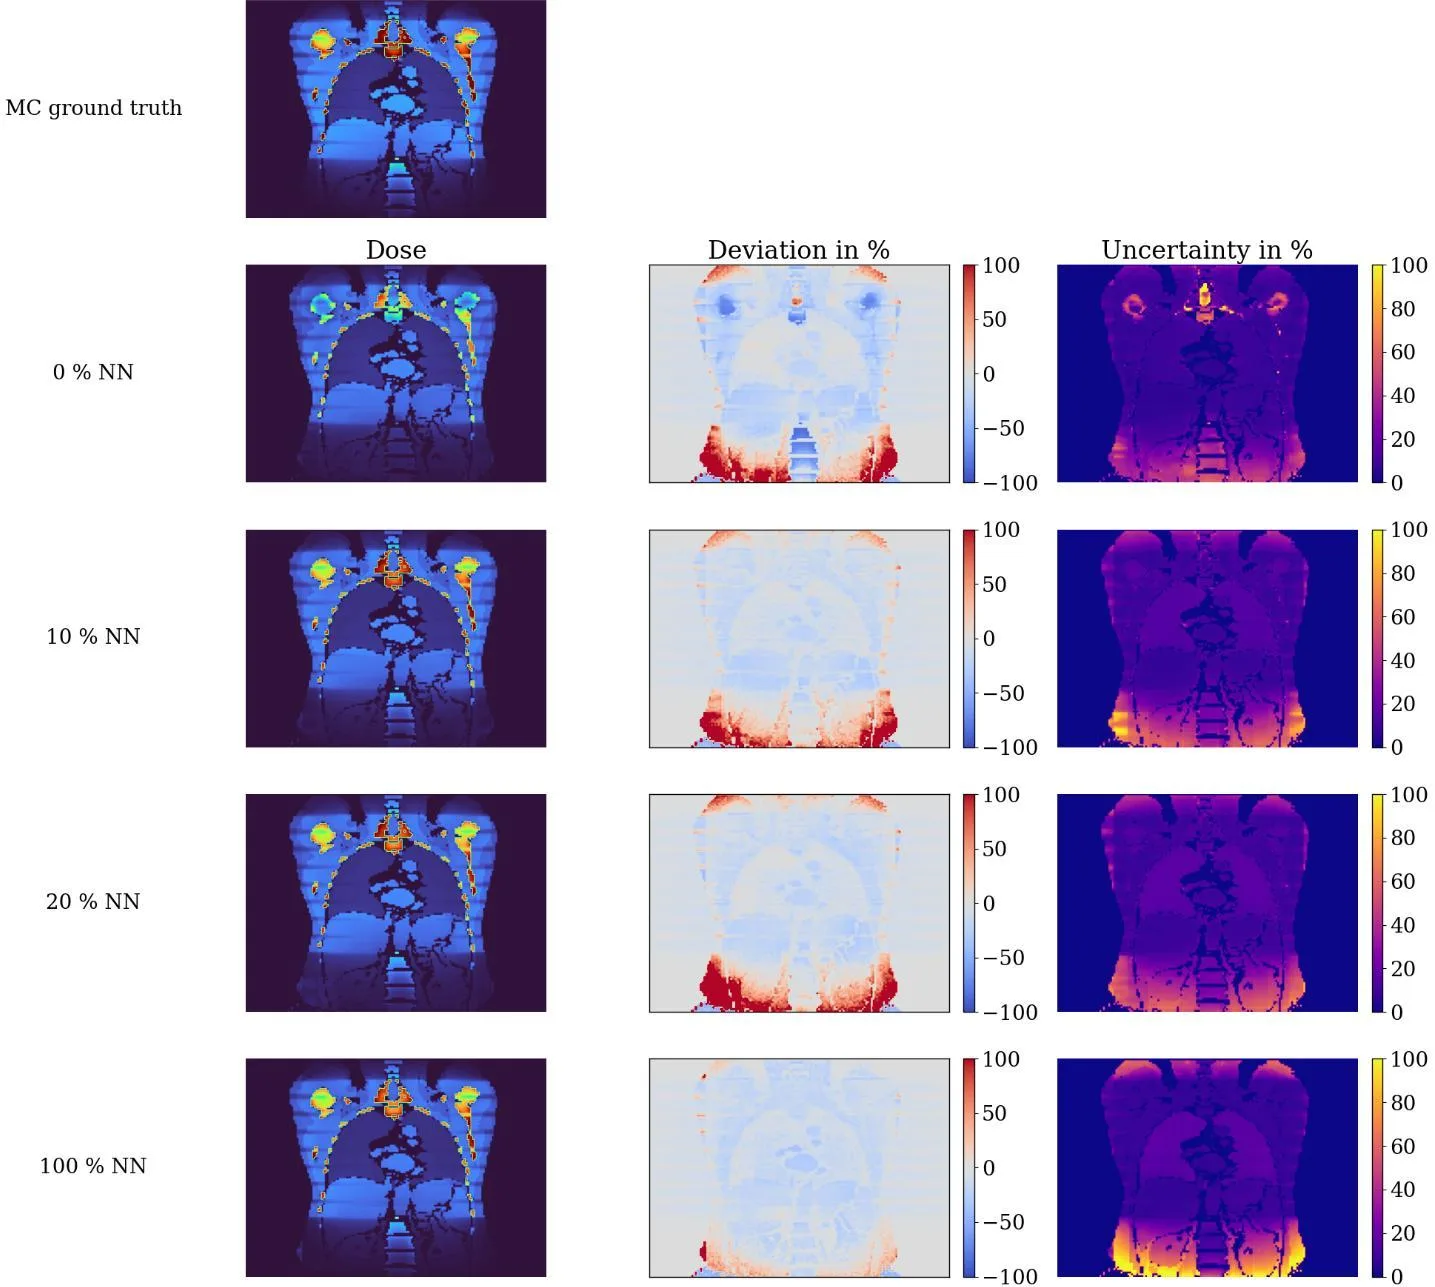
La tomodensitométrie, c'est comme une radiographie qui prend des centaines de clichés sous différents angles et en assemble une image en trois dimensions du corps. Mais chaque cliché expose à une petite dose de radiation, et les médecins doivent savoir quelle dose chaque organe reçoit. Actuellement, cette dose est souvent estimée de manière approximative, à partir de tables moyennes, plutôt qu'en fonction du patient spécifique.
Les chercheurs ont appris à un réseau de neurones à prédire la dose pour chaque organe. Pour l'apprentissage, il faut des exemples, mais les données réelles sont rares : on ne va pas irradier une personne pour une expérience. Ils ont donc créé des milliers de corps virtuels — des fantômes numériques avec différentes tailles d'organes et formes de corps. Le modèle entraîné uniquement sur ces données synthétiques commettait des erreurs sur les petits organes comme le cristallin ou la thyroïde.
Cette approche hybride, c'est comme l'entraînement d'un pilote : d'abord des centaines d'heures sur simulateur, puis quelques vols avec un instructeur. Les corps virtuels apportent de la diversité, et les données réelles ancrent le modèle dans la réalité. Cela réduit le besoin de dossiers médicaux réels et contribue à rendre la dosimétrie personnalisée.
Résumé original
tel que rédigé par les auteurs, en anglais arXiv:2601.09235
Personalized computed tomography (CT) dosimetry has great potential in assessing patient-specific radiation exposure, supporting risk assessment, and optimizing clinical protocols. The aim of this study is to evaluate the potential of synthetic anatomical data for improving machine learning-based personalized computed tomography (CT) dosimetry. It is investigated whether the combination of synthetic human body geometries with real patient data can improve model accuracy and generalization for CT organ dose estimation while maintaining the uncertainty requirements outlined in IAEA TRS-457. Deep learning models for organ dose prediction are trained using datasets with varying proportions of real and synthetic data. Synthetic datasets are generated from computational human phantoms with controlled distributions of organ volumes and body. A dedicated model uncertainty evaluation method is implemented to quantify prediction reliability and verify compliance with TRS-457 accuracy limits. Model performance and uncertainty are compared across different training data compositions, including a model trained solely on real patient data. As baseline validated Monte Carlo simulation is used. Models trained solely on synthetic data show limited predictive accuracy, particularly for small or peripheral organs. Incorporating as little as 10 % real patient data significantly improves both statistical accuracy and uncertainty estimates, achieving a performance comparable to that of real-only models. The hybrid training approach improves robustness across different anatomies while maintaining TRS-457-compliant uncertainty levels (k=2 uncertainty < 20% for adults). The results indicate that the combination of real and synthetic data in combination with a systematic uncertainty assessment supports the development of CT dosimetry models and at the same time reduces the amount of real data required.
Les fantômes virtuels pour l'apprentissage ont été créés avec une dispersion contrôlée des volumes d'organes — de très petits à très grands — afin que le modèle ne soit pas surpris par la diversité des corps humains.