La régularisation est une technique utilisée pour ajuster des modèles à des données lorsque le problème est mal posé ou sous-déterminé, c'est-à-dire lorsqu'il y a trop de paramètres par rapport aux données, ou que les données sont bruitées. Sans régularisation, l'ajustement peut produire des solutions très oscillantes qui correspondent parfaitement aux données mais n'ont aucun pouvoir prédictif (surajustement). La régularisation ajoute un terme de pénalité à la fonction objectif (par exemple, la somme des carrés des erreurs) qui décourage les valeurs extrêmes des paramètres, ce qui permet d'échanger une légère augmentation du biais contre une forte réduction de la variance.
Histoire
Le concept remonte aux années 1940 avec les travaux de Tikhonov sur les problèmes mal posés, et a été popularisé en statistiques par Hoerl et Kennard (1970) sous le nom de régression ridge.
Comment ça marche
Au lieu de minimiser la perte habituelle L(θ) (par exemple, le chi-deux), on minimise L(θ) + λ R(θ), où R est une pénalité (par exemple, la somme des carrés des paramètres pour la régression ridge, ou la somme des valeurs absolues pour le lasso) et λ est un paramètre de réglage qui contrôle la force de la pénalité. Un λ plus grand force les paramètres vers zéro ou les uns vers les autres, lissant la solution. Le choix de λ se fait souvent par validation croisée pour équilibrer l'ajustement et la simplicité.
En pratique
Essentielle en apprentissage automatique (par exemple, pour éviter le surajustement dans les réseaux de neurones), en reconstruction d'images (par exemple, les scanners CT), et en géophysique pour l'inversion des données sismiques.
Anecdote
La régularisation est mathématiquement équivalente à l'hypothèse d'une distribution a priori sur les paramètres dans l'inférence bayésienne : la régression ridge correspond à un a priori gaussien, et le lasso à un a priori de Laplace.
Une pierre tombe dans une eau calme, et des cercles se propagent à la surface. Un trou noir se comporte de manière similaire lorsqu'un objet tombe en lui ou lorsqu'il fusionne avec un autre. Le trou noir se met à osciller, et ces oscillations s'échappent dans l'espace sous forme d'ondes gravitationnelles.
L'algorithme d'amélioration de photos ressemble à un GPS qui guide pas à pas une image floue vers une version nette. Le bruit et les distorsions, il les élimine en se déplaçant de pixel en pixel sur une carte familière. Mais si le cliché est pris dans des conditions inconnues — par exemple avec un flai inhabituel — la carte ne correspond pas au terrain.
L'approche standard pour une classe de problèmes d'apprentissage automatique évoque un ressort étiré qu'on oublie de relâcher : les méthodes standard gonflent artificiellement la taille du problème, transformant les calculs en trou noir pour la mémoire et le temps.
Les antennes classiques, pour déterminer précisément la direction, doivent fonctionner de manière coordonnée : elles captent non seulement le volume, mais aussi la position de l'onde à un instant donné. Le moindre défaut de réglage, et la direction est perdue. La nouvelle méthode ne s'appuie que sur la force du signal.
Les étoiles à neutrons sont les derniers agrégats de matière visible avant la chute dans un trou noir. Dans leurs entrailles, la matière est comprimée à des densités de l'ordre du billion. Là, les forces nucléaires et la gravité s'entrelacent pour former une substance exotique inaccessible à tout accélérateur terrestre.
Un flocon de neige grandit, une nappe de pétrole s'étale, une foule se déplace – les équations diffèrent pour chaque cas. Mais le résultat final est souvent le même : la forme, la vitesse, le motif obéissent à un schéma simple qui se répète à différentes échelles. C'est cela, l'universalité : derrière les détails se cache une loi commune.
À l'écran, le résultat d'une simulation complexe : deux planètes entrent en collision, une onde de choc se propage. Quelques clics dans l'éditeur – et les ombres dures s'adoucissent, le bruit s'estompe, l'arrière-plan s'assombrit. Cette retouche numérique (modification d'une image pour améliorer son apparence) fait depuis longtemps partie de l'arsenal des scientifiques.
L'or ne se trouve pas en surface — il est caché dans des tonnes de stérile. Pour extraire un gramme de métal précieux, les chercheurs d'or tamisent des mètres cubes de terre.
Les modèles statistiques sont une tentative de tendre une toile mathématique idéale sur le paysage accidenté des données. Lorsque le modèle résiste, il émet une tension, mais nous avons pris l'habitude de l'ignorer. Les chercheurs passent des heures à scruter les graphiques de résidus, essayant de deviner où le modèle « craque ». Squealer traduit cette résistance en son.
Le robot de laboratoire compte les molécules — et se trompe. Dans un tube, 0 ; dans un autre, 12 ; dans un troisième, 3, alors qu'en réalité, il y en a à peu près autant partout. Ces chiffres « bruts » sont monnaie courante en biologie : séquençage de l'ADN, comptage des espèces dans un échantillon d'eau, activité des gènes.
Un trou noir n'est pas simplement une tache sombre dans le ciel. C'est un objet complexe dont les propriétés dépendent de la géométrie de l'espace-temps qui l'entoure.
Un réseau social ressemble à une ville : il y a des quartiers géants et des ruelles minuscules. Quand un algorithme y cherche des groupes soudés, il sort souvent deux ou trois énormes ensembles et beaucoup de petits fragments. Mais le client — par exemple, une municipalité — a besoin de quartiers à peu près de la même taille pour répartir équitablement les cliniques ou les écoles.
L'appareil photo prend une image, mais le capteur bruit, l'optique floute, et une partie des pixels est surexposée. Reconstituer l'image d'origine, c'est un peu comme deviner une mélodie sur un disque rayé : les possibilités sont nombreuses, et l'on ne sait pas laquelle est la bonne.
Un programmeur écrit du code, l'exécute, voit l'erreur et corrige. Désormais, ce processus peut être confié au programme lui-même. L'apprentissage profond en imagerie médicale sait déjà améliorer des algorithmes, mais il exige généralement beaucoup de données et d'exemples prêts à l'emploi.
On peut comparer un réseau de neurones à une résidence où chaque locataire dispose de sa propre chambre. En général, chaque signal dans les données occupe un neurone distinct, et l'apprentissage se fait séquentiellement : d'abord un signal, puis un autre. C'est lent et cela dépend des données rencontrées.
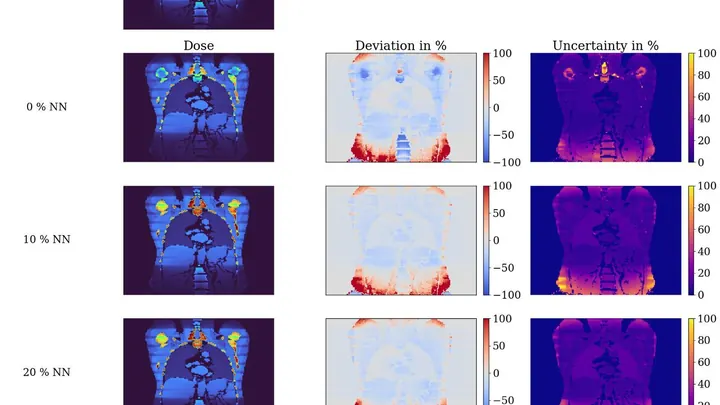
La tomodensitométrie, c'est comme une radiographie qui prend des centaines de clichés sous différents angles et en assemble une image en trois dimensions du corps. Mais chaque cliché expose à une petite dose de radiation, et les médecins doivent savoir quelle dose chaque organe reçoit.
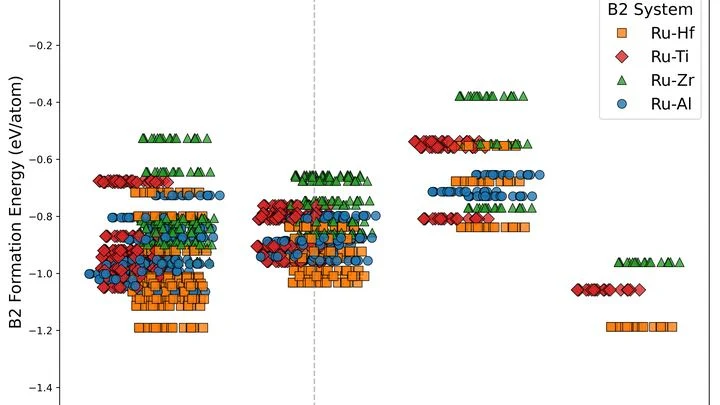
Des briques de tailles différentes, posées dans un même mur, y laissent des fissures. C'est à peu près ce qui se passe avec les atomes dans les alliages réfractaires : lorsque deux métaux différents forment un réseau cristallin commun et que leurs atomes diffèrent légèrement en taille, une contrainte apparaît à l'intérieur du matériau.
Un interprète dans une salle bruyante essaie de distinguer la parole du brouhaha. La méthode habituelle consiste à mémoriser un ensemble de phrases et à les appliquer selon un schéma. Mais si le bruit augmente, le schéma se brise.
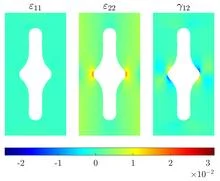
Le laboratoire d'essais mécaniques ressemble à une cuisine où le chef goûte un plat pour deviner la recette. Pour un matériau anisotrope, c'est-à-dire plus rigide le long des fibres que dans le sens travers, un seul échantillon ne suffit pas. Il faut trois essais distincts, voire plus, chacun avec son propre échantillon.