Les données d'entraînement sont les exemples—images, textes ou mesures—utilisés pour apprendre à un modèle d'apprentissage automatique à reconnaître des motifs et à faire des prédictions. La qualité et la diversité de ces données déterminent ce que le modèle apprend et sa capacité à généraliser à de nouvelles situations. Sans données d'entraînement représentatives, même l'algorithme le plus sophistiqué échoue.
Histoire
Le concept est apparu dans les années 1950 avec les perceptrons, mais l'apprentissage profond moderne repose sur des ensembles de données massifs et une puissance de calcul devenue disponible dans les années 2010.
Comment ça marche
Pendant l'entraînement, le modèle ajuste ses paramètres internes pour minimiser l'écart entre ses prédictions et les réponses correctes dans les données d'entraînement. Cela se fait de manière itérative, souvent par descente de gradient, où le modèle apprend à extraire les caractéristiques pertinentes des exemples. Le processus est analogue à l'ajustement d'une courbe à des points, mais dans des espaces de grande dimension.
En pratique
Les données d'entraînement alimentent les réseaux de neurones qui diagnostiquent des maladies à partir d'images médicales, prédisent les conditions météorologiques et traduisent des langues en temps réel.
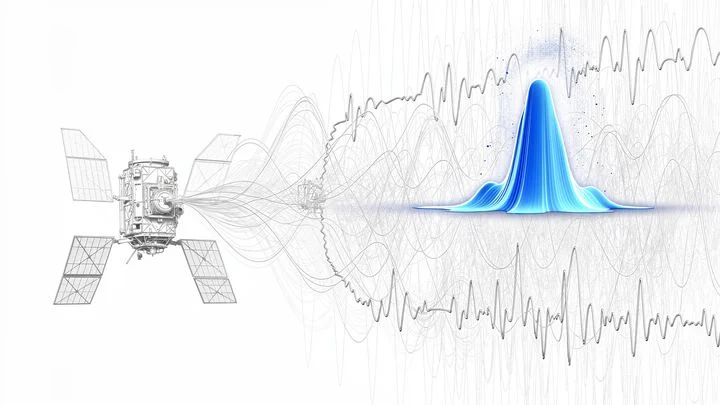
Dans la glace antarctique, une particule fantôme ne laisse qu'un faible éclat de lumière bleue. Le détecteur IceCube capture ces éclats, et à partir d'eux, il faut déterminer d'où vient la particule. Le modèle PolarBERT a appris à le faire, mais ce qu'il voit réellement à l'intérieur restait un mystère.
Une protéine dans une cellule ne reste pas immobile comme un mannequin en vitrine. Ses atomes tremblent, s'étirent et se plient constamment, un peu comme une corde de guitare tendue qui continue de vibrer après qu'on l'a pincée. Pour comprendre comment une protéine fonctionne, il faut savoir à quel point chaque partie est fermement liée à ses voisines.
Un ingénieur en protéines ressemble à un cuisinier qui essaie de préparer un plat à la fois savoureux, sain et économique. En modifiant un ingrédient, il risque d'en gâcher un autre. Autrefois, les assistants informatiques ne pouvaient évaluer les propriétés des protéines qu'individuellement, sans voir comment elles sont liées entre elles.
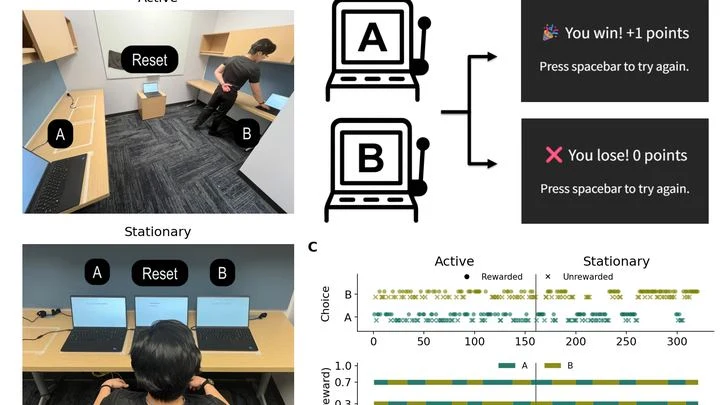
On lance une pièce pour prendre une décision. On reste immobile — la pièce tombe sur pile. On fait quelques pas — et on relance. On pourrait penser que la marche n'influence pas la pièce. Mais que se passerait-il si la promenade elle-même modifiait la fréquence à laquelle on décide de simplement répéter le lancer précédent ?
C'est exactement ce que les chercheurs ont testé.
Quatre faibles traits sur l’image — tout ce que voit l’astronome. Ainsi, un sculpteur restaure la forme d’un verre invisible à partir de quatre ombres.
Cent mille étoiles dans le noyau dense d’un amas globulaire se déplacent comme des billes d’acier dans un flipper géant. Chaque « choc » — une rencontre gravitationnelle entre un couple binaire et une étoile isolée — déclenche une cascade d’événements imprévisibles.
Une immense bibliothèque où chaque livre est une instruction précise pour assembler une molécule de protéine. Le réseau de neurones AlphaFold2 a lu des millions de ces livres et a appris à fournir instantanément un modèle tridimensionnel prêt à l'emploi.
En plein combat, un pilote doit comprendre instantanément ce qu'est un objet et quelles sont ses intentions. Les systèmes conventionnels attendent des données radar complètes – c'est comme un gardien qui ne réagit qu'après le tir. Le nouvel algorithme, lui, agit comme un gardien chevronné : dès les premiers mouvements de l'attaquant, il anticipe la manœuvre de la cible.
Les signaux radio dans une pièce se comportent comme le son dans une salle de concert : en se réfléchissant sur les murs et les objets, ils créent une empreinte unique — la mélodie silencieuse de chaque lieu. Le téléphone, telle une oreille attentive, capte cette mélodie dans le bruit et les distorsions. Il mémorise quel accord correspond au coin du canapé, et lequel à l'embrasure de la porte.
Le robot jongleur attrape et lance des balles en parfaite cadence avec l'humain, tels deux pulsars émettant leurs impulsions à l'unisson. Jongler avec trois balles, c'est le classique «cascade», un enchaînement régi par une pulsation régulière, semblable à la rotation d'un phare cosmique. Que l'on casse le rythme, et le motif s'effondre.
L'intelligence artificielle qui prédit l'acoustique d'une salle fait penser à un étudiant qui triche à l'examen avec une antisèche. Si les points de validation sont les mêmes que ceux de l'entraînement, le modèle se contente de mémoriser l'« empreinte » sonore de chaque position, comme un étudiant qui reconnaît un sujet grâce à un coin de page plié.
Les modèles qui transforment le texte en audio reproduisent bien les sons isolés, mais se mélangent les pinceaux quand le scénario en comporte plusieurs. Par exemple, selon le scénario, on a d'abord une sonnerie, puis des pas, puis un claquement de porte. Le générateur peut intervertir les événements, et le spectateur entendra les pas avant la sonnerie.
L'approche standard actuelle de l'apprentissage de l'IA ressemble à un enfant enfermé dans une bibliothèque : il mémorise des millions de livres, mais ignore que le feu brûle et que la chute fait mal.
Le cerveau communique par de brefs clics électriques. Autrefois, pour apprendre cette langue, il fallait des milliers d'exemples traduits par l'expérimentateur. La méthode MOJO suit une autre voie : comme dans l'apprentissage par immersion, elle écoute d'abord le « flux de conscience » sans aucune indication et repère elle-même les motifs récurrents.
Évaluer la qualité d'une image, c'est le travail d'un contrôleur méticuleux muni de tout un attirail. Le réseau de neurones IQA-T1 agit exactement ainsi : il ne se contente pas de dévisager l'image, il y applique tantôt un spectroscope, tantôt un luxmètre.
En général, les algorithmes apprennent à agir dans des conditions prédéfinies, comme l'eau qui coule dans un lit déjà creusé. La nouvelle méthode renverse cette logique : elle permet au système d'apprendre à la fois à agir et à modifier son environnement.
Quand vous tapez « salade » et que le clavier propose « césar », en coulisses, des millions de téléphones apprennent ensemble à prédire les mots. Ils n'échangent pas vos messages, mais seulement les améliorations de l'algorithme commun — comme un entraîneur qui envoie aux athlètes uniquement les changements au programme : « ajoutez 5 pompes à ceux d'hier ».
Des chercheurs ont pris 16 activités quotidiennes — de la vaisselle aux squats — et ont décomposé les mouvements en composantes élémentaires, un peu comme un spectroscope décompose la lumière en spectre. En comparant trois approches, ils ont trouvé une clé inattendue pour la reconnaissance : une simple image moyenne suffit.
L'arbre généalogique se transforme en écheveau si l'on tient compte des enfants adoptés et des remariages. L'évolution ressemble souvent à un tel écheveau : bien que le modèle standard dessine un arbre des espèces bien propre, en réalité les gènes voyagent non seulement par héritage, mais aussi directement entre organismes non apparentés.
Les machines complexes — des drones aux robots chirurgiens — se comportent parfois comme un mustang sauvage : pleines de désordre et de caprices, où un léger contact déclenche une tempête. Plutôt que de mémoriser des formules, la nouvelle méthode observe le système, tel un dresseur.
Un réseau électrique vivant ressemble à un organisme : les lignes à haute tension sont les vaisseaux, le courant est le sang. Les données, elles, sont les influx nerveux qui se perdaient autrefois. mAIEnergy connecte ces « nerfs » à un « cerveau » commun.
Un détective expérimenté ne calcule pas la trajectoire d'un criminel selon les lois de la physique — il consulte sa bibliothèque d'affaires similaires.
L'apprentissage automatique n'est plus depuis longtemps un simple outil — il devient un chercheur qui extrait lui-même les lois de la nature à partir des données. Mais comment un esprit de silicium parvient-il à la compréhension ?
Le ciel gamma, immortalisé par le télescope Fermi, est une symphonie grandiose de milliers de sources. On y trouve les pulsations rythmiques des pulsars, les accords puissants des noyaux actifs de galaxie, mais surtout des objets non identifiés dont la partition reste une énigme.
Les pérovskites hybrides sont les étoiles montantes de la photovoltaïque : leur efficacité progresse si vite qu'on croirait être au seuil d'une révolution solaire. Mais ces matériaux, véritables mosaïques d'atomes, sont extrêmement fragiles : l'humidité, la chaleur et la lumière les réduisent rapidement en poussière.
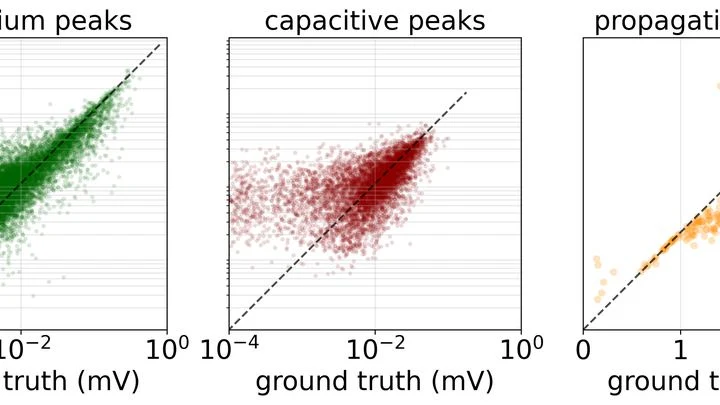
Un neurone ressemble à un instrument de musique complexe. Pour comprendre comment il réagit à une sollicitation, il fallait autrefois se connecter directement à chaque corde — une procédure délicate, lente et réservée à quelques cellules isolées.
Imaginez une audition pour un orchestre symphonique, où sur des centaines de candidats, seuls ceux dont les instruments sonnent juste et résistent à un crescendo furieux restent.
Près d'un siècle après que Fritz Zwicky a soupçonné quelque chose d'anormal dans le mouvement des galaxies de l'amas de la Chevelure de Bérénice, et que Vera Rubin a mesuré les vitesses stellaires dans les bras spiraux, la nature de la matière noire reste l'une des énigmes les plus lancinantes.
60 souris, 1980 échantillons, 234 patients atteints d'un cancer du poumon. Derrière chaque chiffre se cachent des milliers de gènes. Leur activité est mesurée pour comprendre la maladie.
Un médecin feuillette un dossier médical et voit une ligne : « Ce médicament réduit le risque ». Mais à quel point peut-on s'y fier ? L'affirmation repose-t-elle sur quelques cas cliniques ou sur des dizaines de milliers de patients dans une étude en aveugle ? De la réponse dépend le traitement.
Les réseaux de neurones classiques apprennent à partir d'exemples, un peu comme quelqu'un qui mémorise des mélodies à l'oreille. Mais les réseaux qui intègrent dès le départ les lois physiques ressemblent à un musicien qui connaît les notes et l'harmonie : il peut jouer un nouveau morceau à partir de quelques accords.
Un chef ne gaspille pas ses ingrédients en préparant tout le plat pour en évaluer le goût — il goûte une goutte de sauce. C'est la même logique qui sous-tend la méthode du « jumelage d'informations » pour prédire la résistance des métaux.
Concevoir des machines, c'est un peu comme faire de la pâtisserie : il faut savoir exactement où la pâte va se déchirer. Les anciens calculs informatiques vérifient chaque point de la pièce pendant des heures — comme si on mesurait toute la casserole pour être sûr que l'anse ne se détache pas.
Une bouilloire qui bout avec son couvercle fermé ne montre pas l'ébullition, mais le son et les vibrations trahissent la puissance de chauffe de l'eau.
Un caissier de supermarché à l'heure de pointe ne mémorise pas chaque article scanné — il garde en tête le total et surveille la file d'attente. C'est à peu près ainsi que le cerveau répartit ses forces : le cortex, coûteux et précis (ce qui est responsable de la réflexion), et les noyaux sous-corticaux, plus simples et économes (où vivent les habitudes), travaillent en binôme.
Les réseaux de neurones classiques apprennent sur des milliers d'exemples, gaspillant des heures et des gigawatts. Des physiciens ont trouvé une voie de contournement quantique. Déjà Max Planck avait montré la discrétion de l'énergie, et aujourd'hui cela permet de générer sans apprentissage.
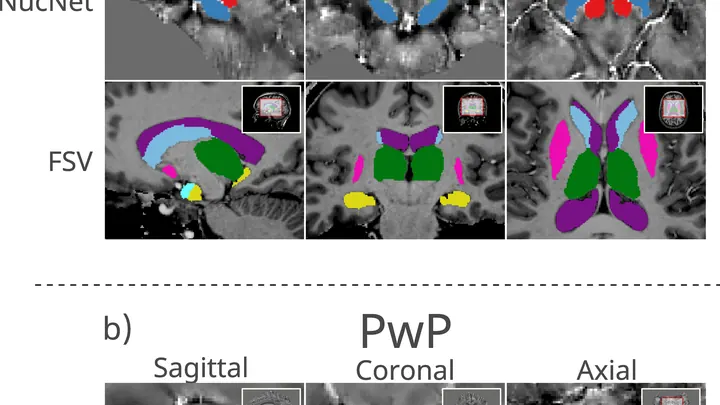
Chez une personne, la maladie commence par un tremblement de la main — la tasse danse sur la soucoupe pendant qu'il la porte vers la table. Chez une autre, les jambes refusent soudain de marcher droit : le pas devient court, traînant, comme si le sol était recouvert d'une couche collante. Ce ne sont pas deux maladies différentes, mais deux visages d'une même maladie — la maladie de Parkinson.
Une mosaïque de grandes tuiles colorées. Chaque tuile représente la quantité moyenne de précipitations sur un mois entier, sur un territoire de la taille d'un petit pays. Pour une compréhension globale, l'image est acceptable, mais si l'on veut savoir si un déluge est passé hier sur une ville précise, elle est inutile.
Chaque fois que vous hésitez devant un pas risqué — investir dans des actions ou attendre — un dialogue interne se déroule dans votre tête. Habituellement, les scientifiques tentent de reconstituer le fil de ce dialogue à partir du seul choix final, comme si un détective reconstituait une conversation entre deux personnes en regardant une photo du lieu de rencontre.