Apprendre à un réseau de neurones avec moins de données, mais intelligemment express
Les protéines dans la nature, c'est comme les grains de sable sur une plage, et chacune a son rôle : certaines décomposent les aliments, d'autres construisent les cellules. Mais pour comprendre ce que fait précisément une protéine, il faut l'étudier en laboratoire — ce qui est lent et coûteux. Les réseaux de neurones savent deviner la fonction d'une protéine à partir de son « texte » — la séquence d'acides aminés — mais leur apprentissage nécessite un grand nombre d'exemples annotés. Le problème, c'est que les protéines annotées sont rares : pour chaque protéine vérifiée en laboratoire, il y a un million d'inconnues.
Un groupe de chercheurs a proposé une approche semblable à un étudiant intelligent qui ne bachote pas tout le manuel, mais ne demande au professeur que les passages les plus difficiles. Cette méthode s'appelle apprentissage actif : le modèle choisit lui-même les protéines pour lesquelles il est le moins sûr et demande à un expert humain de leur attribuer la bonne étiquette. Ensuite, le modèle se ré-entraîne sur ces exemples sélectionnés. Les scientifiques ont mis au point un système qui combine plusieurs stratégies de sélection des protéines « difficiles » et permet à un humain de vérifier et corriger manuellement les prédictions.
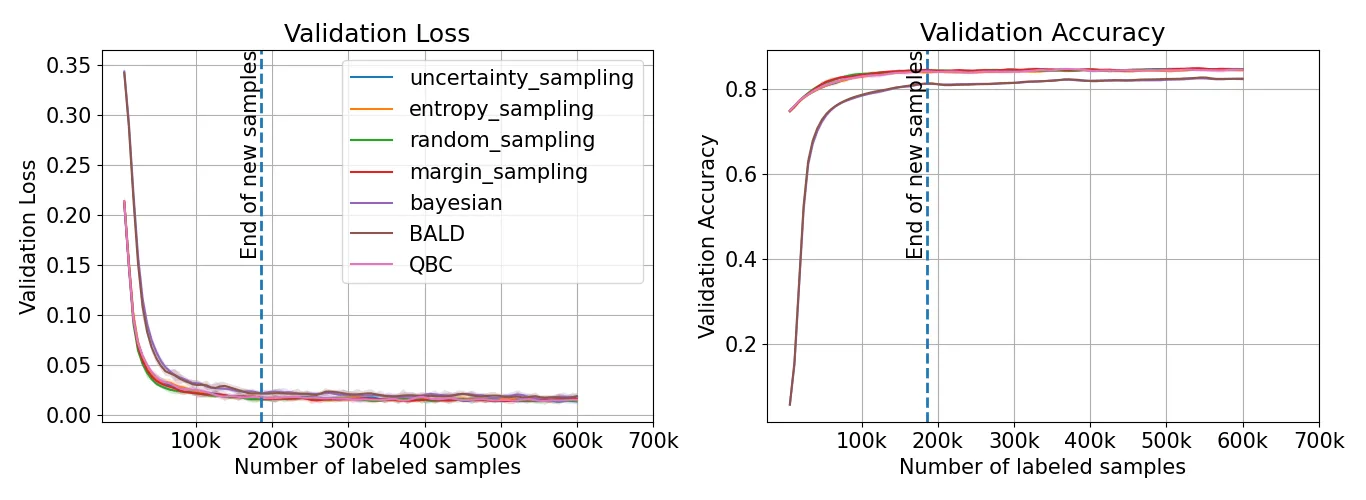
Les résultats ont été comparés à l'apprentissage classique, où l'on donne au modèle toutes les données d'un coup. Il s'est avéré que l'apprentissage actif atteint la même précision de prédiction, mais nécessite moins de mises à jour du modèle, traite moins de données et économise nettement les ressources de calcul. Pour les chercheurs, cela signifie que l'on peut étudier les fonctions des protéines plus rapidement et à moindre coût, sans perte de qualité.
Cette approche est particulièrement importante aujourd'hui, alors que les bases de données de séquences protéiques croissent à un rythme effréné et que la vérification expérimentale ne suit pas. Au lieu d'attendre des années que chaque nouvelle protéine soit étudiée en laboratoire, les scientifiques peuvent se concentrer sur les candidats les plus mystérieux et les plus prometteurs. C'est comme chercher des diamants dans un tas de sable : on ne tamise pas tout, mais seulement les endroits où l'on voit déjà un éclat.
La plus grande banque de séquences protéiques contient des centaines de millions d'entrées, mais seule une infime partie est vérifiée expérimentalement — moins d'un pour cent.