L'intrication quantique aide à jouer au ping-pong express
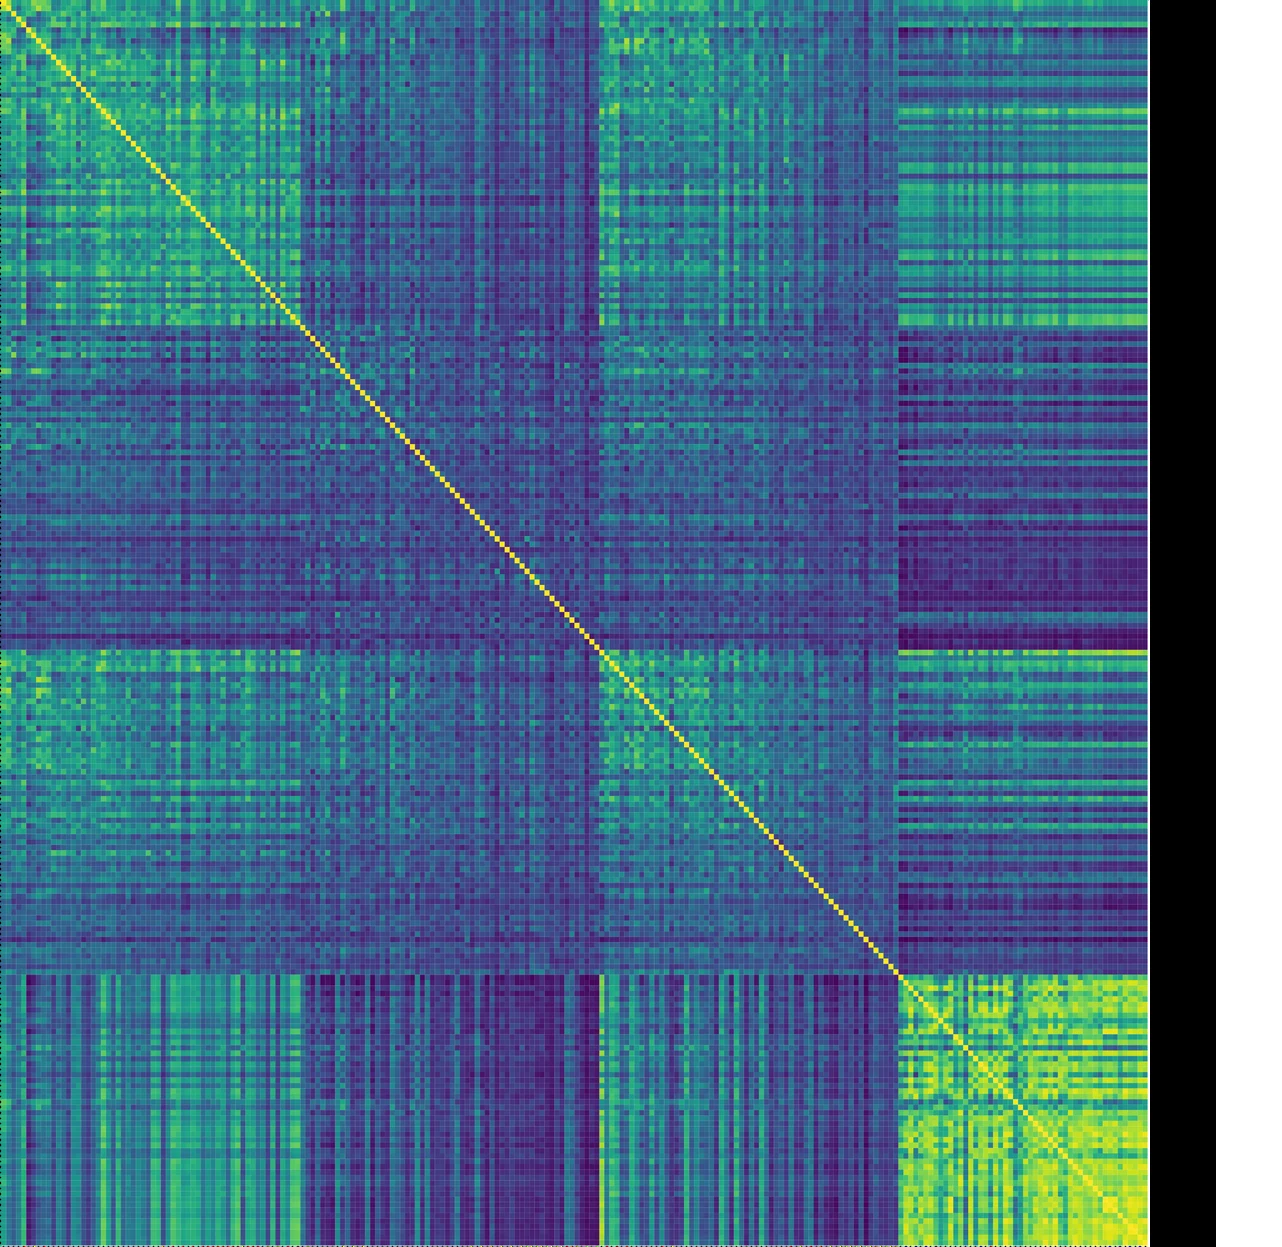
Au ping-pong, deux raquettes reliées par un fil invisible ressentent les mouvements de l'autre, devinant la trajectoire de la balle. Des chercheurs ont doté un ordinateur d'un fil semblable : l'intrication quantique. Dans un programme classique qui apprend de ses erreurs, ils ont intégré un circuit quantique de huit qubits — des particules capables de tourner comme une pièce sur sa tranche. Lorsqu'on les intrique (John Bell a montré l'étrangeté de cet effet), elles ne font plus qu'un : poussez l'une, toutes réagissent. Ce circuit servait d'« yeux » à l'algorithme, transformant les pixels de l'écran en signaux compréhensibles.
La tension du fil était ajustée en plein jeu, renforçant la connexion. Et le joueur intriqué a surpassé les réseaux de neurones classiques, surtout en cas de ressources limitées. Il distinguait des motifs cachés dans les mouvements de l'adversaire, invisibles pour les programmes simples. Le fil vibrait, transmettant l'information plus vite que n'importe quelle onde gravitationnelle, et son attraction rassemblait les qubits comme un mini trou noir. Étonnamment, pour une telle connexion, il a fallu refroidir la puce presque au zéro absolu — une température plus basse que celle de l'espace interstellaire.
Résumé original
tel que rédigé par les auteurs, en anglais arXiv:2603.10289
Whether uniquely quantum resources confer advantages in fully classical, competitive environments remains an open question. Competitive zero-sum reinforcement learning is particularly challenging, as success requires modelling dynamic interactions between opposing agents rather than static state-action mappings. Here, we conduct a controlled study isolating the role of quantum entanglement in a quantum-classical hybrid agent trained on Pong, a competitive Markov game. An 8-qubit parameterised quantum circuit serves as a feature extractor within a proximal policy optimisation framework, allowing direct comparison between separable circuits and architectures incorporating fixed (CZ) or trainable (IsingZZ) entangling gates. Entangled circuits consistently outperform separable counterparts with comparable parameter counts and, in low-capacity regimes, match or exceed classical multilayer perceptron baselines. Representation similarity analysis further shows that entangled circuits learn structurally distinct features, consistent with improved modelling of interacting state variables. These findings establish entanglement as a function resource for representation learning in competitive reinforcement learning.
Pour intriguer des qubits en laboratoire, on refroidit souvent les puces presque au zéro absolu — plus froid que dans l'espace ouvert.
Ce travail évoque l'idée du roman « La Stratégie Ender », où une intelligence artificielle apprend en analysant le comportement humain dans des jeux stratégiques.