Quand le code ne naît pas de l'article express
Un traducteur qui n'a jamais assisté à une réunion traduit mot à mot — et perd la moitié du sens. Il ne sait pas que le hochement de tête du chef signifie « faites comme la dernière fois », et que la phrase « on verra bien » est un refus poli. C'est pareil pour un modèle de langage qui écrit du code à partir d'un article scientifique : il lit les équations, mais pas les accords tacites.
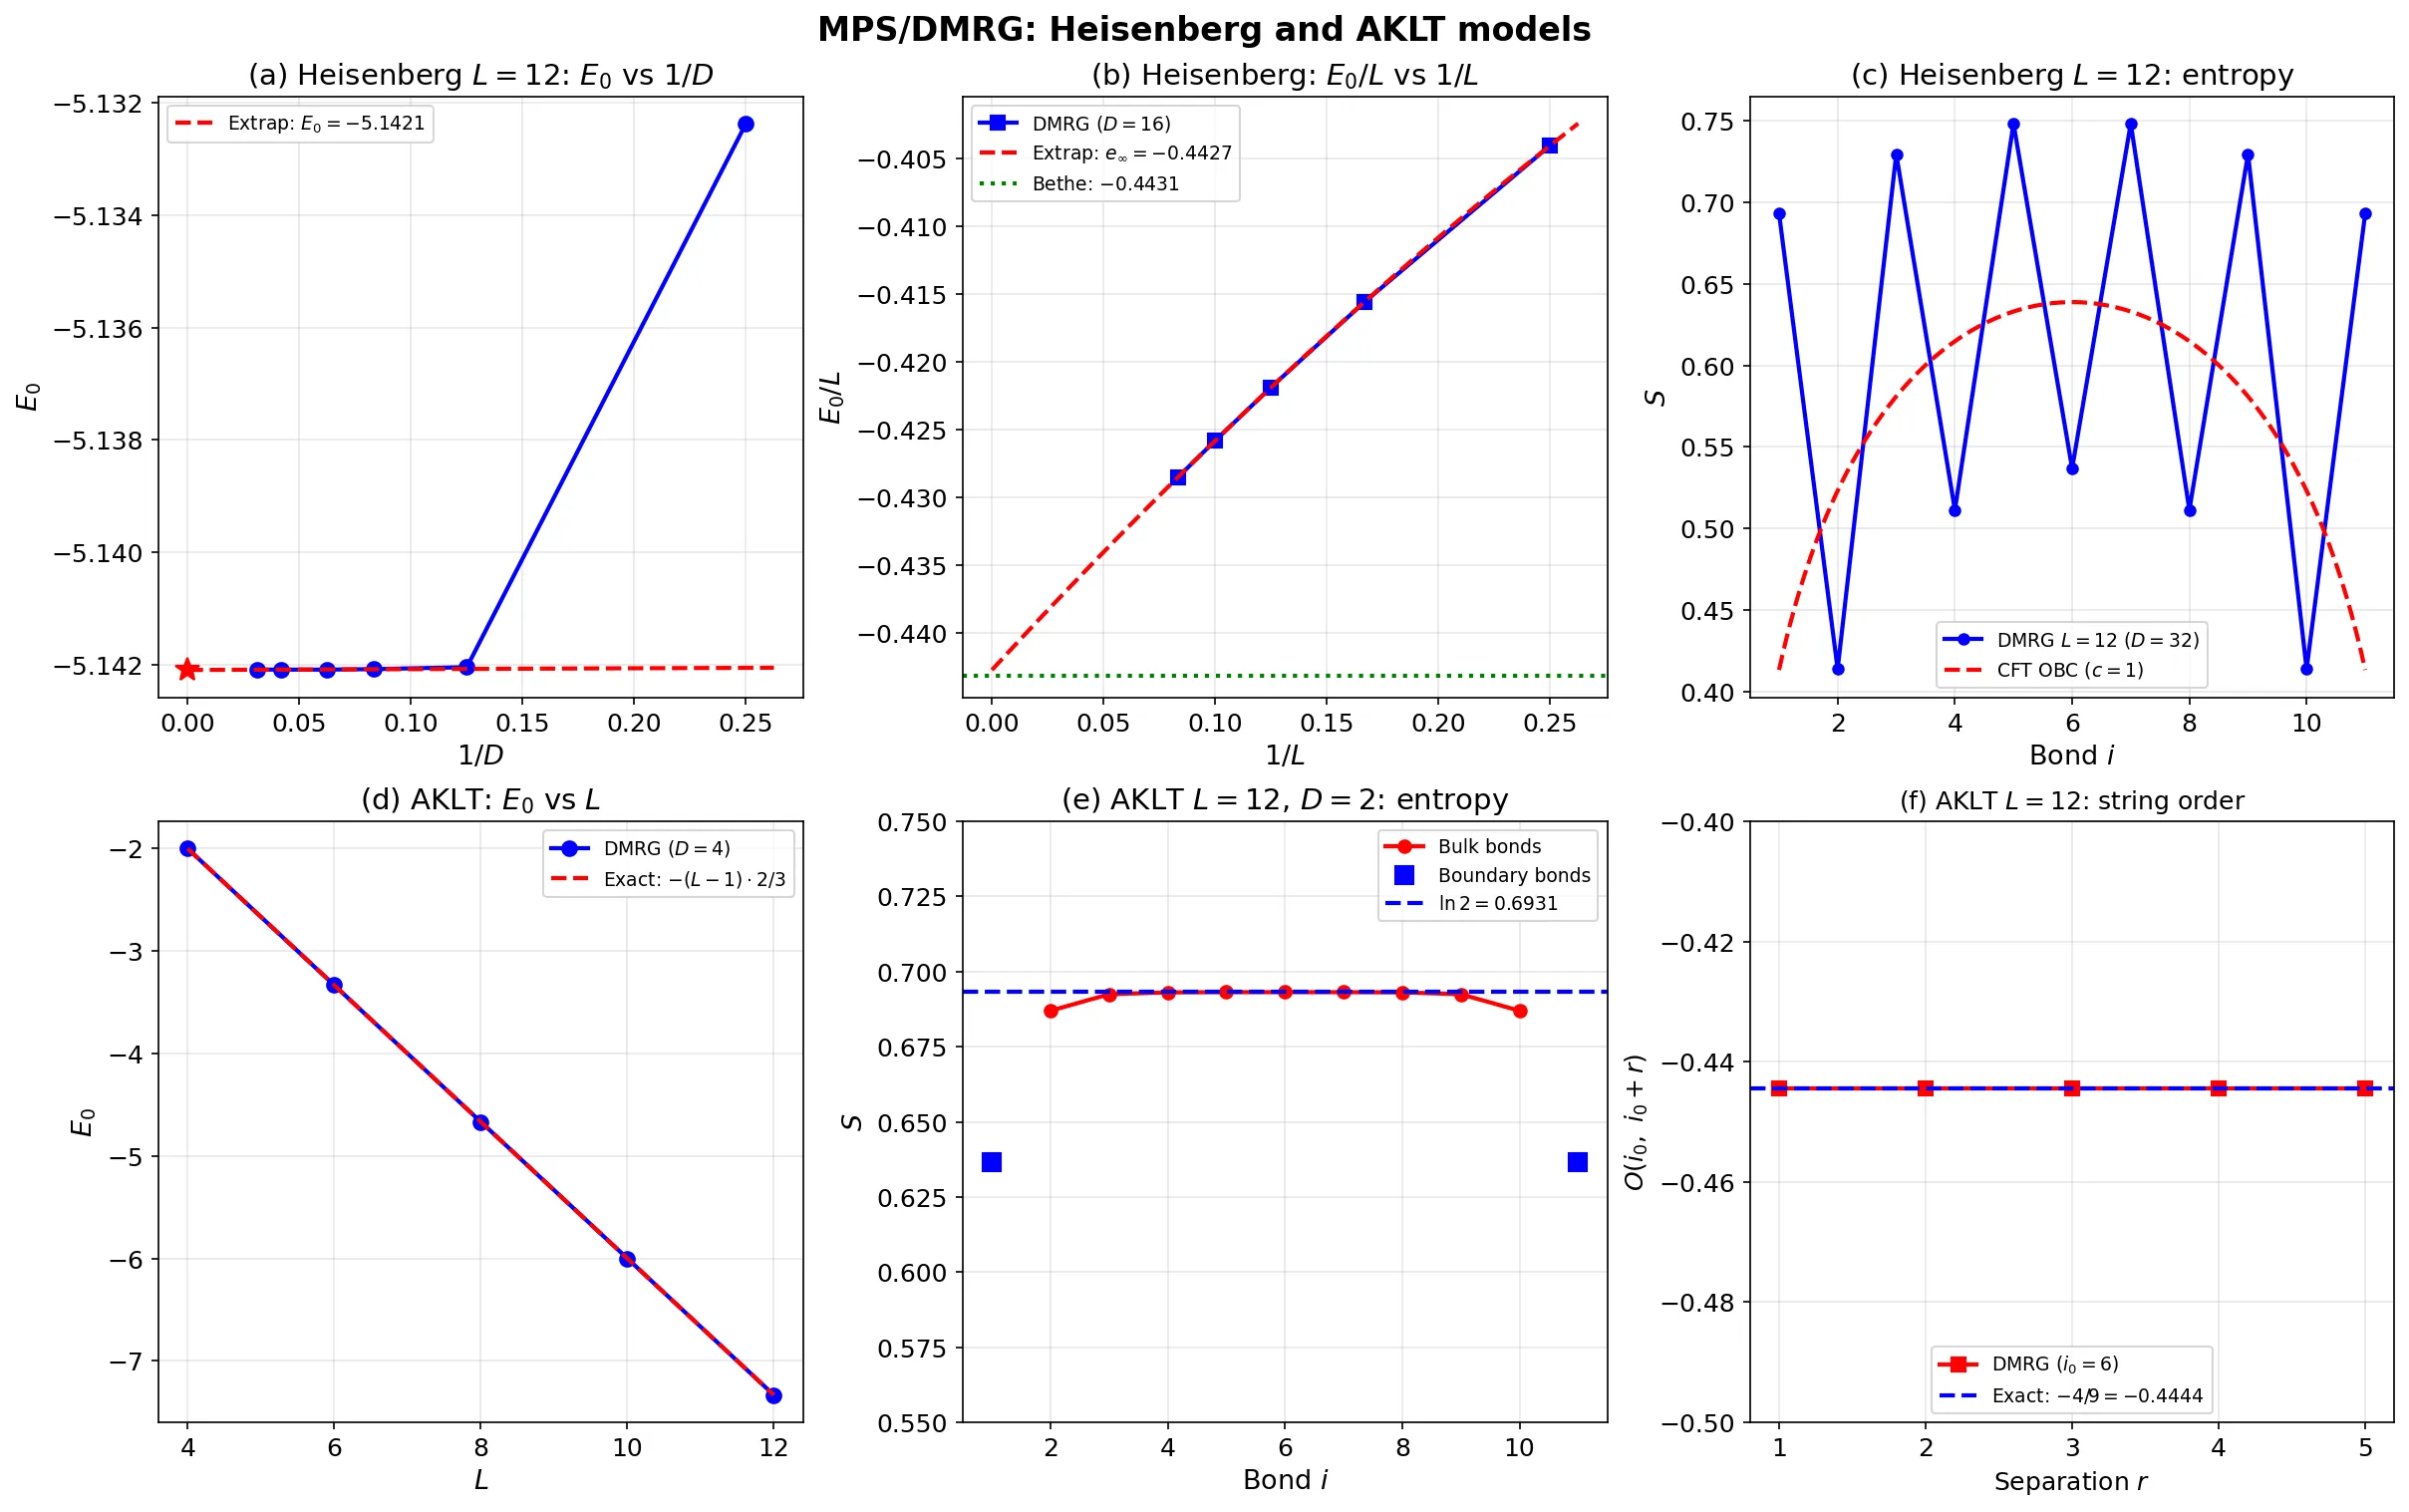
Les auteurs de l'étude ont voulu vérifier si l'on pouvait apprendre à l'IA à extraire ces règles cachées du texte. Ils ont pris deux problèmes de physique quantique à N corps — un domaine où les particules sont si nombreuses qu'il est inutile de les compter une par une. Pour le premier problème, plus simple, un humain et une machine ont élaboré ensemble une spécification détaillée : quels indices placer où, quel signe devant chaque terme, dans quel ordre multiplier. Après cela, le programme a fonctionné dans les seize variantes. Sans cette préparation, seulement dans six cas sur treize.
La deuxième tâche s'est avérée plus coriace. Il fallait restructurer une construction mathématique complexe, et les règles implicites étaient plus nombreuses : signes, jauges, ordre, contraintes de taille. Même après une spécification conjointe, les programmes n'ont fonctionné que dans onze cas sur vingt-six. Et sans préparation, jamais.
Un détail curieux : les spécifications rédigées par un modèle étaient parfaitement implémentées par un autre, mais l'inverse ne fonctionnait pas. Cela signifie que le problème ne réside pas seulement dans la compréhension de l'article, mais aussi dans la capacité du modèle à écrire du code correct. Deux points faibles.
Cette approche n'est pas seulement un moyen d'obtenir un programme. C'est aussi un outil de diagnostic : elle montre où exactement l'IA trébuche. Et peut-être indiquera-t-elle comment rendre les modèles plus intelligents.
L'étude a utilisé un modèle nommé GPT 5.5 — il s'agit d'un modèle fictif, pas d'un vrai. Les auteurs ont délibérément masqué les vrais noms pour se concentrer sur la méthode, pas sur des produits spécifiques.
Dans la nouvelle d'Isaac Asimov « Attrapez-moi un lapin », un robot ne peut pas accomplir une tâche parce qu'il ne comprend pas une règle implicite — et cela provoque un dysfonctionnement. Ici, l'histoire est similaire : l'IA n'a pas seulement besoin de connaissances, mais d'une compréhension du contexte.