Apprendre à une IA à lire les molécules comme une partition express
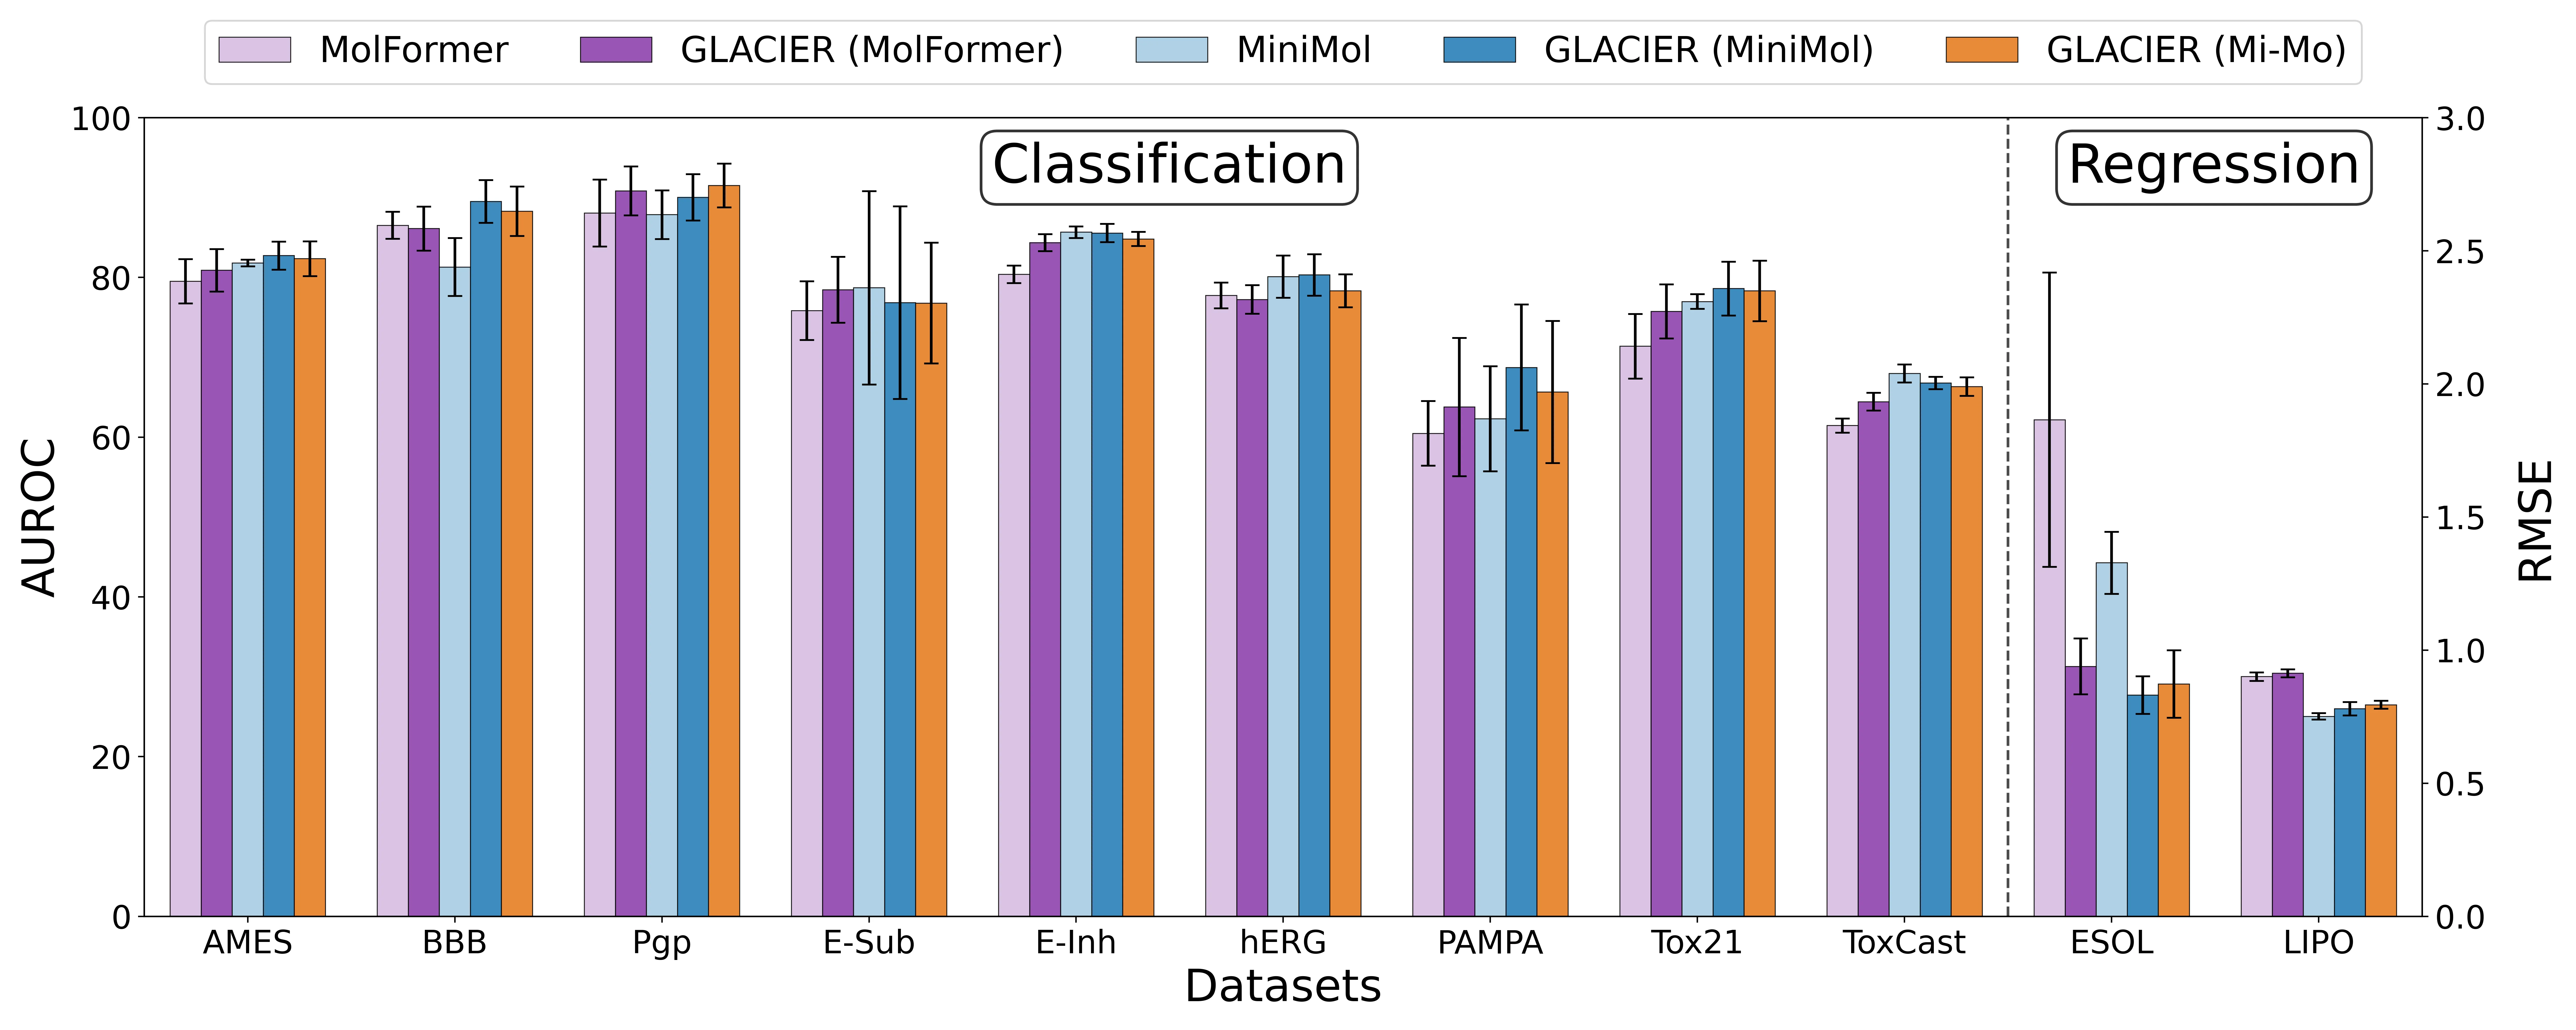
Chercher la bonne molécule parmi des milliards de possibilités, c'est un peu comme chercher un grain de riz dans un sac de riz. Pour ne pas tout éplucher à la main, les chimistes font de plus en plus appel aux réseaux de neurones. Mais les grands modèles exigent des ordinateurs puissants, et les petits manquent souvent de vision d'ensemble.
GLACIER résout ce problème à la manière d'un élève doué qui apprend auprès de plusieurs mentors. D'abord, trois « yeux » du modèle observent la molécule sous des angles différents : l'un la voit comme un graphe (un schéma avec des atomes comme sommets et des liaisons comme arêtes), le deuxième la lit comme une chaîne SMILES (une sorte de code-barres moléculaire), et le troisième évalue les paramètres physico-chimiques — taille, charge, solubilité. Ensuite, ces trois regards fusionnent en un portrait unique de la molécule grâce à un appareil mathématique inspiré de la géométrie de Finsler (c'est comme mesurer des distances non pas en ligne droite, mais le long d'un sentier de montagne sinueux).
À la dernière étape, les enseignants entrent en jeu : les grands modèles MiniMol et MolFormer, déjà entraînés sur d'immenses ensembles de données. L'élève GLACIER ne se contente pas de copier leurs réponses ; grâce à un mécanisme d'apprentissage contrastif, il apprend à rapprocher dans son espace interne les molécules qui sont semblables par essence, et à éloigner celles qui sont différentes. Ainsi naît un modèle compact mais très précis, capable de prédire les propriétés des substances sans calculs lourds.
Au final, un seul outil léger remplace un ensemble encombrant de programmes, accélérant la recherche de nouveaux matériaux et médicaments. Le grain de riz dans le sac peut désormais être trouvé non pas à tâtons, mais grâce à une description précise.
Résumé original
tel que rédigé par les auteurs, en anglais arXiv:2606.11382
Deep learning models facilitate the discovery of molecules with tailored properties among billions of candidate compounds. However, the computational burden to develop and deploy state-of-the-art models continuously increases, limiting their scalability. Most large-scale models are unimodal in nature and overlook the potential to leverage complementary molecular data modalities. To address these shortcomings, this paper introduces the Graph-Language Alignment for Chemical Inference and Exploration using Representations (GLACIER) model, a student-teacher framework that integrates molecular graphs, SMILES strings, and physicochemical descriptors to learn rich molecular embeddings. Our framework consists of three stages: (1) we pretrain three student encoders on 100,000 drug-like molecules: a message-passing neural network for molecular graphs, a transformer-based encoder for SMILES strings, and a multilayer perceptron for physicochemical descriptors, (2) we fuse these student modalities using a novel Finsler geometry-aware module, and (3) distill complementary knowledge from large teacher models, including MiniMol and MolFormer, into a single lightweight model via contrastive learning. We demonstrate that GLACIER is a robust framework that delivers high predictive performance and computational efficiency in complex molecular property prediction tasks. Our code is publicly available at https://github.com/eemokey/glacier.
La chaîne SMILES de l'eau ordinaire s'écrit simplement « O », et celle de l'aspirine « CC(=O)OC1=CC=CC=C1C(=O)O ». En somme, c'est une molécule écrite avec des lettres et des chiffres, comme un mot dans une langue chimique.