Une matrice de confusion est une disposition de tableau spécifique qui permet de visualiser la performance d'un algorithme d'apprentissage supervisé, typiquement un classifieur. Chaque ligne de la matrice représente les instances d'une classe réelle, tandis que chaque colonne représente les instances d'une classe prédite (ou l'inverse). Le nom provient du fait qu'elle permet de voir facilement si le système confond deux classes (c'est-à-dire s'il étiquette couramment l'une comme l'autre).
Histoire
Le terme a été popularisé dans le domaine de l'apprentissage automatique dans les années 1960, bien que le concept de table de contingence en statistiques lui soit antérieur. L'origine exacte reste incertaine.
Comment ça marche
Pour un problème de classification à N classes, la matrice est de taille N×N. Les cellules diagonales indiquent le nombre de prédictions correctes pour chaque classe, tandis que les cellules hors diagonale montrent les erreurs de classification. À partir de ce tableau, on peut dériver des métriques telles que l'exactitude, la précision, le rappel et le score F1. Pour la classification binaire, la matrice est de taille 2×2 avec des entrées généralement appelées vrai positif, faux positif, vrai négatif et faux négatif.
En pratique
Utilisée pour évaluer et comparer les classifieurs dans des domaines comme le diagnostic médical, la détection de courriers indésirables et la reconnaissance d'images, où comprendre les types d'erreurs importe plus que l'exactitude globale.
Anecdote
Une matrice de confusion peut être utilisée pour calculer le coefficient de corrélation de Matthews, qui est une métrique unique résumant l'ensemble de la matrice et souvent plus informative que l'exactitude pour les ensembles de données déséquilibrés.
Quatre vieilles cartes dormaient dans des tiroirs différents. Sur chacune étaient marqués les gènes liés au vieillissement cellulaire, mais les cartes ne concordaient pas : noms différents, échelles différentes, légendes différentes. Le chercheur qui voulait un gène pour son expérience devait les recouper à la main, au risque de laisser passer une annotation importante.
Un radiologue regarde un scanner abdominal et voit non seulement des organes, mais aussi leur disposition mutuelle : quel rein est plus gros, où se trouve la tumeur par rapport au vaisseau. C'est comme lire une carte : il ne suffit pas de savoir où se trouve habituellement une ville, il faut aussi savoir mesurer la distance entre deux points sur le terrain.
Se perdre dans une salle des glaces est un jeu d'enfant : chaque mur reflète l'autre, et l'on croit être déjà passé par là. C'est à peu près ce qui se passe dans le cerveau lorsqu'il y a beaucoup d'endroits similaires autour de soi. Les neurones chargés de la carte spatiale peuvent envoyer le même signal pour deux coins différents d'une pièce.
Dans un entrepôt, des cartons de pommes et de poires. Les pommes sont nombreuses, les poires rares. Mais quand le magasinier dit « un fruit à la peau lisse », nous pensons plus souvent à la poire rare qu'à la pomme fréquente. C'est l'effet de taux de base inversé : un dérèglement persistant dans la façon dont le cerveau résout l'ambiguïté entre les catégories.
Cent mille étoiles dans le noyau dense d’un amas globulaire se déplacent comme des billes d’acier dans un flipper géant. Chaque « choc » — une rencontre gravitationnelle entre un couple binaire et une étoile isolée — déclenche une cascade d’événements imprévisibles.
Un enfant qui explore un appartement inconnu rampe d'un objet à l'autre et mémorise ce qu'il voit depuis chaque coin. C'est ainsi que le cerveau construit une carte mentale — un modèle interne de l'espace. L'algorithme gradCSCG fonctionne sur le même principe : il reçoit un flux vidéo d'une caméra et dessine lui-même le plan du lieu, en s'appuyant uniquement sur le changement des images.
Lorsqu'une étoile géante s'effondre en supernova ou que deux étoiles à neutrons fusionnent dans une danse cosmique, des billions de neutrinos emportent l'énergie du cataclysme.
Un essaim de robots ressemble à une nuée de lucioles : chacun se déplace au hasard « là où c'est plus libre », et le chaos se transforme en ordre. Pendant longtemps, on s'est demandé comment, sans communication ni commandes, naissait cette coordination.
Le microlentillage gravitationnel est un effet cosmique fascinant, prédit par Einstein et développé par Zwicky. Un corps massif, passant entre nous et une étoile lointaine, courbe sa lumière comme une lentille, créant des amplifications et distorsions caractéristiques.
La lumière des galaxies lointaines met des milliards d'années à nous parvenir, mais en chemin, elle est déviée et courbée par la toile invisible de la matière noire. Cet effet, prédit par Einstein dans le cadre de la relativité générale, est appelé lentille gravitationnelle.
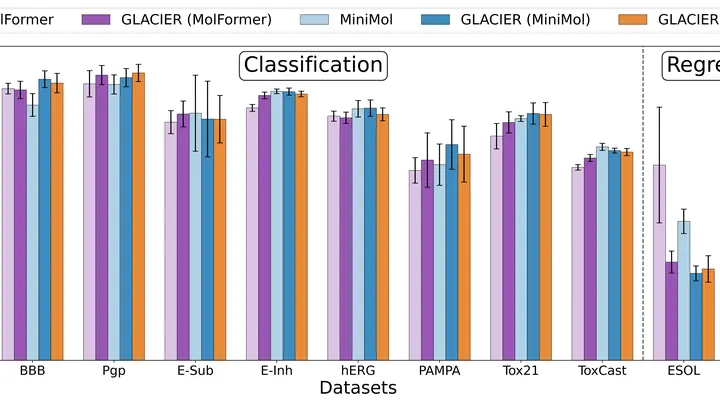
Chercher la bonne molécule parmi des milliards de possibilités, c'est un peu comme chercher un grain de riz dans un sac de riz. Pour ne pas tout éplucher à la main, les chimistes font de plus en plus appel aux réseaux de neurones. Mais les grands modèles exigent des ordinateurs puissants, et les petits manquent souvent de vision d'ensemble.
L'espace-temps est souvent imaginé comme un tissu lisse. Mais à l'échelle microscopique, ce tissu pourrait ne pas être continu, mais constitué d'« atomes » individuels — des événements reliés par la causalité. Cette vision du monde s'appelle la théorie des ensembles causaux.
Vous goûtez un plat au restaurant, mais vous n'avez pas vu le menu. Vous posez des questions au serveur — trop salé ? avec quelles épices ? — et à partir des réponses, vous essayez de deviner quel chef l'a préparé.
Si l'on montre la même photo de chat à deux réseaux de neurones différents, ils arrivent souvent à une conclusion similaire : « chat ». Mais si on leur demande plus de détails, les réponses peuvent diverger. Un modèle remarquera les moustaches, un autre la robe, un troisième la posture.
Un alliage de sept métaux, c'est comme une équipe où chaque joueur tire la couverture à soi. Les atomes de fer, de cobalt, de nickel, d'aluminium, de titane, de tantale et de vanadium peuvent s'aligner en un motif strict, ou bien se disperser au hasard. De cela dépend si le matériau sera résistant comme l'acier ou léger comme l'aluminium.
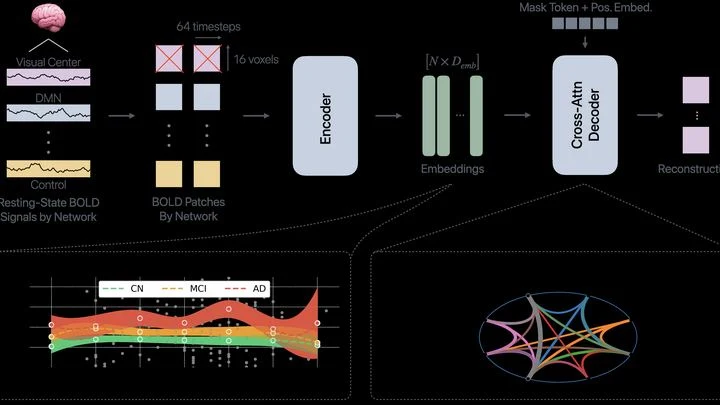
Le cerveau n'est pas un gros ordinateur unique, mais plutôt un orchestre où différents groupes de musiciens jouent leurs partitions. Les réseaux de neurones responsables de la mémoire, de l'attention ou des émotions communiquent constamment. Dans la maladie d'Alzheimer, cet orchestre commence à jouer faux : certains groupes se taisent, d'autres jouent à contretemps.
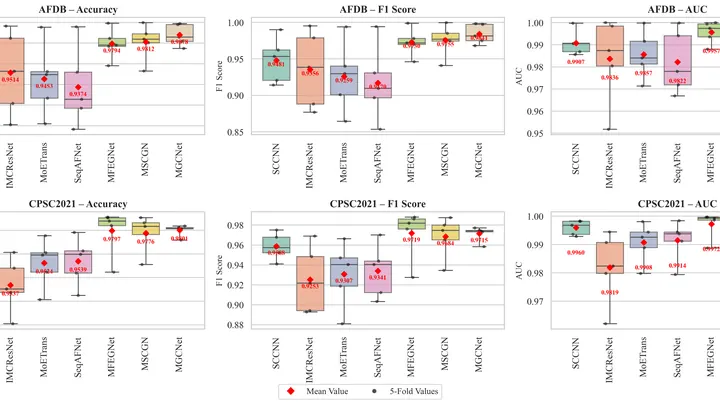
Le cœur ne bat pas comme un métronome, mais comme un batteur de jazz : parfois il déraille, saute des battements, s'emballe. La fibrillation auriculaire est l'un des dérèglements les plus sournois : les oreillettes tremblent au lieu de se contracter, et le sang peut stagner et former des caillots.