Molecular property prediction is a computational method using graph neural networks and AI to estimate material characteristics without laboratory experiments.
La prédiction des propriétés moléculaires est un domaine interdisciplinaire à l'interface de la chimie, de la physique et de l'informatique, où des modèles informatiques sont entraînés sur des données expérimentales pour évaluer les caractéristiques des molécules sans synthèse en laboratoire. Les modèles peuvent être basés sur des lois physiques (mécanique quantique) ou sur l'analyse statistique de grands ensembles de données (apprentissage automatique). Ils prévoient des paramètres tels que la toxicité, l'activité biologique, la solubilité, le point de fusion et même la couleur de la substance.
Histoire
Les racines remontent aux années 1960, lorsque Corwin Hansch formula les relations quantitatives structure-activité (QSAR), en proposant des équations linéaires reliant l'hydrophobicité des substituants à l'activité biologique. Dans les années 1970-80, le développement de l'informatique permit d'inclure des indices de chimie quantique et des descripteurs tridimensionnels. Un tournant s'est produit dans les années 2010 avec l'émergence de l'apprentissage profond et la disponibilité des GPU : les modèles ont appris à « lire » les molécules directement à partir de la structure du graphe, atteignant une grande précision dans la prédiction de la solubilité, de la toxicité et des énergies des états excités. Aujourd'hui, la prédiction des propriétés est une partie intégrante du criblage virtuel en pharmacie et de la conception de nouveaux matériaux.
Comment ça marche
Toute prédiction repose sur la représentation de la molécule dans l'espace des descripteurs ou sous forme de vecteur. Les descripteurs les plus simples sont le nombre d'atomes d'un type donné, la masse moléculaire, la surface. Des descripteurs plus complexes codent l'information sur les cycles, les donneurs/accepteurs de liaisons hydrogène, les charges partielles (calculées, par exemple, par la méthode de Gasteiger). Dans les réseaux de neurones sur graphes, chaque atome reçoit un vecteur de caractéristiques qui est mis à jour itérativement par des messages provenant des atomes voisins ; le vecteur final de la molécule est agrégé et transmis à une couche entièrement connectée qui produit la prédiction. L'entraînement minimise une fonction de perte, par exemple l'erreur quadratique moyenne pour les propriétés continues, ou l'entropie croisée pour la classification. Les lois physiques les plus importantes sur lesquelles s'appuient les méthodes quantiques sont : l'équation de Schrödinger (stationnaire et non stationnaire) et le principe de Pauli (interdiction pour deux fermions d'occuper le même état quantique). Pour les modèles statistiques, la physique n'est pas nécessaire de manière explicite, mais le choix des caractéristiques est souvent motivé par le principe « le semblable attire le semblable » : des molécules similaires ont des propriétés proches. La qualité du modèle est vérifiée sur un échantillon de test à l'aide de métriques (R², RMSE, AUC).
En pratique
Accélère le développement de nouveaux matériaux et médicaments, du plastique biodégradable aux médicaments anticancéreux ciblés.
Anecdote
Les algorithmes modernes peuvent vérifier en quelques secondes des millions de variantes moléculaires pour un nouveau médicament, alors que la synthèse et le test d'une seule molécule en laboratoire prennent des semaines et coûtent des milliers de dollars.
Sur les lieux d'un crime, on trouve une tache. L'expert prélève un écouvillon, et quelques heures plus tard, l'appareil fournit une liste de protéines qui composaient le liquide. Auparavant, un test rapide pouvait se tromper si plusieurs liquides étaient présents : le sang se mélangeait à la salive, et la bandelette donnait un faux résultat.
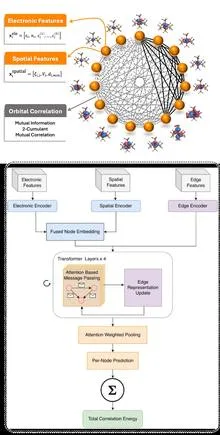
Un cartographe qui ne dessine ni montagnes ni rivières, mais les liens invisibles entre les électrons : c'est ainsi qu'on pourrait décrire ce nouveau réseau de neurones. Au lieu des coordonnées atomiques, il prend les orbitales moléculaires et trace un graphe dont les nœuds sont les orbitales et les arêtes, les mesures de leur intrication quantique.
Une protéine dans une cellule ne reste pas immobile comme un mannequin en vitrine. Ses atomes tremblent, s'étirent et se plient constamment, un peu comme une corde de guitare tendue qui continue de vibrer après qu'on l'a pincée. Pour comprendre comment une protéine fonctionne, il faut savoir à quel point chaque partie est fermement liée à ses voisines.
Une protéine dans une cellule ne reste pas immobile comme un mannequin en vitrine. Ses atomes tremblent, s'étirent et se plient constamment, un peu comme une corde de guitare tendue qui continue de vibrer après qu'on l'a pincée. Pour comprendre comment une protéine fonctionne, il faut savoir à quel point chaque partie est fermement liée à ses voisines.
Un ingénieur en protéines ressemble à un cuisinier qui essaie de préparer un plat à la fois savoureux, sain et économique. En modifiant un ingrédient, il risque d'en gâcher un autre. Autrefois, les assistants informatiques ne pouvaient évaluer les propriétés des protéines qu'individuellement, sans voir comment elles sont liées entre elles.
L'interprète se laisse distraire par le moindre bruit dans la salle, et une réunion d'une heure s'étire sur deux. C'est le même problème pour les modèles de fondation moléculaires : ils apprennent le langage des molécules sur d'immenses corpus, mais chaque nouvelle conversation exige un réglage.
Un ingénieur en protéines ressemble à un cuisinier qui essaie de préparer un plat à la fois savoureux, sain et économique. En modifiant un ingrédient, il risque d'en gâcher un autre. Autrefois, les assistants informatiques ne pouvaient évaluer les propriétés des protéines qu'individuellement, sans voir comment elles sont liées entre elles.
La recherche d'un nouveau matériau ressemble à la cuisine sans recette : on essaie, on essaie, et souvent on jette. Avant, les scientifiques feuilletaient les articles à la main et testaient les compositions une par une. Maintenant, un « robot-cuisinier » est apparu, qui lit lui-même la littérature, mélange les composants et regarde ce que ça donne.
L'appareil éclaire l'échantillon avec un faisceau infrarouge, et les molécules répondent par leur motif d'absorption — comme des clochettes de tons différents. Ce motif, le spectre, contient des informations sur la composition chimique.
L'appareil éclaire l'échantillon avec un faisceau infrarouge, et les molécules répondent par leur motif d'absorption — comme des clochettes de tons différents. Ce motif, le spectre, contient des informations sur la composition chimique.
Dans une casserole d'eau flottent des billes microscopiques — des particules colloïdales. Chaque bille est recouverte de longs filaments polymères, semblables à une brosse, et porte une charge électrique. Si l'on choisit correctement la température et la composition de la solution, les billes commencent d'elles-mêmes à s'organiser en motifs ordonnés — des cristaux.
Un ordinateur classique calcule en faisant circuler des charges électriques dans des fils. Mais peut-on calculer avec la chaleur ? Un réseau de tubes parcourus par de l'eau chaude et froide peut effectuer des opérations logiques simples si l'on connecte les tubes dans le bon ordre.
Quand le sucre tombe dans le thé, il se dissout. Mais pourquoi ne retombe-t-il pas au fond ? Tout est une question de potentiel chimique — une grandeur qui indique à quel point il est « avantageux » pour une substance de se trouver à un endroit et dans un état donnés. Pour une substance pure, c'est facile à calculer, mais pour un mélange de plusieurs composants, c'est un vrai casse-tête.
Quand le sucre tombe dans le thé, il se dissout. Mais pourquoi ne retombe-t-il pas au fond ? Tout est une question de potentiel chimique — une grandeur qui indique à quel point il est « avantageux » pour une substance de se trouver à un endroit et dans un état donnés. Pour une substance pure, c'est facile à calculer, mais pour un mélange de plusieurs composants, c'est un vrai casse-tête.
Un livre de recettes sans liste de courses, voilà ce que découvre un scientifique face à un schéma de réactions chimiques. Les flèches et les formules sur le papier semblent cohérentes, mais dès qu'on cherche en laboratoire des molécules qui se comporteront exactement comme prévu, la véritable chasse au trésor commence.
Un livre de recettes sans liste de courses, voilà ce que découvre un scientifique face à un schéma de réactions chimiques. Les flèches et les formules sur le papier semblent cohérentes, mais dès qu'on cherche en laboratoire des molécules qui se comporteront exactement comme prévu, la véritable chasse au trésor commence.
Dans chaque cellule, des rencontres et des séparations ont lieu en permanence. Certaines paires tiennent solidement, comme un scratch, d'autres se touchent à peine, comme du pollen porté par le vent.
Prédire le rendement d'une réaction chimique, c'est un peu comme essayer de deviner la récolte en ne connaissant que la composition du sol. Traditionnellement, les chimistes s'appuyaient sur de longues colonnes de nombres – les descripteurs quantiques – qui décrivent l'énergie des électrons mais restent muets sur la forme de la molécule.
Prédire le rendement d'une réaction chimique, c'est un peu comme essayer de deviner la récolte en ne connaissant que la composition du sol. Traditionnellement, les chimistes s'appuyaient sur de longues colonnes de nombres – les descripteurs quantiques – qui décrivent l'énergie des électrons mais restent muets sur la forme de la molécule.
Une molécule polaire ressemble à un minuscule haltère avec des charges différentes à ses extrémités. En général, ces particules se collent ou se dispersent rapidement lors d'une rencontre — les forces électriques sont trop fortes. Mais les auteurs de l'étude ont trouvé un moyen de transformer cette agressivité en un jeu contrôlé.
Une protéine dans la cellule n'est pas une pièce rigide, mais plutôt un gant souple qui peut saisir différents objets. Jusqu'ici, les concepteurs de protéines travaillaient comme des sculpteurs, créant une clé pour une seule serrure : une cible, une forme.
À l'intérieur de chaque cellule, la logistique bat son plein : de minuscules moteurs protéiques, tels des coursiers, transportent des cargaisons le long d'un réseau de microtubules. L'un des principaux travailleurs est la kinésine, qui avance grâce à l'énergie de l'ATP (la principale monnaie énergétique de la cellule).
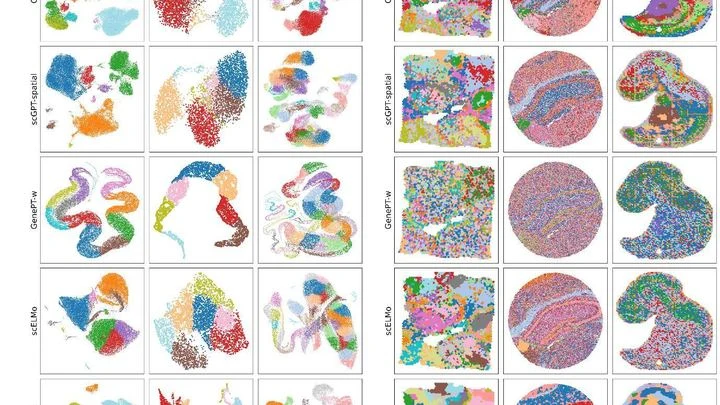
Les biologistes confient de plus en plus aux ordinateurs la lecture des « modes d'emploi » de la cellule vivante. Six modèles récents d'intelligence artificielle — Nicheformer, CellPLM, scGPT-spatial, GenePT, scELMo et Novae — sont comme six traducteurs de dialectes différents d'un même langage cellulaire.
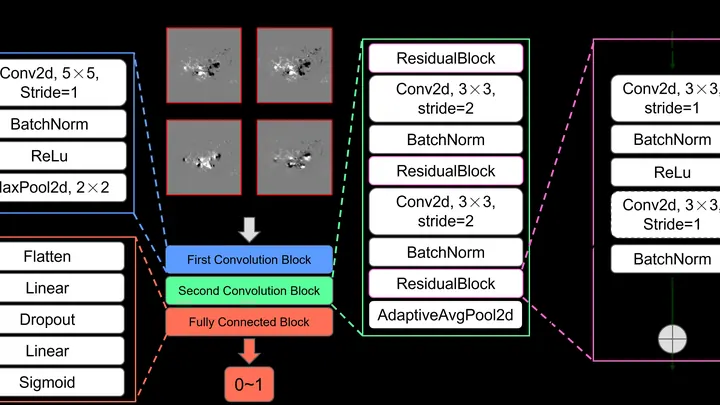
Le Soleil trace continuellement des gribouillis de champs magnétiques à sa surface. Ces motifs ne sont pas de simples ondulations, mais une écriture dans laquelle la nature a crypté des avertissements d'éruptions.
Une immense bibliothèque où chaque livre est une instruction précise pour assembler une molécule de protéine. Le réseau de neurones AlphaFold2 a lu des millions de ces livres et a appris à fournir instantanément un modèle tridimensionnel prêt à l'emploi.
L'intelligence artificielle qui prédit l'acoustique d'une salle fait penser à un étudiant qui triche à l'examen avec une antisèche. Si les points de validation sont les mêmes que ceux de l'entraînement, le modèle se contente de mémoriser l'« empreinte » sonore de chaque position, comme un étudiant qui reconnaît un sujet grâce à un coin de page plié.
Un groupe de recherche ratisse un champ brumeux. Au début, les gens s'écartent largement : une « température » de recherche élevée signifie une grande diversité de tentatives. Ayant repéré une piste, ils se rapprochent. Mais la vitesse de rapprochement est cruciale — si l'on resserre le cercle trop tôt, la meilleure trouvaille restera de côté.
Dans une soupe bouillonnante, les molécules entrent en collision de manière chaotique et réagissent. Mais si l'on mesure comment leurs concentrations varient, des régularités apparaissent.
Dans une casserole de soupe, deux thermomètres suffisent pour connaître la température partout — à condition de savoir que la chaleur se propage en cercles depuis le fond. De même en science : à partir de mesures éparses, il faut reconstruire l'image complète du champ thermique.
Imaginez un conducteur sur une route verglacée : il ne connaît pas la réaction exacte de sa voiture aux mouvements du volant et doit apprendre en conduisant, en gardant intuitivement une marge de manœuvre pour une éventuelle erreur. C'est ainsi que fonctionne un algorithme de contrôle adaptatif.
Lorsqu'une étoile géante s'effondre en supernova ou que deux étoiles à neutrons fusionnent dans une danse cosmique, des billions de neutrinos emportent l'énergie du cataclysme.
La préparation d'un plat complexe exige une recette claire : d'abord couper, puis faire revenir, ajouter les épices au bon moment. Les transformations chimiques suivent aussi des recettes pas à pas — des mécanismes où les atomes de carbone et d'hydrogène se réarrangent strictement dans l'ordre.
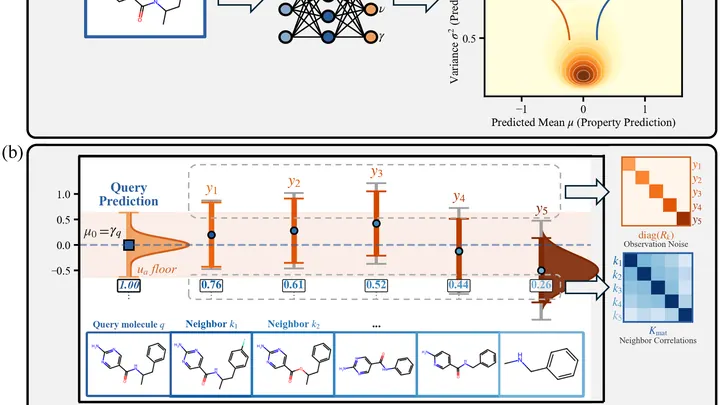
Prédire les propriétés d'une nouvelle molécule, c'est un peu comme deviner le goût d'un plat inconnu. Le programme agit comme un chef expérimenté : il « goûte » des molécules similaires dont les propriétés sont déjà connues et, en se basant sur leur « saveur », affine son estimation.
Les machines complexes — des drones aux robots chirurgiens — se comportent parfois comme un mustang sauvage : pleines de désordre et de caprices, où un léger contact déclenche une tempête. Plutôt que de mémoriser des formules, la nouvelle méthode observe le système, tel un dresseur.
Un détective expérimenté ne calcule pas la trajectoire d'un criminel selon les lois de la physique — il consulte sa bibliothèque d'affaires similaires.
Le microscope électronique est un orgue géant : au lieu des tuyaux, des lentilles électromagnétiques ; au lieu de l'air, un flux d'électrons accélérés. Autrefois, il ne faisait que dessiner des fresques muettes du monde atomique, condamnant les scientifiques à un déchiffrage épuisant.
Plongez votre regard dans le ciel nocturne : ce n'est pas un semis d'étoiles, mais un manuscrit à plusieurs couches. Sous l'encre brillante des étoiles et des galaxies transparaît un texte pâle, presque effacé.
Vous recevez un rapport : une « lettre » a été remplacée dans votre gène. Mais qu'est-ce que cela change ? Une protéine n'est pas une ligne plate, c'est une pelote dense où chaque boucle a sa place dans un creux. Un remplacement au cœur de cette pelote, c'est comme une fissure dans les fondations ; à la surface, c'est une égratignure sur la façade.
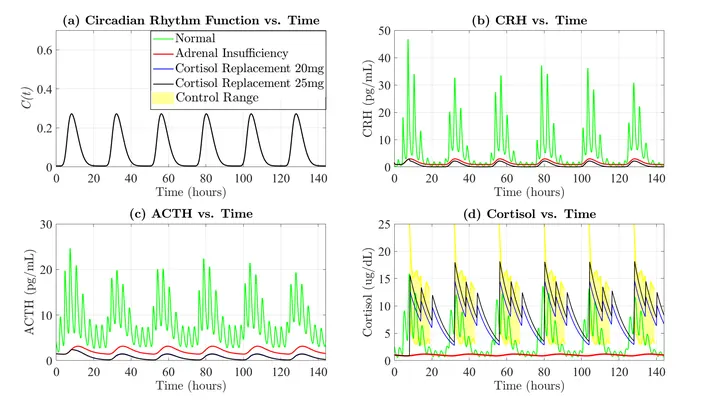
En chacun de nous, une horloge invisible fait tic-tac. Elle commande la libération de cortisol, l'hormone qui nous aide à nous réveiller le matin, à gérer l'anxiété et à maintenir le système immunitaire en alerte. En cas d'insuffisance surrénalienne, cette horloge se dérègle : le corps ne peut plus produire lui-même la quantité de cortisol nécessaire.
Les pérovskites hybrides sont les étoiles montantes de la photovoltaïque : leur efficacité progresse si vite qu'on croirait être au seuil d'une révolution solaire. Mais ces matériaux, véritables mosaïques d'atomes, sont extrêmement fragiles : l'humidité, la chaleur et la lumière les réduisent rapidement en poussière.