Un scanner médical 3D qui apprend à tout voir d'un coup express
Pour rendre la forme d'une statue dans ses moindres détails, on peut la découper en des millions de petits cubes et décrire chacun d'eux — c'est long, pénible, et la mémoire de l'ordinateur craque de toutes parts. C'est exactement ainsi que l'on traite habituellement les images médicales 3D : un scanner ou une IRM est un énorme tableau de ces cubes (voxels), et pour créer ou améliorer une image, la machine doit tous les traiter.
La nouvelle approche rappelle le travail d'un sculpteur qui ne modèle pas morceau par morceau, mais qui définit des courbes douces par une seule ligne mathématique. Les auteurs ont créé un système où tout le volume — foie, cerveau ou poumons — est décrit comme une fonction continue des coordonnées. Il suffit d'introduire trois nombres (x, y, z) dans la formule, et le modèle indique la densité du tissu à cet endroit. Le cœur de la méthode est un autoencodeur compact : il comprime d'abord l'image en un petit ensemble de caractéristiques clés (comme un résumé de cours), puis la reconstruit, mais cette fois comme un objet continu. Cette astuce permet d'éviter le découpage en morceaux qui se chevauchent, qui était auparavant inévitable.
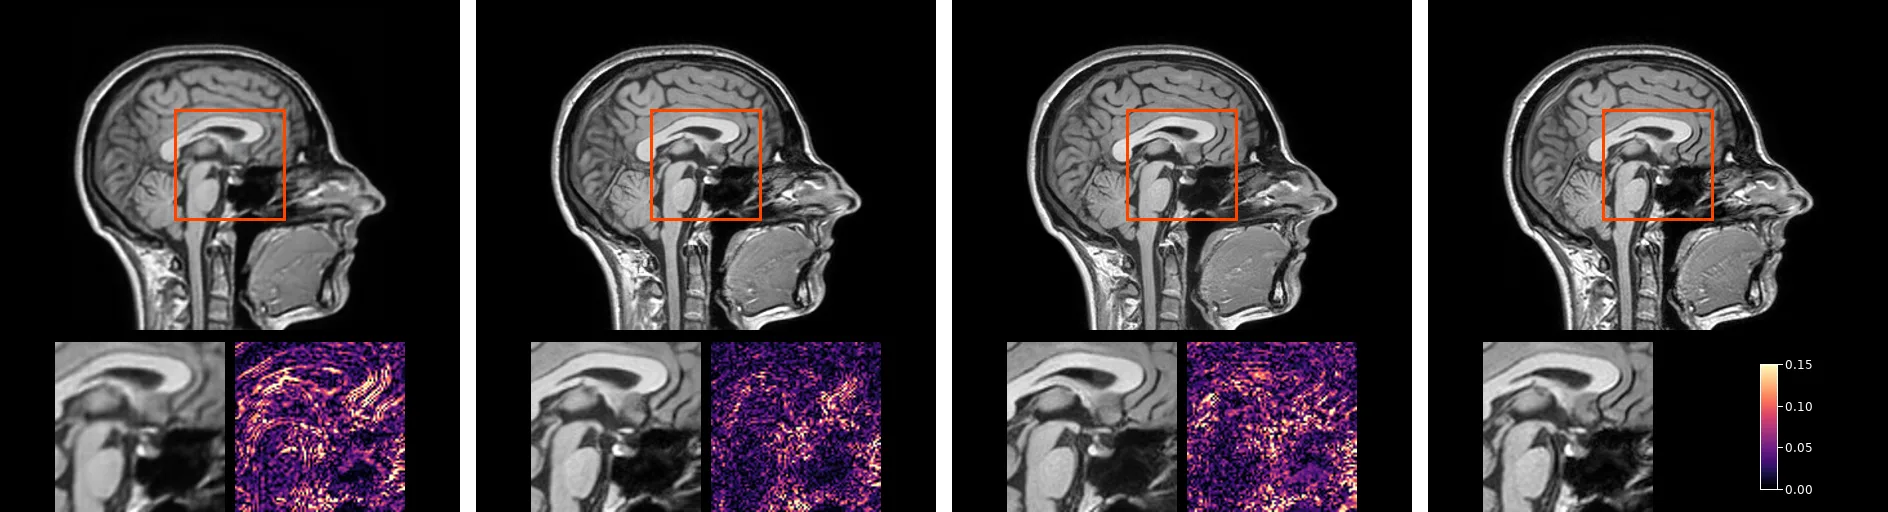
L'utilité pratique se voit immédiatement dans deux scénarios. Le premier est la création d'images 3D synthétiques mais anatomiquement plausibles pour la formation des médecins ou des algorithmes. Le second est la reconstruction d'une image de qualité à partir de données incomplètes. Par exemple, en IRM accélérée, l'appareil effectue moins de mesures pour que le patient reste moins longtemps dans le tube, et le modèle complète ce qui manque en s'appuyant sur une anatomie « continue » apprise. Et tout cela sur une seule carte graphique ordinaire, sans assembler l'image à partir de morceaux avec des coutures visibles.
Bien sûr, la reconstruction directe pixel par pixel est encore un peu plus précise dans les détails. Mais le gain en vitesse et en intégrité de l'image est un compromis qui ouvre la voie au traitement d'images 3D haute résolution dans la pratique clinique courante, sans attendre les supercalculateurs. Et alors, la statue, autrefois assemblée cube par cube, retrouvera enfin des contours lisses et vivants.
Résumé original
tel que rédigé par les auteurs, en anglais arXiv:2607.16491
High-resolution three-dimensional (3-D) medical diffusion models remain constrained by the cost of processing full volumes, even when denoising is performed in a compact latent space. We introduce a continuous 3-D latent diffusion model (LDM) framework for computed tomography (CT) and magnetic resonance imaging (MRI) generation and measurement-guided reconstruction. Its central component is a compact autoencoder (AE) with a coordinate-conditioned local implicit image function (LIIF) decoder that represents a volume as a continuous function of spatial coordinates. By evaluating the convolutional decoder once on the latent grid and restricting repeated computation to a lightweight implicit head, the proposed design avoids overlapping sub-volume decoding while remaining differentiable for inverse-problem optimization. We evaluate the framework on CT volumes of 512^3 voxels and MRI volumes of 256^3 voxels. On high-resolution CT, the proposed AE is approximately x12-32 faster than the evaluated reference autoencoders, achieves the lowest peak graphics processing unit (GPU) memory use, and retains comparable structural fidelity despite a moderate reduction in voxel-level accuracy. The resulting frozen 3-D latent prior generates coherent full volumes without visible patch seams and can be applied, without task-specific retraining, to sparse-view CT and accelerated MRI reconstruction through hard data consistency. Although direct pixel-domain reconstruction remains more accurate, the results demonstrate that a single volumetric latent prior can support both unconditional generation and measurement-conditioned reconstruction on one GPU. Overall, the framework provides a practical trade-off between continuous volumetric decoding, computational efficiency, and fine-detail preservation. Our code will be made available at https://github.com/mellak/.
La taille d'une image de scanner typique en haute résolution (512×512×512 voxels) est comparable à 134 millions de pixels — soit environ 17 images au format 4K, empilées dans un seul cube.
Dans le film « Total Recall », le héros interprété par Arnold Schwarzenegger passe à travers un scanner qui crée instantanément une empreinte holographique 3D du corps — le nouveau modèle fait un pas vers une telle reconstruction qui deviendrait une routine, et non plus de la science-fiction.