Les modèles de diffusion sont une approche générative qui transforme le bruit gaussien en données ordonnées, par exemple une photographie de chat. Le processus rappelle la restauration d’une mosaïque de mémoire : vous n’avez qu’un schéma approximatif, mais vous vous souvenez à quoi ressemblaient des œuvres similaires, et vous recréez progressivement le motif — des taches floues aux lignes fines. Le modèle contient une « représentation » du monde, apprise sur des millions d’exemples, et peut donc générer de nouvelles images plausibles. La principale différence avec les autres réseaux génératifs est l’itérativité : l’image ne naît pas instantanément, mais à travers une chaîne de petites améliorations.
Histoire
Les racines de la méthode remontent aux travaux en thermodynamique et en physiquestatistique (par exemple, les travaux de Langevin), mais l’incarnation moderne a été proposée en 2015 par Jascha Sohl-Dickstein comme un modèle génératif stochastique basé sur la thermodynamique hors équilibre. La percée s’est produite après la publication en 2020 de l’article « Denoising Diffusion Probabilistic Models », qui a démontré des résultats exceptionnels sur les tâches de synthèse d’images. Les améliorations ultérieures (échantillonnage accéléré, contrôle conditionnel) ont conduit à la création de systèmes tels que DALL-E 2, Imagen, Stable Diffusion, qui ont révolutionné le domaine de la créativité par IA.
Comment ça marche
Processus direct : à l’image originale x0, on ajoute de petites quantités de bruit gaussien pendant T étapes, obtenant ainsi une séquence x1, x2, ..., xT, où xT est pratiquement indiscernable d’un bruit blanc. La transition à chaque étape est : q(xt|xt-1) = N(xt; sqrt(1-βt)·xt-1, βtI), où βt est le plan de variance. Processus inverse : le réseau de neurones εθ(xt, t) apprend à prédire le bruit ajouté à l’étape t, en minimisant E[||ε - εθ(xt, t)||²]. Pendant la génération, on part de xT ~ N(0, I) et on applique itérativement xt-1 = (1/√(αt))·(xt - (1-αt)/√(1-ᾱt)·εθ(xt, t)) + σt·z, où z est un bruit. Pour accélérer l’échantillonnage, on utilise DDIM (Denoising Diffusion Implicit Models) avec saut d’étapes. Les modèles conditionnels ajoutent à l’entrée des informations sur le texte, la classe, etc., guidant le processus inverse.
En pratique
Génération de photographies à partir de descriptions textuelles, amélioration des images télescopiques, conception de nouveaux matériaux.
Anecdote
Bien que la diffusion semble lente, les versions modernes créent une image en seulement une demi-seconde sur une puce graphique puissante.
La lumière qui n'atteint pas la caméra laisse pourtant sa trace sur elle. C'est ainsi que fonctionne la nouvelle méthode de prise de vue : on éclaire l'objet avec une couleur, et l'image est assemblée à partir d'une autre. Dans le cristal, les ondes lumineuses se mélangent, et l'information sur l'invisible passe au faisceau visible.
Sous un microscope électronique, une protéine apparaît comme une série d'ombres floues — des centaines de milliers de clichés de la même molécule, mais sous des angles différents et avec un fort bruit.
Attraper la lumière particule par particule, c'est comme entendre un murmure dans un atelier assourdissant. La caméra à multiplication d'électrons (EMCCD) en est capable : un photon unique qui atteint un pixel est transformé en avalanche d'électrons, mesurable ensuite.
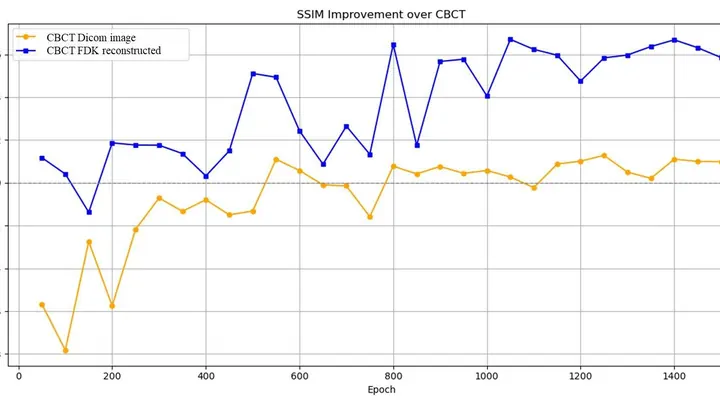
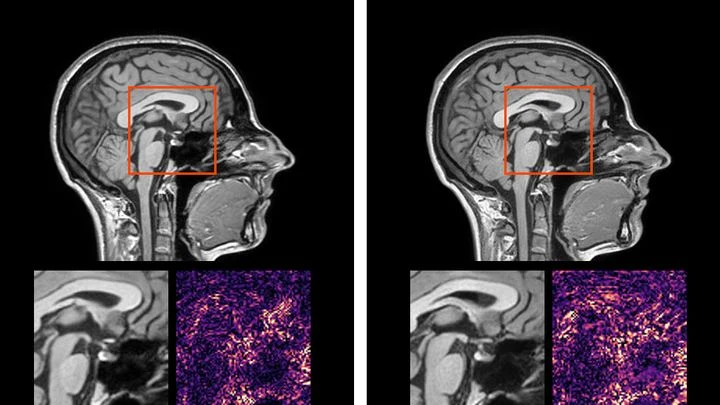
Une image obtenue avec une faible dose de rayons X ressemble à une vue à travers une vitre embuée : les contours sont là, mais les détails se noient dans un voile trouble. Les médecins ont besoin de ces clichés pendant la radiothérapie – pour viser précisément la tumeur et épargner les tissus sains.
Un caillot grossit comme une boule de neige qui dévale une pente : d'abord petit, il accroche de nouvelles couches, et le moment où il se transforme en avalanche est difficile à deviner. Dans le sang, une longue chaîne de réactions se déclenche — la cascade de coagulation — où une substance en éveille une autre, et le caillot prend de la masse.
Un réseau de neurones prédit l'avenir d'un système — par exemple, comment le plasma va tourbillonner dans un champ magnétique ou comment un visage va changer dans une vidéo. Les erreurs sont inévitables, et plus il regarde loin, plus elles s'accumulent.
Le cerveau ne se contente pas de réagir au monde – il ne cesse de deviner ce qui va se passer l'instant d'après. Ce principe porte le nom de codage prédictif : les neurones comparent leurs attentes à la réalité et mettent à jour leur représentation interne lorsqu'une erreur survient. Mais comment un système aussi complexe peut-il être organisé dans le tissu vivant du cortex ?
Un bac de sable mouillé. Vous appuyez dans un coin — et l'eau se met en mouvement. Mais comment exactement ? Au lieu d'un cercle régulier, elle peut s'étaler en langues, s'attarder longtemps à certains endroits et filer rapidement à travers d'autres.
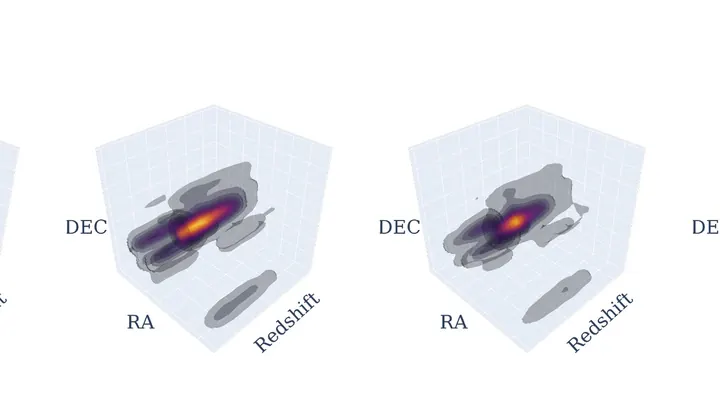
Le cosmos ressemble à un tissu de soie dont les fils de la toile sombre émergent. Les véritables toiles, nous ne les voyons qu'en minuscules lambeaux — à travers les télescopes, dans les catalogues réels de galaxie.
La rivière nocturne est parsemée d'infimes étincelles. Ce n'est pas du plancton, mais un pollen-capteur fonctionnel : un appareil millimétrique qui flotte seul et mesure lui-même la chimie de l'eau.
Chaque particule est un petit laboratoire.
Pour rendre la forme d'une statue dans ses moindres détails, on peut la découper en des millions de petits cubes et décrire chacun d'eux — c'est long, pénible, et la mémoire de l'ordinateur craque de toutes parts.
WanSong crée de la musique comme un sculpteur taille une statue : il part d'un bruit semblable au grondement d'une cascade et retire progressivement tout ce qui est superflu, jusqu'à ce que des notes pures et des voix émergent. Cette méthode — la diffusion d'entropie — transforme le chaos en ordre, un peu comme l'encre se disperse dans l'eau, mais en sens inverse.
Contrairement aux caméras classiques, les caméras événementielles ne capturent que les instants où la lumière devient plus vive ou plus faible. Elles ne produisent pas de photos, mais émettent un flux incessant de ces scintillements. Les scientifiques ont transformé ce flux en une image nette de la Terre, en survolant celle-ci à bord d'un satellite.
Les données d'un seul scan CT équivalent à plusieurs longs métrages. TCAM-Diff contourne ce goulot d'étranglement : le programme compresse la vue tridimensionnelle en trois projections d'ombre, un peu comme un sculpteur qui reconstituerait une statue à partir de ses silhouettes sur trois murs.
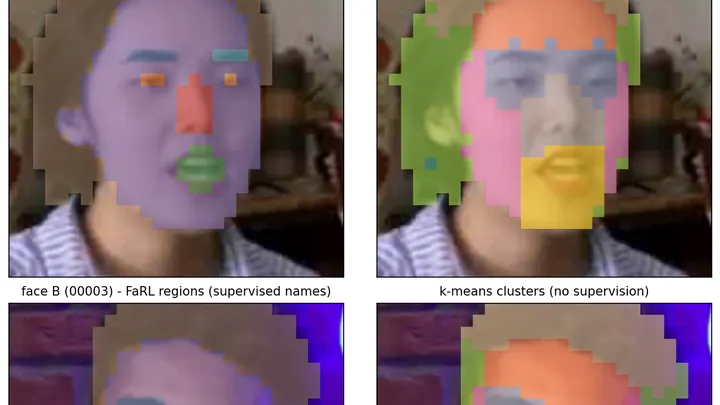
Entraîné sur des photos ordinaires, le modèle DINOv3 s'est mis à voir les visages comme un spectre : tout seul, sans indications, il distingue les zones des yeux, du nez, de la bouche.
Dans une pièce bruyante, l'humain distingue la voix recherchée grâce à ses deux oreilles, qui perçoivent une différence dans l'arrivée du son. Un ordinateur équipé de plusieurs microphones agit de la même manière : il reçoit des indices spatiaux — d'où vient chaque voix.
Un réseau neuronal qui génère des sons à partir de texte, c'est un peu comme une cuisine où chaque « plat » est préparé par des dizaines de cuisiniers. Beaucoup ne font que gêner : ils envoient des signaux erronés et gaspillent des ressources.
Le microlentillage gravitationnel est un effet cosmique fascinant, prédit par Einstein et développé par Zwicky. Un corps massif, passant entre nous et une étoile lointaine, courbe sa lumière comme une lentille, créant des amplifications et distorsions caractéristiques.
Une protéine dans la cellule n'est pas une sculpture figée. Elle bouge sans cesse : elle se plie, respire, tremble. Ce mouvement, que l'on appelle dynamique, détermine le fonctionnement de la protéine. Mais observer cette danse directement est difficile, et la modélisation informatique exige souvent d'énormes puissances de calcul.
La lumière des galaxies lointaines met des milliards d'années à nous parvenir, mais en chemin, elle est déviée et courbée par la toile invisible de la matière noire. Cet effet, prédit par Einstein dans le cadre de la relativité générale, est appelé lentille gravitationnelle.
Un élève qui a passé des années à résoudre des problèmes tirés de manuels d'autrui reçoit soudain trois cahiers contenant de véritables observations de l'océan. Les problèmes sont rares, mais il a déjà vu des centaines de cas similaires, et il lui suffit de quelques exemples pour saisir la manière de faire de son nouveau professeur.
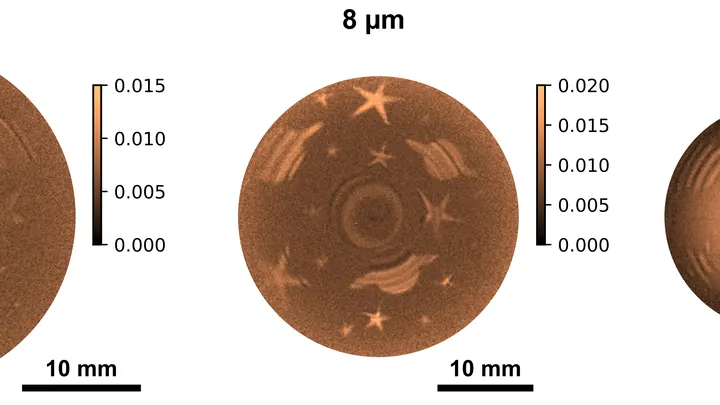
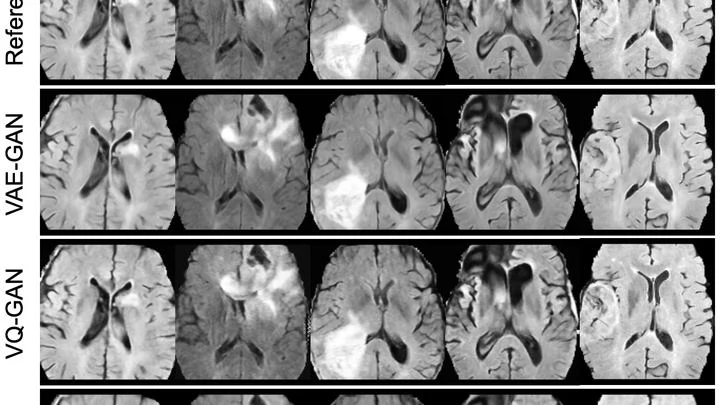
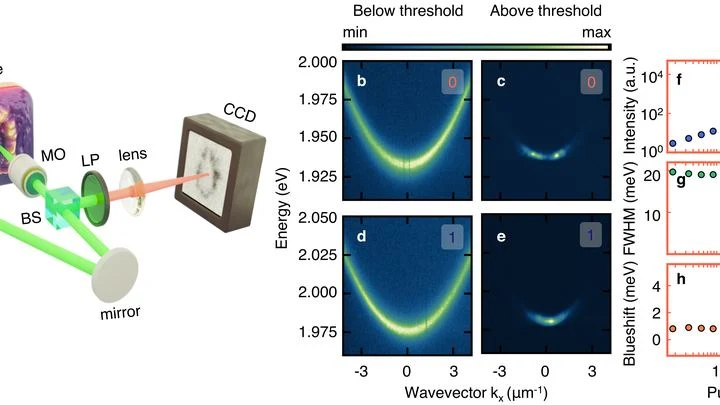
Les réseaux de neurones génératifs qui créent des images s'appuient généralement sur le hasard numérique. Mais une équipe de chercheurs a construit un système où le hasard naît non pas dans le code, mais dans une minuscule cavité optique contenant un colorant organique.
Un photocatalyseur est une poudre qui, plongée dans l'eau et exposée à la lumière, la décompose en bulles d'hydrogène et d'oxygène. Le matériau le plus courant pour cela est le dioxyde de titane, ce pigment blanc que l'on retrouve dans les peintures et le dentifrice.
À travers les ondulations de l'eau, les galets au fond d'une piscine semblent décalés et déformés. De la même manière, la gravité de la matière noire invisible courbe la lumière des galaxies lointaines — un phénomène appelé lentille gravitationnelle faible.
Dans une grande salle d'audience, une réunion est en cours. Des centaines de neurones-interprètes entendent simultanément des bribes de phrases — et doivent en assembler une image cohérente. C'est exactement ainsi que les grands réseaux du cerveau transforment des signaux disparates provenant des yeux en une image unifiée d'un objet.
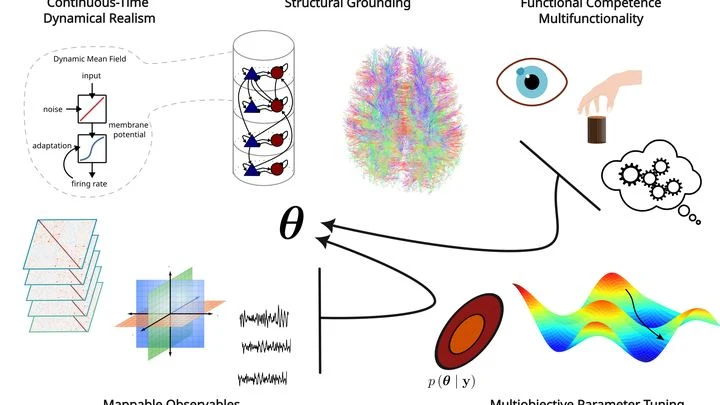
Des ingénieurs construisent une voiture. Les uns assemblent une réplique exacte du moteur, chaque piston et chaque bougie, mais la voiture ne roule pas — pas de volant ni de roues. D'autres créent un kart rapide et autonome, mais son moteur en pâte à modeler ne ressemble pas à un vrai. C'est à peu près la situation dans la science du cerveau.
Un peintre fait un portrait coup de pinceau après coup de pinceau, puis on lui propose un appareil photo avec flash : un clic, et c'est fait. C'est à peu près la transition entre les modèles multi-étapes et les modèles en une étape pour la création d'images de galaxies.
Une mosaïque de grandes tuiles colorées. Chaque tuile représente la quantité moyenne de précipitations sur un mois entier, sur un territoire de la taille d'un petit pays. Pour une compréhension globale, l'image est acceptable, mais si l'on veut savoir si un déluge est passé hier sur une ville précise, elle est inutile.
Toute mesure de lumière se heurte à une limite fondamentale : les photons arrivent sur le capteur de la caméra de manière irrégulière. Cette ondulation naturelle (bruit de grenaille) brouille les détails fins — comme si vous tentiez de distinguer un instrument discret dans un orchestre à travers le bruit de la salle.
Une goutte d'encre dans un verre d'eau se disperse rapidement et uniformément. Mais si l'eau est emprisonnée entre des billes densément tassées, le nuage d'encre rampe lentement et de manière capricieuse — il contourne les obstacles, se coince dans les goulots étroits. C'est à peu près ainsi que se déplacent les molécules d'eau dans les tissus vivants.
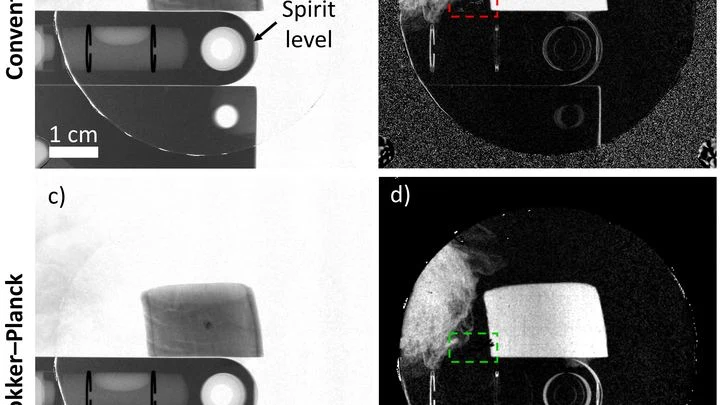
Un appareil de radiographie à grilles ne prend pas une, mais trois photos d'un coup : un cliché classique, une carte des courbures invisibles du faisceau et une image des structures minuscules qui diffusent la lumière. Ensemble, elles aident à repérer, par exemple, l'emphysème ou la fibrose pulmonaire. Mais il y a un hic : pour séparer ces trois couches, il faut une astuce mathématique.
Imaginez une rivière qui ne coule pas dans un lit ouvert mais à l'intérieur d'une éponge, avec un courant qui change d'un endroit à l'autre : c'est un peu le système glymphatique du cerveau. C'est un réseau de canaux minuscules autour des vaisseaux sanguins, dans lequel le liquide céphalo-rachidien s'infiltre en profondeur dans les tissus et emporte les déchets accumulés pendant la journée.
On goûte un smoothie aux fruits avec deux pailles différentes. L'une ne laisse passer que les gros morceaux, l'autre que le liquide. Pris séparément, les sensations sont trompeuses, mais ensemble, elles donnent la clé : tiens, on dirait de la banane, et là, de la fraise.
La lumière, en traversant un milieu trouble comme le lait ou un tissu vivant, se diffuse dans toutes les directions. Reconstruire où la lumière a été absorbée plus fortement, c'est comme deviner la forme d'un objet tombé à partir de la flaque qu'il a laissée sur le trottoir.
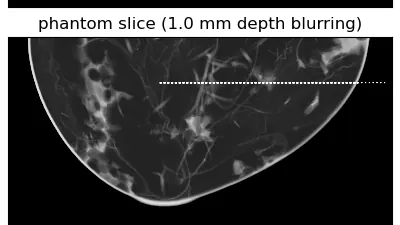
L'appareil de radiographie contourne le sein en arc de cercle et prend plusieurs clichés sous différents angles. À partir de ces images planes, l'ordinateur reconstitue une image en volume, un peu comme on assemble les pièces d'une mosaïque pour former un tout. Mais si les pièces de la mosaïque sont froissées ou tachées, l'image finale est floue.
Former un modèle aérodynamique précis, c'est un peu comme la cuisine : d'abord, le chef apprend des centaines de recettes pour saisir les principes généraux, puis il perfectionne facilement un plat particulier.
Une caméra ordinaire capte la lumière réfléchie par les objets et en construit une image. Mais si l'objet est caché derrière un obstacle ou ne réfléchit pas la lumière, les ondes radio viennent à la rescousse : elles traversent les murs et le brouillard, et l'ordinateur reconstruit l'image à partir des signaux diffusés.
Un laser, qui d'ordinaire émet un faisceau régulier, se met à trembler près du seuil d'émission, comme une corde qui vibre avant de produire un son. Ces tremblements ne sont pas un défaut, mais du bruit quantique : les atomes à l'intérieur du laser émettent de la lumière de manière aléatoire, sans aucune cause externe.
L'eau d'une rivière contourne les pierres, l'air épouse l'aile d'un avion : ces mouvements sont décrits par des équations difficiles à résoudre même sur un ordinateur puissant. Les réseaux de neurones savent approximer ces solutions, mais ils se trompent souvent lorsque les données ne sont collectées qu'en quelques points ou sont bruitées. La raison ?