Тензорная авторегрессия: как сжать климат до нескольких чисел и не потерять смысл ✛
Контекст
Климатологи десятилетиями следят за Эль-Ниньо, но точное расположение его «бассейна» в экваториальной части Тихого океана остаётся предметом споров. Данные о температуре океана представляют собой тензор (трёхмерный массив) размером 51×41×7, где каждый срез соответствует долготе, широте и глубине. Прямая авторегрессия потребовала бы оценить 14637² параметров, что невозможно при 503 наблюдениях. Существующие подходы на основе разложения Таккера дают интерпретацию, но теряют эффективность при высоком порядке тензора, а CP-разложение эффективно, но лишено чёткой статистической интерпретации. Работа стоит на стыке методов снижения размерности и анализа временных рядов, рядом с исследованиями по крупномасштабной структуре Вселенной и машинному обучению, но отличается фокусом на тензорной авторегрессии с контролируемым факторным моделированием.
Методы
Авторы используют CP-разложение (каноническое полиадическое) для извлечения признаков из тензора отклика и тензора ковариат по отдельности, а затем строят линейную регрессию между полученными признаками. Коэффициентный тензор авторегрессии представляется в виде произведения матриц нагрузок, что даёт низкоранговую структуру. Для учёта неоднородных сигналов добавляется разреженный тензор, позволяющий улавливать локальные аномалии. Оценка параметров выполняется методом наименьших квадратов с чередующимся алгоритмом (ALS), где на каждом шаге решается стандартная линейная регрессия. Для выбора гиперпараметров используется отложенная выборка и скользящий прогноз.
Результаты
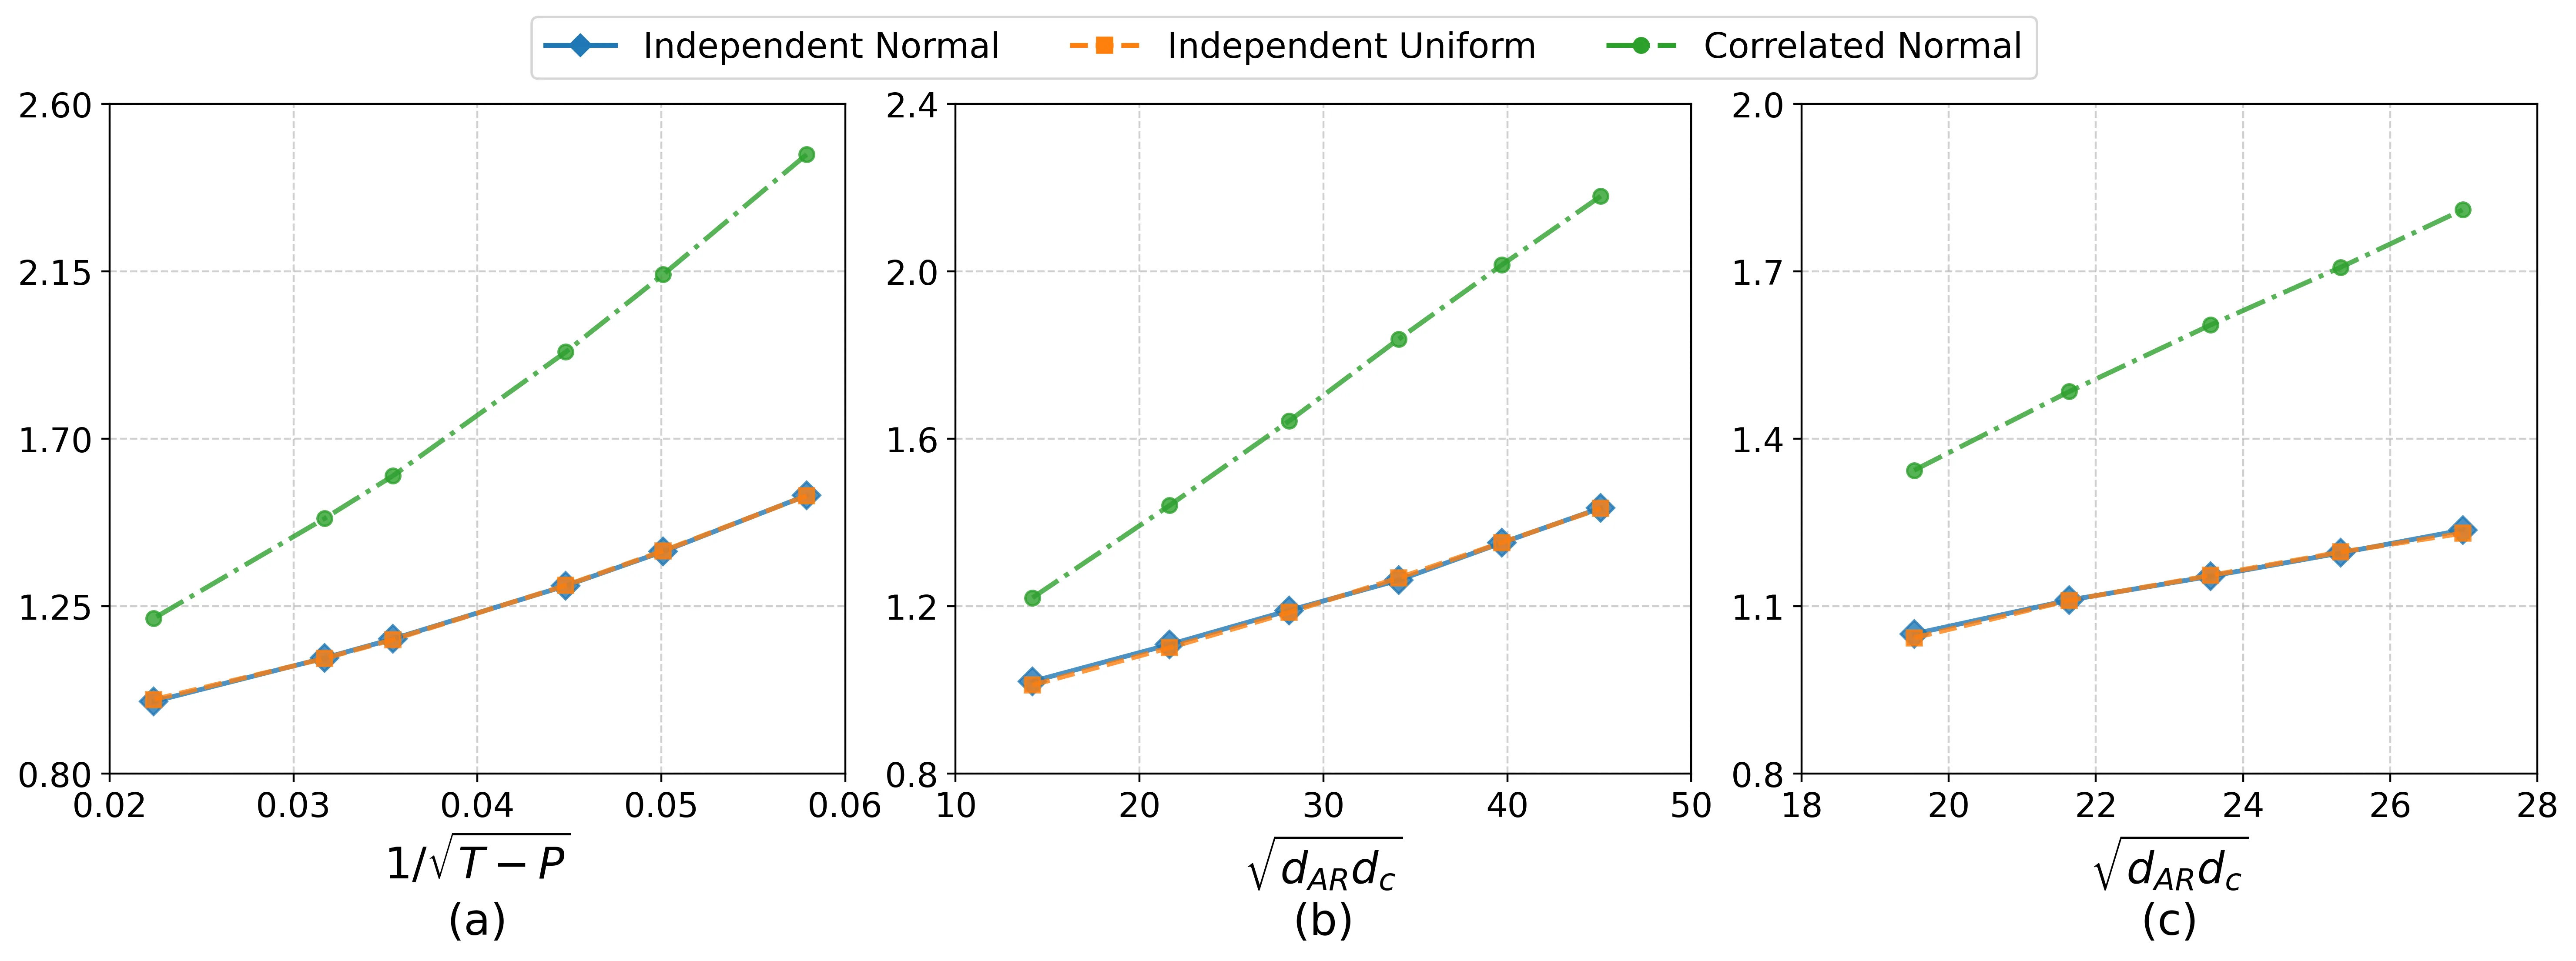
Модель с низкоранговой и разреженной компонентами достигла наименьших ошибок прогноза на данных температуры океана: среднеквадратичная ошибка 0.271 против 0.361 у чисто низкоранговой модели и 0.373–0.440 у CP-, Tucker- и Lasso-подходов. Пространственные карты нагрузок выявили области, соответствующие бассейну Эль-Ниньо, подтверждая физическую интерпретируемость. Теоретически установлены неасимптотические границы ошибок, растущие как корень из сложности модели, делённой на размер выборки. Симуляции подтвердили сходимость оценок и влияние радиуса неидентифицируемости на разделение низкоранговой и разреженной частей.
Значение
Работа впервые объединяет интерпретируемость факторного моделирования с эффективностью CP-разложения в тензорной авторегрессии, преодолевая ограничения предыдущих методов. В отличие от соседних работ, использующих Tucker-разложение или чистую разреженность, предложенный подход сохраняет линейный рост числа параметров с порядком тензора и одновременно выделяет значимые регионы. Это позволяет анализировать высокоразмерные временные ряды без потери физического смысла, что критично для климатологии и других наук о данных.
Развитие
Возможные направления включают добавление разреженности к матрицам нагрузок для дальнейшего снижения требований к размеру выборки, построение доверительных интервалов для коэффициентов и использование тензорного кольцевого разложения для повышения точности представления. Также перспективно разделение периодов до и во время Эль-Ниньо для улучшения интерпретации ковариатных признаков.
Влияние
Метод применим в климатологии, нейробиологии, экономике и финансах, где данные естественно представлены в виде тензоров и обладают временной зависимостью.
Следующие шаги
Проверить модель на других климатических наборах данных и исследовать статистические свойства оценок для построения выводов о значимости коэффициентов.
Ключевые проблемы
В статистике временных рядов остаётся открытым вопрос о балансе между интерпретируемостью и эффективностью снижения размерности для тензорных данных. Работа напрямую решает эту проблему, предлагая структуру, которая сохраняет оба свойства, и открывает путь к более сложным моделям с динамическими факторами.
Взгляд машины знаний
Этот раздел адресован автору работы и его коллегам. Соседние работы нашёл смысловой поиск по нашему архиву — не по совпадению слов, а по смыслу. Мы не рецензируем: мы показываем поле вокруг.
Что сделано в работе
Авторы строят авторегрессионную модель для тензорных временных рядов, где коэффициенты имеют CP-низкоранговую структуру, а разреженная компонента улавливает локальные аномалии. Оценка параметров выполняется методом наименьших квадратов с чередующимся алгоритмом, а выбор гиперпараметров — по отложенной выборке. На данных температуры океана модель превосходит аналоги по точности прогноза и выделяет области, соответствующие бассейну Эль-Ниньо.
В чём сила
Объединение CP-разложения и разреженной компоненты позволяет сохранить линейный рост числа параметров с порядком тензора и одновременно выделять значимые регионы, что даёт интерпретируемость без потери эффективности.
Куда можно двигаться
- Может быть интересно посмотреть, как предложенная тензорная авторегрессия сочетается с методами прогнозирования засухи по обратному чтению погодных данных, где также важна интерпретируемость и работа с многомерными рядами.опора: Как нейросеть, читая погоду назад, предупреждает о засухе за месяцы arXiv:2607.00331
- Рядом лежит подход к восстановлению уравнения состояния нейтронных звёзд с помощью ИИ, где используется декомпозиция и интерпретируемые признаки; возможно, перенос их техник выделения физически значимых компонент на климатические тензоры.опора: Слушая звёзды: ИИ-дешифровщик мгновенно восстанавливает уравнение состояния нейтронных звёзд arXiv:2607.12722
- В архиве есть работа по детекции космической паутины (JADE), где применяются методы снижения размерности для больших астрофизических данных; можно рассмотреть адаптацию их идей для анализа пространственно-временных климатических структур.опора: JADE: ИИ-детектив, читающий космическую паутину по следам света arXiv:2606.31988
Что можно попробовать
- Использовать скользящий прогноз с переменным горизонтом для оценки устойчивости выделяемых разреженных аномалий во времени.
- Применить метод к данным о засухе из работы 2607.00331 и сравнить интерпретируемость выделяемых регионов с их подходами.
- Проверить, как добавление разреженной компоненты влияет на стабильность CP-факторов при наличии пропусков в данных.
Почему это может быть важно
Предложенный метод может быть полезен для анализа любых высокоразмерных тензорных временных рядов, где требуется баланс между точностью прогноза и физической интерпретируемостью, особенно в климатологии и нейробиологии.
Работы рядом в нашем архиве
- Тепловое поле комнаты: как один датчик восстанавливает полную картинублизость 0.49
- Слушая звёзды: ИИ-дешифровщик мгновенно восстанавливает уравнение состояния нейтронных звёздблизость 0.48
- Как нейросеть, читая погоду назад, предупреждает о засухе за месяцыблизость 0.48
- Нейросеть на слух: как измерить энергию частицы в шуме коллайдераблизость 0.48
- Облачные специи: как нейросеть улучшает климатические моделиблизость 0.48
- Термометры в плазме лгут одинаковоблизость 0.47
- JADE: ИИ-детектив, читающий космическую паутину по следам светаблизость 0.46
Вокруг этой работы в архиве пусто: ближайший разбор всего на 0.49, при обычных 0.64. Похоже, рядом почти не бурили.
Тензор данных о температуре океана содержит 14637 элементов, но предложенная модель использует всего около 300 параметров для прогноза.
Ключевые числа
- размер тензора: 51×41×7
- число параметров в полной модели: 14637²
- количество наблюдений: 503
- среднеквадратичная ошибка прогноза: 0.271