Самонаблюдаемое обучение — это парадигма, в которой модель генерирует обучающие сигналы, извлекая их из самой структуры неразмеченных данных. В отличие от обучения без учителя, которое часто фокусируется на кластеризации или понижении размерности, здесь строятся суррогатные (предтекстовые) задачи, не требующие человеческих аннотаций. Например, в обработке естественного языка маскируется часть слов во входном предложении, и сеть учится восстанавливать их по контексту. В компьютерном зрении популярны контрастные методы: два случайно искажённых варианта одного изображения «сближаются» в пространстве представлений, а к другим изображениям — «отталкиваются». Это формирует зрительное понятие, напоминающее то, как младенцы вычленяют объекты из фона.
История
Идеи самоконтроля прослеживаются в работах по автоэнкодерам (Хинтон, 2006) и обучению представлений через восстановление. Поворотный момент — 2018 год с появлением BERT (Devlin et al.), использующего маскирование слов. Для изображений в 2020 году метод SimCLR (Chen et al.) показал, что простая контрастная схема с большими размерами батча сопоставима с обучением с учителем. Позднее Vision Transformers в сочетании с маскированным автокодированием (MAE) повторили успех NLP, продемонстрировав масштабируемость.
Как это работает
Общая схема SSL включает: 1) предтекстовую задачу — автоматическую генерацию целевого сигнала; 2) кодировщик, извлекающий представления; 3) опционально проектор для сопоставления метрик; 4) функцию потерь, решающую конкретную предтекстовую задачу. В NLP: маскированный язык (MLM) — задача восстановления скрытых токенов. Модель получает последовательность с масками [MASK] и учится предсказывать оригинальные слова через кросс-энтропию. В CV: контрастные методы учатся инвариантным к аугментациям представлениям, используя батчи большого размера и механизм momentum encoder для стабилизации. Недавние маскированные автокодировщики (MAE) маскируют случайные патчи изображения, а декодер восстанавливает пиксели, принуждая модель понимать глобальную структуру объектов.
Где применяется
Системы распознавания речи, автопереводчики, все современные большие языковые модели (вроде GPT), медицинская диагностика по снимкам без подписей врачей.
Любопытный факт
После самонаблюдаемого обучения на текстах модель GPT-3 оказалась способна писать стихи, код и научные эссе, хотя её никто специально этому не учил.
Радиолог смотрит на снимок брюшной полости и видит не просто органы, а их взаимное расположение: какая почка больше, где опухоль относительно сосуда. Это похоже на чтение карты, где важно не только знать, где обычно стоит город, но и уметь измерить расстояние между двумя точками на местности.
В девятиэтажном здании из тысячи комнат на каждом этаже кто-то шепчет, а кто-то кричит. Соседи передают слова дальше, но если все говорят слишком тихо, сообщение затухает уже на третьем этаже. Если слишком громко — к последнему этажу оно превращается в неразборчивый рёв. Между этими крайностями есть режим, когда шёпот доходит до конца без искажений.
В антарктическом льду частица-призрак оставляет после себя лишь слабую вспышку синего света. Детектор IceCube ловит эти вспышки, и по ним нужно понять, откуда прилетела частица. Модель PolarBERT научилась это делать, но что именно она видит внутри — оставалось загадкой.
Синхронный переводчик в зале, где выступают двое: он должен успеть и за смыслом, и за интонацией, но если говорить слишком быстро, остаётся только пересказ. Примерно так чувствуют себя учёные, когда поток гравитационных волн от слияний чёрных дыр и нейтронных звёзд растёт, а точные расчёты сигналов не поспевают.
Одиночная молекула ДНК, зажатая в наноразмерной металлической щели, дрожит и мерцает под лазерным излучением. Её оптический сигнал — не чёткая строка букв, а хаотичная смесь вспышек и теней, порождённая квантовыми флуктуациями. Расшифровать этот шум — всё равно что разобрать шёпот в переполненном зале: полезная информация тонет в случайном фоне.
Поиск нового материала напоминает кулинарные эксперименты без рецепта: пробуешь, пробуешь — и часто выбрасываешь. Раньше учёные вручную просматривали научные статьи и по одному проверяли составы. Теперь появился «робот-повар», который сам читает литературу, смешивает компоненты и анализирует результат.
Оркестр играет, но музыканты не слышат друг друга. Дирижёр то и дело останавливает музыку и подходит к каждому, чтобы подстроить инструмент. Примерно так работают космические телескопы с составными зеркалами.
Рентгеновский аппарат DXA делает снимок, а врач традиционно видит лишь цифры — плотность костей, процент жировой ткани. Но изображение хранит гораздо больше. Группа исследователей создала модель LeDXA, которая читает эти снимки как карту скрытых сигналов организма.
Модель обучалась на 11 540 снимках проекта «Фенотип человека» без единой аннотации.
В духовке при повышении температуры молекулы движутся быстрее, и беспорядок растёт. С языковыми моделями вроде ChatGPT всё наоборот. Когда разработчики увеличивают параметр «температура» — величину, управляющую случайностью выбора слов, — модель получает доступ к более широкому выбору слов, но её длинные тексты внезапно зацикливаются.
Магнитоэнцефалограф — прибор, похожий на шлем с сотнями датчиков, — улавливает слабые магнитные поля, которые создают работающие нейроны. Если человек слушает речь, в этих сигналах прячутся отпечатки услышанных слов. Но достать их оттуда непросто: сигнал от тысяч источников сливается в запутанный клубок.
Мозг не просто реагирует на мир — он постоянно гадает, что произойдёт в следующий миг. Этот принцип называют предсказательным кодированием: нейроны сравнивают ожидания с реальностью и обновляют внутреннюю картину, когда случается ошибка. Но как именно такая сложная система может быть устроена в живой ткани коры, оставалось неясным.
Нейросеть предсказывает будущее динамической системы — например, эволюцию плазмы в магнитном поле или изменение лица на видео. Ошибки неизбежны, и чем дальше модель заглядывает вперёд, тем больше их накапливается. Свериться с правильным ответом в момент работы невозможно: его просто не существует.
Авторы новой работы нашли простой, как всё гениальное, трюк: обучить одну модель двигаться и вперёд, и назад по времени.
Человеческий разум похож на конструктор, который сам себя достраивает. Новые идеи не умирают вместе с человеком — они передаются, смешиваются и отбираются. Этот процесс называют культурной эволюцией: полезные изобретения закрепляются, а бесполезные забываются. Так работает храповик — механизм, который крутится только вперёд.
Глазной протез передаёт в мозг не фотографию, а редкий пунктир из светлых точек — фосфенов. Чтобы разглядеть в этой ряби чашку или ключи, человек вынужден водить головой, как фонариком в темноте, и по крупицам собирать очертания предмета. Это медленный процесс, похожий на сбор пазла, где большинство деталей выброшено.
Двести сорок две тысячи триста двадцать семь галактик — как песчинок на пляже. Но астрономы превратили этот хаос в карту: алгоритм UMAP (метод машинного обучения) взял у каждой из галактик одиннадцать параметров — семь цветов от оптики до среднего инфракрасного диапазона (это фотометрия), звёздную величину, радиус и фотометрическое…
Восстановить целостную картину по обрывкам — всё равно что расслышать мелодию оркестра в шумном зале. Такие задачи стоят в фотометрии — области, измеряющей поток излучения от небесных тел, где по слабому мерцанию восстанавливают яркость звезды. Традиционные методы требуют точных сведений о помехах, а они почти всегда неизвестны.
Камеры беспилотного автомобиля улавливают свет, словно телескопы, направленные на далёкую галактику. Каждый кадр — отрывочное наблюдение; вместе они должны сложиться в карту пути.
Компьютер, подобно астроному, не склеивает снимки, а генерирует несколько возможных видов сверху и сравнивает их с реальными данными.
Многие природные процессы описываются дифференциальными уравнениями, но в распоряжении учёных часто оказываются лишь фрагментарные данные — своего рода обрывки карты. Новый вычислительный метод работает как картограф, восстанавливающий целостную карту местности по немногим ориентирам.
Экскурсия с одним роботом — это утомительный монолог, в котором посетителю не с кем обменяться взглядом или репликой. Исследователи превратили такой моноспектакль в живую сцену: к реальному роботу-гиду добавили голограмму-напарницу. Этот тандем общается, спорит, шутит, вовлекая посетителей в разговор, а не просто вещает факты.
Классическая система слежения напоминает штурмана, прокладывающего курс по звёздам. Но стоит облакам закрыть небо — координаты начинают дрейфовать, а в данных нарастает энтропия — мера неопределённости. Новый алгоритм получает «второго пилота» — модуль, который непрерывно оценивает, насколько уверен основной навигатор в своих расчётах.
Вы стоите под душем: поворачиваете вентиль, а вода — то ледяная, то обжигающая. Трубы живут собственной жизнью: давление скачет непредсказуемо, словно капризный оркестр без дирижёра.
Современный стандартный подход к обучению искусственного интеллекта можно сравнить с ребёнком, запертым в библиотеке: он запоминает миллионы книг, но не знает, что огонь обжигает, а падение приносит боль.
Освоение иностранного языка сродни настройке музыкального инструмента. Новая технология действует как интеллектуальный тюнер: она принимает вашу аудиозапись и эталонную речь носителя, затем динамически растягивает или сжимает их во времени — подобно тому, как подтягивают струну для точного совпадения тонов, — чтобы идеально совместить сигналы, и оценивает три ключевых параметра: чистоту звуков (артикуляцию)…
После брошенного камня круги на воде исчезают, но жидкость хранит микроскопические колебания. Малейший порыв — и рябь возникает снова. Сети нейронов ведут себя похоже. Когда электрические сигналы затихают, память о них остаётся в точках контакта — синапсах, где передача импульсов меняет силу связей. Как вода после шторма, эти следы таят скрытую энергию.
Мозг общается короткими электрическими разрядами — потенциалами действия. Прежде расшифровка этого языка требовала тысяч размеченных примеров: экспериментатор сопоставлял сигнал с конкретным движением или словом. Метод MOJO предлагает иной подход — подобно изучению языка через погружение, он сначала вслушивается в «поток сознания» без всяких подсказок и самостоятельно выявляет повторяющиеся паттерны.
В кастрюле с супом достаточно двух термометров, чтобы понять температуру везде — если знать, что тепло идёт кругами от дна. Так и в науке: по редким замерам нужно восстановить полную картину теплового поля.
Долгое время биологи изучали клетки, слушая лишь один голос в многоголосом хоре: например, измеряли активность генов — транскриптом, игнорируя, как упакована ДНК — эпигеном. Это всё равно что пытаться понять смысл разговора, зная только один язык.
Автоматические судьи речи — это алгоритмы, обученные оценивать произношение и эмоциональную окраску голоса. Однако, как показали исследования, они часто ведут себя подобно кулинарному критику, который выносит вердикт, прочитав меню, но не попробовав само блюдо.
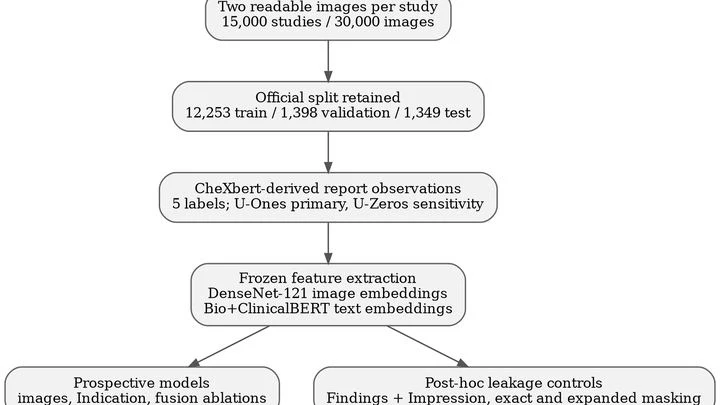
ИИ-диагност учится подобно студенту-медику перед экзаменом. Ему предоставляют рентгеновский снимок и жалобы пациента. Однако иногда среди учебных материалов случайно оказывается готовый отчёт врача — полный ответ. Тогда нейросеть, словно нерадивый студент, запоминает его, и точность на тесте взлетает до 98%. Но это не что иное, как списывание: реальный диагностический навык не формируется.
Ребёнок, осваивая незнакомую квартиру, ползает от предмета к предмету и запоминает, что видно из каждого угла. Так мозг строит мысленную карту — внутреннюю модель пространства. Алгоритм gradCSCG действует по тому же принципу: он получает видеопоток с камеры и самостоятельно рисует схему помещения, опираясь лишь на смену картинок.
Традиционные слуховые аппараты напоминают повара, который готовит по рецепту вслепую. Они анализируют звуковой беспорядок с микрофона и на его основе усиливают речь. В шумном кафе такой подход часто ошибается. Новая система ведёт себя как опытный кулинар: сначала обрабатывает сигнал, а затем «пробует» результат.
Человек в лодке интуитивно поворачивает, смещая вес собственного тела. Тот же физический принцип использует беспилотное судно: манёвр выполняет подвижный груз, перемещающийся внутри корпуса. Его движением управляет нейросеть — алгоритм, обученный предугадывать хаос волн и порывы ветра.
Нейтронные звёзды — последние сгустки видимой материи перед падением в чёрную дыру. В их недрах материя сжата до триллионных плотностей. Здесь ядерные силы и гравитация сплетаются в экзотическую субстанцию, недоступную никакому земному ускорителю.
Энергосистемы, интегрирующие солнечные панели и ветрогенераторы, напоминают шахматную партию: облачность и колебания нагрузки — это ходы соперника, которые невозможно предвидеть. Для поддержания баланса диспетчеры прежде перебирали десятки сценариев (неопределённость), что требовало чрезмерных временных и вычислительных ресурсов.
Представьте водителя на обледенелой трассе: он не знает точной реакции машины на поворот руля и вынужден учиться в процессе, интуитивно сохраняя запас пространства для возможной ошибки. Сходным образом действует адаптивный алгоритм управления.
Традиционно алгоритмы машинного обучения действуют в статичном окружении — подобно воде, которая течёт по уже проложенному руслу, не меняя его формы. Новый метод переворачивает эту парадигму: он позволяет агенту одновременно осваивать действия и целенаправленно изменять саму среду, в которой он существует.
В шумной комнате человек выделяет нужный голос благодаря бинауральному слуху: два уха улавливают микроскопическую разницу во времени прихода звуковых волн и их интенсивности. Компьютер с массивом микрофонов действует аналогично — он извлекает пространственные подсказки, вычисляя направление на каждый источник звука.
Представьте повара, который учится готовить исключительно по рисованным картинкам — он почти наверняка испортит каждое блюдо. Схожая ловушка подстерегает и компьютерное зрение: для обучения моделей требуются тысячи размеченных снимков, но собирать и аннотировать их вручную — дорого и муторно.