El océano y la atmósfera aprenden a hablar el mismo idioma ✛
Contexto
El pronóstico con meses de anticipación siempre ha dependido del océano. La atmósfera olvida su estado inicial en un par de semanas, mientras que la capa superior del océano guarda memoria durante meses y la libera lentamente a través de la temperatura de la superficie. Por eso El Niño, esa mancha cálida en el Pacífico ecuatorial, es la principal fuente de predictibilidad en escalas de un mes a un año. Los modelos físicos llevan medio siglo aprendiendo a conectar el océano y la atmósfera, pero aún adolecen de errores sistemáticos, como la lengua fría en los trópicos. Junto a este trabajo existen intentos de predecir El Niño a partir de datos y de construir modelos híbridos, pero nadie antes de Ola había incluido la temperatura subsuperficial del océano en el circuito de entrenamiento.
Métodos
Ola consta de dos redes neuronales entrenadas por separado y luego acopladas en un ciclo. La parte atmosférica, con un paso de 24 horas, se entrenó con el reanálisis ERA5 de 1980 a 2016; la oceánica, con un paso de 48 horas, con datos de UFS-replay de 1994 a 2016. La red oceánica recibe de la atmósfera el viento en superficie, la temperatura y la presión, mientras que la atmosférica recibe la temperatura de la superficie del mar. Dentro de la red oceánica hay ocho niveles de profundidad, desde medio metro hasta 300 metros, lo que permite ver la termoclina, esa capa de cambio brusco de temperatura donde se esconde la memoria del futuro El Niño. Para los pronósticos por conjuntos se utilizó el método de conjuntos rezagados: se ejecutó el modelo cada seis horas durante los primeros tres días del mes y se reunieron 12 trayectorias.
Resultados
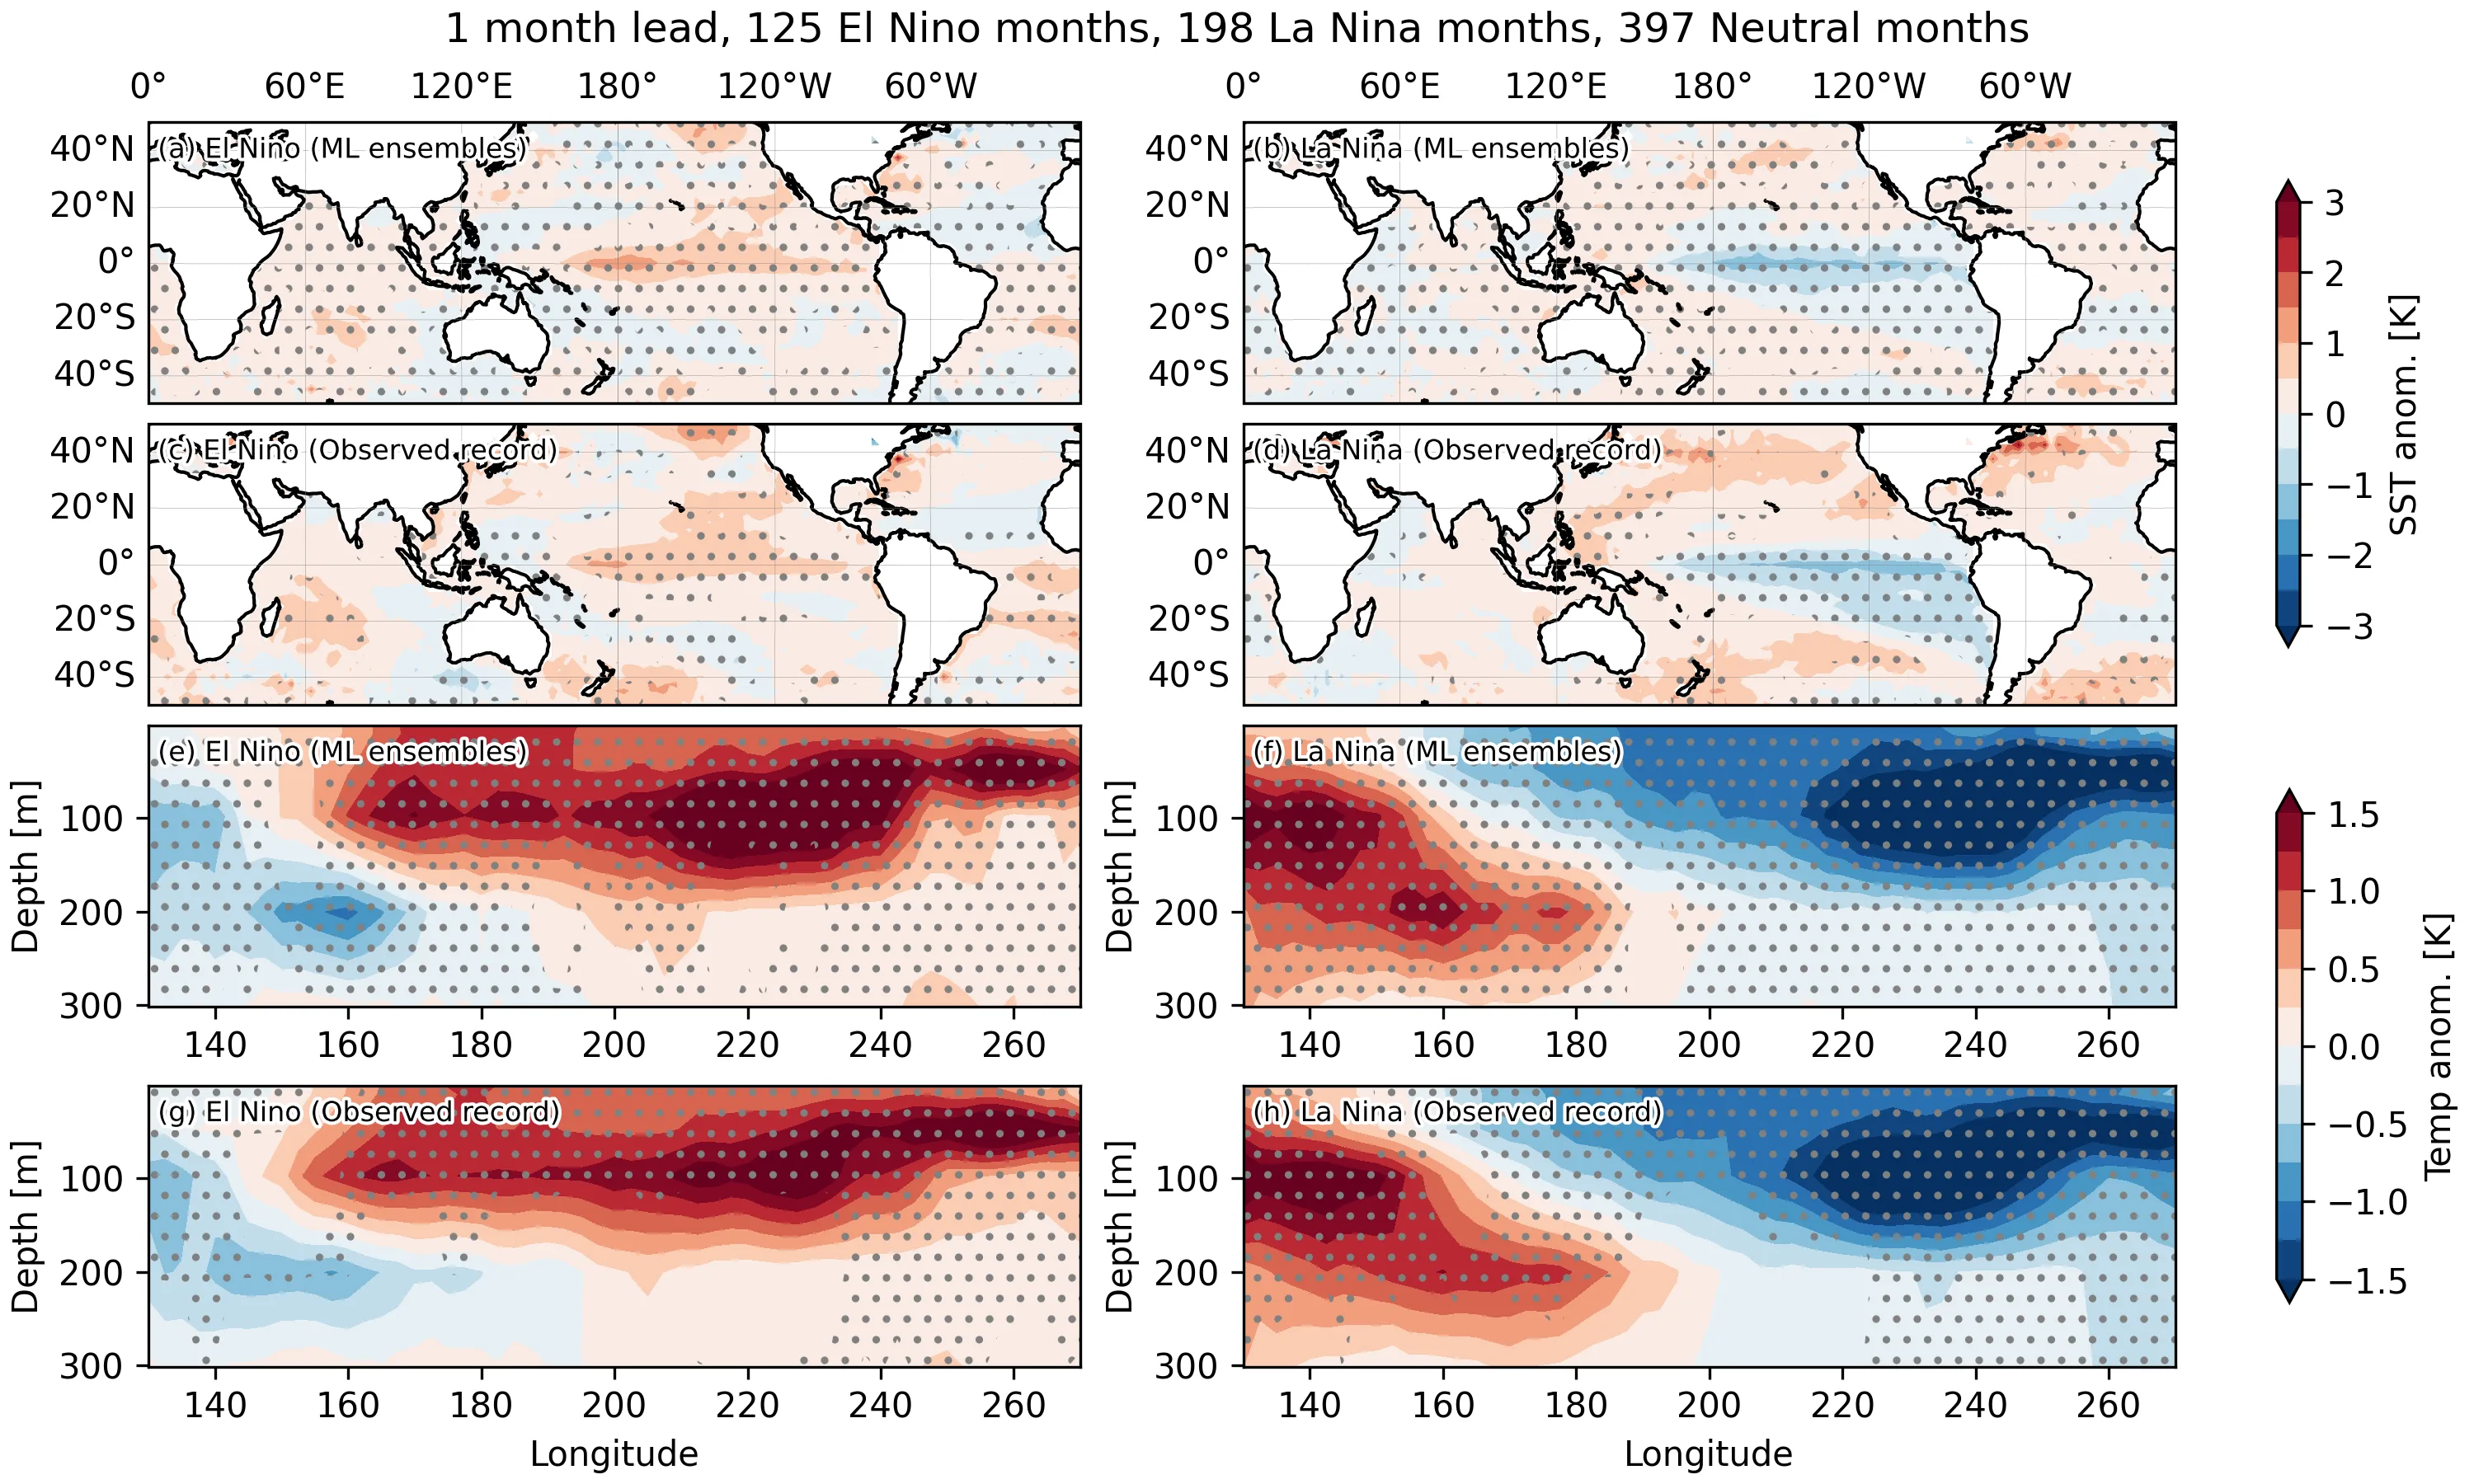
Durante los cinco años de prueba, de 2017 a 2022, Ola reprodujo tanto El Niño como La Niña; la amplitud de las oscilaciones de temperatura en la región Niño 3.4 resultó cercana a las observaciones, y el sesgo frío típico de GFDL-SPEAR casi desapareció. A lo largo del ecuador, el modelo generó ondas de Kelvin que se desplazan hacia el este a unos dos metros por segundo y ondas de Rossby que se mueven hacia el oeste a cinco o diez grados del ecuador. Bajo la superficie, las anomalías de temperatura durante El Niño se desplazaron hacia el este a 50 metros de profundidad, como en el océano real. El único fallo notable ocurrió en el invierno de 2021–2022, cuando el modelo no sostuvo la tercera La Niña consecutiva, pero la mayoría de los sistemas operativos tampoco lo lograron.
Implicaciones
Ola demostró que el aprendizaje automático puede sortear la maldición de las parametrizaciones, que durante décadas ha acumulado errores en los trópicos en los modelos físicos. La diferencia con los trabajos vecinos es fundamental: estos predecían El Niño mediante índices estadísticos o usaban solo la temperatura de la superficie del océano, mientras que Ola incluye por primera vez la estructura vertical de los 300 metros superiores en el circuito de entrenamiento. No es solo otro emulador, sino una prueba de la hipótesis de que una red neuronal puede aprender la dinámica acoplada del océano y la atmósfera, incluidas las ondas que transportan calor y determinan la fase de El Niño.
Desarrollo futuro
Por ahora, el modelo es estable solo durante seis meses; más allá, se acumulan derivas en latitudes altas. Ampliar el conjunto de entrenamiento, añadir corrientes oceánicas y niveles más profundos podría extender el pronóstico a un año o más. Los esquemas híbridos, en los que la red neuronal se entrena con simulaciones climáticas de mil años y luego se ajusta con series cortas de observaciones, parecen la vía más realista hacia pronósticos estacionales e interanuales.
Impacto
La predicción estacional para la agricultura, la energía y la gestión de recursos hídricos dispondrá de una herramienta que calcula un conjunto en un minuto en una sola tarjeta gráfica, en lugar de horas en un supercomputador.
Próximos pasos
Comparar sistemáticamente distintas arquitecturas de modelos acoplados con datos comunes para entender qué decisiones empíricas afectan a la estabilidad a largo plazo, y entrenar una versión con un vector de estado oceánico más completo.
Problemas abiertos clave
Para el modelado climático sigue abierta la cuestión de cómo evitar la deriva de la temperatura media de los trópicos al pasar a modelos acoplados. Ola ofrece un primer indicio de que prescindir de las parametrizaciones de convección y de la capa límite podría resolver el problema de la doble zona de convergencia intertropical, que afecta a los modelos físicos desde la década de 1980.
La mirada de la máquina del conocimiento
Esta sección está dirigida al autor del trabajo y a sus colegas. Los trabajos vecinos los encontró la búsqueda por significado en nuestro archivo, no por coincidencia de palabras. No evaluamos: mostramos el campo alrededor.
Qué hace el trabajo
El trabajo presenta el modelo Ola, basado en la arquitectura Spherical Fourier Neural Operator, que consta de redes neuronales atmosférica y oceánica entrenadas con ERA5 y UFS-replay. El modelo reproduce El Niño y La Niña, incluida la estructura subsuperficial de la temperatura, las ondas de Kelvin y Rossby, y muestra un menor sesgo frío en comparación con GFDL-SPEAR. Para los pronósticos estacionales se utiliza el método de conjuntos rezagados.
Dónde está su fuerza
Incluir en el circuito de entrenamiento la estructura vertical de los 300 metros superiores del océano permite que el modelo capture la dinámica de la termoclina, algo crítico para predecir El Niño. Esto distingue a Ola de enfoques anteriores que solo usaban la temperatura de la superficie del océano o índices estadísticos.
Hacia dónde puede avanzar
- Se podría considerar aplicar el enfoque de Ola al pronóstico de sequías con meses de antelación, aprovechando su capacidad para reproducir procesos oceánicos lentos.se apoya en: Cómo una red neuronal, leyendo el clima al revés, vaticina sequías con meses de anticipación arXiv:2607.00331
- Sería interesante comparar Ola con modelos que predicen El Niño con un año y medio de anticipación, para evaluar los límites de la previsibilidad cuando se utiliza la estructura vertical del océano.se apoya en: El Niño puede predecirse con año y medio de antelación arXiv:2601.12251
- Quizás los métodos del trabajo sobre pronóstico del tiempo con una sola tarjeta gráfica podrían acelerar el entrenamiento o la inferencia de Ola, lo que sería útil para el pronóstico operativo por conjuntos.se apoya en: Pronóstico del tiempo con una sola tarjeta gráfica arXiv:2603.21284
Vale la pena probar
- Comprobar si la inclusión de datos de temperatura subsuperficial mejora el pronóstico de precipitaciones extremas en los trópicos.
- Utilizar Ola para inicializar modelos regionales de alta resolución y así mejorar los pronósticos locales.
- Evaluar cómo reproduce el modelo las teleconexiones, por ejemplo, el efecto de El Niño en el clima de latitudes medias.
Por qué puede importar
Si los modelos de aprendizaje automático logran reproducir de manera fiable la dinámica acoplada del océano y la atmósfera, se abrirá el camino hacia pronósticos estacionales por conjuntos rápidos y económicos, lo que resulta especialmente valioso para regiones que dependen de las fluctuaciones climáticas.
Trabajos cercanos en nuestro archivo
- El Niño puede predecirse con año y medio de antelacióncercanía 0.54
- Pronóstico del tiempo con una sola tarjeta gráficacercanía 0.52
- Ciclos solares: cómo el vaivén magnético mece el futurocercanía 0.50
- Cómo el clima en la estratosfera altera los contadores de partículas en las profundidades de la Tierracercanía 0.49
- Cómo aprende el cerebro a anticipar sin pistascercanía 0.49
- Cómo una red neuronal, leyendo el clima al revés, vaticina sequías con meses de anticipacióncercanía 0.48
El archivo está vacío alrededor de este trabajo: el análisis más cercano queda en 0.54, frente a un 0.64 habitual. Parece que aquí al lado casi nadie ha perforado.
Ola genera un pronóstico de seis meses en menos de un minuto en una sola tarjeta gráfica A100, mientras que el modelo clásico GFDL-SPEAR necesita horas en un clúster para el mismo cálculo.
Cifras clave
- resolución: 0.25° en latitud y longitud
- profundidad del océano: hasta 300 metros, 8 niveles
- velocidad del pronóstico: 6 meses en menos de 1 minuto en A100
- período de entrenamiento de la atmósfera: 1980–2016 (ERA5)
- período de entrenamiento del océano: 1994–2016 (UFS-replay)