Conexiones densas frente a residuales: cómo DenseNet-121 supera a ResNet-50 en la detección del cáncer cerebral ✛
Contexto
La interpretación manual de las imágenes de biopsias cerebrales es laboriosa y sufre de discrepancias entre especialistas: un mismo corte puede ser evaluado de manera diferente por distintos médicos. Alrededor de este problema ya se ha construido toda una línea de investigación: estudios vecinos en nuestro archivo utilizan redes neuronales para la segmentación de tumores, la síntesis de imágenes y la evaluación de la confianza del modelo. Este artículo se inscribe en la misma corriente de automatización del análisis de imágenes médicas, pero se centra en la comparación directa de dos arquitecturas populares de redes convolucionales para la clasificación de imágenes de tejido cerebral. No es una tarea nueva, pero la comparación sistemática en un mismo conjunto de datos con un control cuidadoso del sobreajuste llena un vacío en la base de evidencia para la elección de arquitectura.
Métodos
Se utilizó un micromatriz de tejido (TMA) comercial con 24 muestras circulares de tejido cerebral de 5 micras de grosor, escaneado en un microscopio Olympus BX61 con objetivo de 40 aumentos en modo de escaneo automático (unas 100 posiciones en 6 minutos). De las 2931 imágenes, se separaron 1996 para entrenamiento, 437 para validación y 498 para prueba, dividiendo por paciente para evitar la fuga de datos. Cada imagen se redimensionó a 256×256 píxeles y se normalizó con la media y la varianza del conjunto de entrenamiento. Se tomaron dos redes preentrenadas en ImageNet, ResNet-50 y DenseNet-121, y se reemplazó la última capa por un clasificador con dos salidas. El ajuste fino se realizó en dos etapas: primero 10 épocas solo con el nuevo clasificador, manteniendo congeladas las capas convolucionales, y luego 20 épocas más con los dos últimos bloques descongelados y una tasa de aprendizaje menor. Se aplicaron rotaciones aleatorias, reflejos, desplazamientos y cambios de brillo, así como parada temprana si no había mejora en el error de validación durante 5 épocas.
Resultados
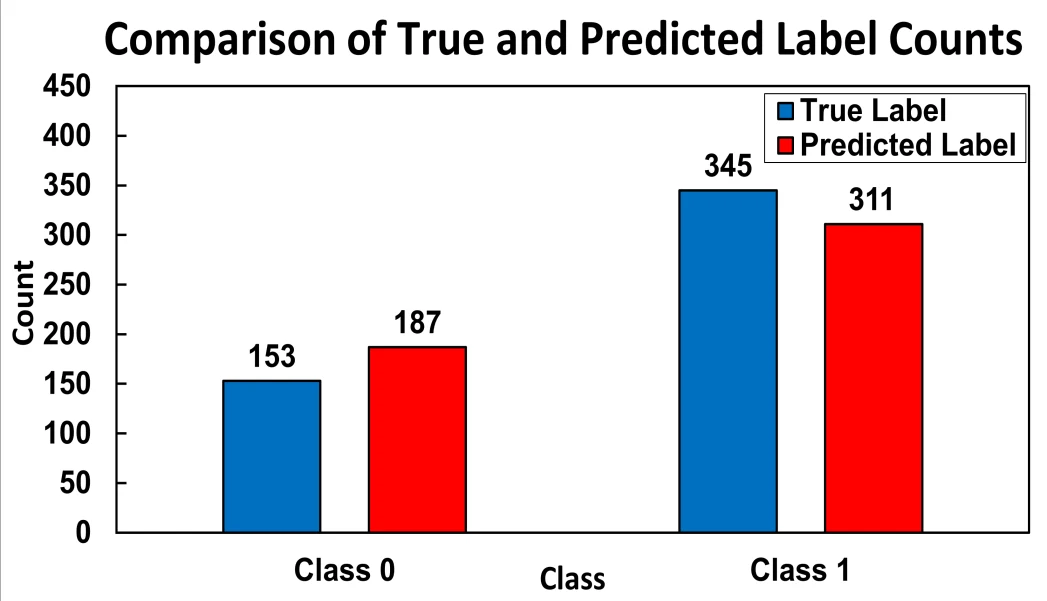
En el conjunto de prueba reservado de 498 cortes, DenseNet-121 mostró una precisión del 88,35% (intervalo de confianza del 95% ±1,28%), una precisión para la clase 'cáncer' de 0,9614, una exhaustividad de 0,8667 y una puntuación F1 de 0,9116. ResNet-50 alcanzó el 82,12% (±1,75%), con precisión de 0,9035, exhaustividad de 0,8142 y F1 de 0,8563. La diferencia en precisión de 6,23 puntos porcentuales es estadísticamente significativa (p=0,004 según la prueba de McNemar). La matriz de confusión de DenseNet-121 muestra 299 verdaderos positivos, 141 verdaderos negativos, 46 falsos negativos y solo 12 falsos positivos: la baja proporción de falsas alarmas (7,9%) es crítica para la clínica. La red sobreestima ligeramente la clase 'sin cáncer' (187 frente a 153) y subestima 'cáncer' (311 frente a 345), lo que puede corregirse ponderando las clases.
Implicaciones
El trabajo demuestra que las conexiones densas entre capas (como en DenseNet) son más efectivas que los atajos residuales (como en ResNet) para transferir conocimiento a conjuntos de datos médicos pequeños. En comparación con estudios vecinos que a menudo utilizan una sola arquitectura o abordan la segmentación, aquí se realiza una comparación directa de dos redes con el mismo protocolo de entrenamiento y verificación estadística de significancia. Esto proporciona una recomendación práctica: para la clasificación de imágenes de tejidos con un número limitado de ejemplos, es preferible optar por arquitecturas tipo DenseNet. El método de ajuste fino en dos etapas con aumentación agresiva es reproducible y puede servir como plantilla para otras tareas de clasificación binaria en patología.
Desarrollo futuro
Una extensión natural es pasar de la clasificación binaria a la gradación multiclase de tumores (bajo, intermedio y alto grado de malignidad) utilizando funciones de pérdida ordinales. Otra dirección es la combinación de múltiples modalidades de imagen (por ejemplo, diferentes tinciones o microscopía de contraste de fase) para una caracterización más completa del tejido. Para aumentar la confianza de los médicos, se necesitan métodos de explicabilidad, como los mapas de relevancia Grad-CAM, que muestren en qué regiones de la imagen se basa la red. Finalmente, el aprendizaje federado permitirá entrenar modelos con datos de diferentes hospitales sin centralizarlos, mejorando la generalización.
Impacto
Los resultados pueden acelerar la implementación del cribado automático de biopsias cerebrales en la práctica clínica, reduciendo la carga de trabajo de los patólogos y aumentando la reproducibilidad de los diagnósticos. La metodología es aplicable a otros tipos de tejido y tareas de clasificación en patología digital.
Próximos pasos
Probar el protocolo propuesto en conjuntos de datos independientes de diferentes hospitales para confirmar la generalización. Implementar la clasificación multiclase e integrar mapas de explicabilidad en el flujo de trabajo del patólogo.
Problemas abiertos clave
En la imagen médica sigue sin resolverse el problema de la escasez de datos etiquetados: anotar imágenes requiere un costoso trabajo de expertos. Este trabajo muestra que una adecuada transferencia de modelos preentrenados con aumentación agresiva compensa parcialmente este déficit, pero no elimina la cuestión de los sesgos sistemáticos en los conjuntos de entrenamiento. La conexión con el problema fundamental de la interpretabilidad de los modelos también sigue abierta: una alta precisión no garantiza que la red se base en características clínicamente relevantes y no en artefactos de tinción o de captura.
La mirada de la máquina del conocimiento
Esta sección está dirigida al autor del trabajo y a sus colegas. Los trabajos vecinos los encontró la búsqueda por significado en nuestro archivo, no por coincidencia de palabras. No evaluamos: mostramos el campo alrededor.
Qué hace el trabajo
En este trabajo se comparan directamente ResNet-50 y DenseNet-121 para la clasificación binaria de cortes de tejido cerebral en un conjunto de 2931 imágenes. Se empleó un ajuste fino en dos etapas con congelación y descongelación de bloques, aumentación agresiva y parada temprana. DenseNet-121 alcanzó una precisión del 88,35% y un F1 de 0,9116, superando significativamente a ResNet-50.
Dónde está su fuerza
La comparación sistemática de dos arquitecturas populares en un mismo conjunto, con un control cuidadoso del sobreajuste, proporciona cifras concretas para elegir arquitectura. La baja tasa de falsos positivos (7,9%) de DenseNet-121 subraya su utilidad práctica.
Hacia dónde puede avanzar
- Cerca hay un trabajo sobre la evaluación de la confianza de redes neuronales en imágenes de tumores cerebrales; quizás sea interesante ver cómo añadir calibración de predicciones a la arquitectura elegida para descartar los casos en los que el modelo duda.se apoya en: Tumor cerebral en imágenes: dónde termina la certeza arXiv:2601.17504
- En el archivo hay una investigación sobre la poda de redes sin pérdida de precisión; podría ser útil aplicar esos métodos a DenseNet-121 para reducir la carga computacional en un posible uso clínico.se apoya en: Cómo podar una red sin romperla arXiv:2603.14564
- Otro trabajo vecino se centra en mejorar imágenes médicas mediante un modelo físico; sería interesante comprobar si el preprocesado de imágenes de esta manera ayuda a aumentar la calidad de la clasificación en su conjunto de datos.se apoya en: La geometría del agua mejora las imágenes médicas arXiv:2607.12586
Vale la pena probar
- Probar la calibración de probabilidades (por ejemplo, temperature scaling) en la salida de DenseNet-121 y evaluar cómo cambia la proporción de errores con alta confianza.
- Aplicar poda a la DenseNet-121 entrenada y comparar la precisión y la velocidad de inferencia con la red original.
- Pasar las imágenes por un modelo de mejora basado en la física del agua y comprobar si aumenta la precisión en el conjunto de prueba.
Por qué puede importar
Si se logra combinar la precisión de DenseNet-121 con una confianza calibrada y menores requisitos computacionales, se acercará la clasificación automática de cortes cerebrales a la práctica clínica real, donde importan tanto la fiabilidad como la velocidad.
Trabajos cercanos en nuestro archivo
- Red neuronal al oído: cómo capturar la energía de una partículacercanía 0.53
- Dos ojos ven mejor que uno: cómo una red neuronal aprende a ver un tumorcercanía 0.53
- Cómo los grafos detectan el melanoma en la pielcercanía 0.53
- Tumor cerebral en imágenes: dónde termina la certezacercanía 0.53
- La geometría del agua mejora las imágenes médicascercanía 0.51
- Cómo podar una red sin romperlacercanía 0.51
El archivo está vacío alrededor de este trabajo: el análisis más cercano queda en 0.53, frente a un 0.64 habitual. Parece que aquí al lado casi nadie ha perforado.
El grosor del corte de tejido cerebral en el estudio es de solo 5 micras, aproximadamente 20 veces más delgado que un cabello humano. Además, la red DenseNet-121 contiene alrededor de 8 millones de parámetros entrenables: un parámetro por cada 0,37 imágenes del conjunto.
Cifras clave
- precisión de DenseNet-121: 88,35%
- precisión de ResNet-50: 82,12%
- F1 de DenseNet-121: 0,9116
- número de imágenes: 2931
- falsos positivos: 12 de 498