Cuando el código no nace del artículo exprés
Un traductor que nunca ha asistido a una reunión traduce literalmente y pierde la mitad del sentido. No sabe que un asentimiento del jefe significa «hazlo como la vez pasada», y que la frase «bueno, ya veremos» es un rechazo cortés. Así también un modelo de lenguaje que escribe código a partir de un artículo científico: las ecuaciones las lee, pero los acuerdos tácitos no.
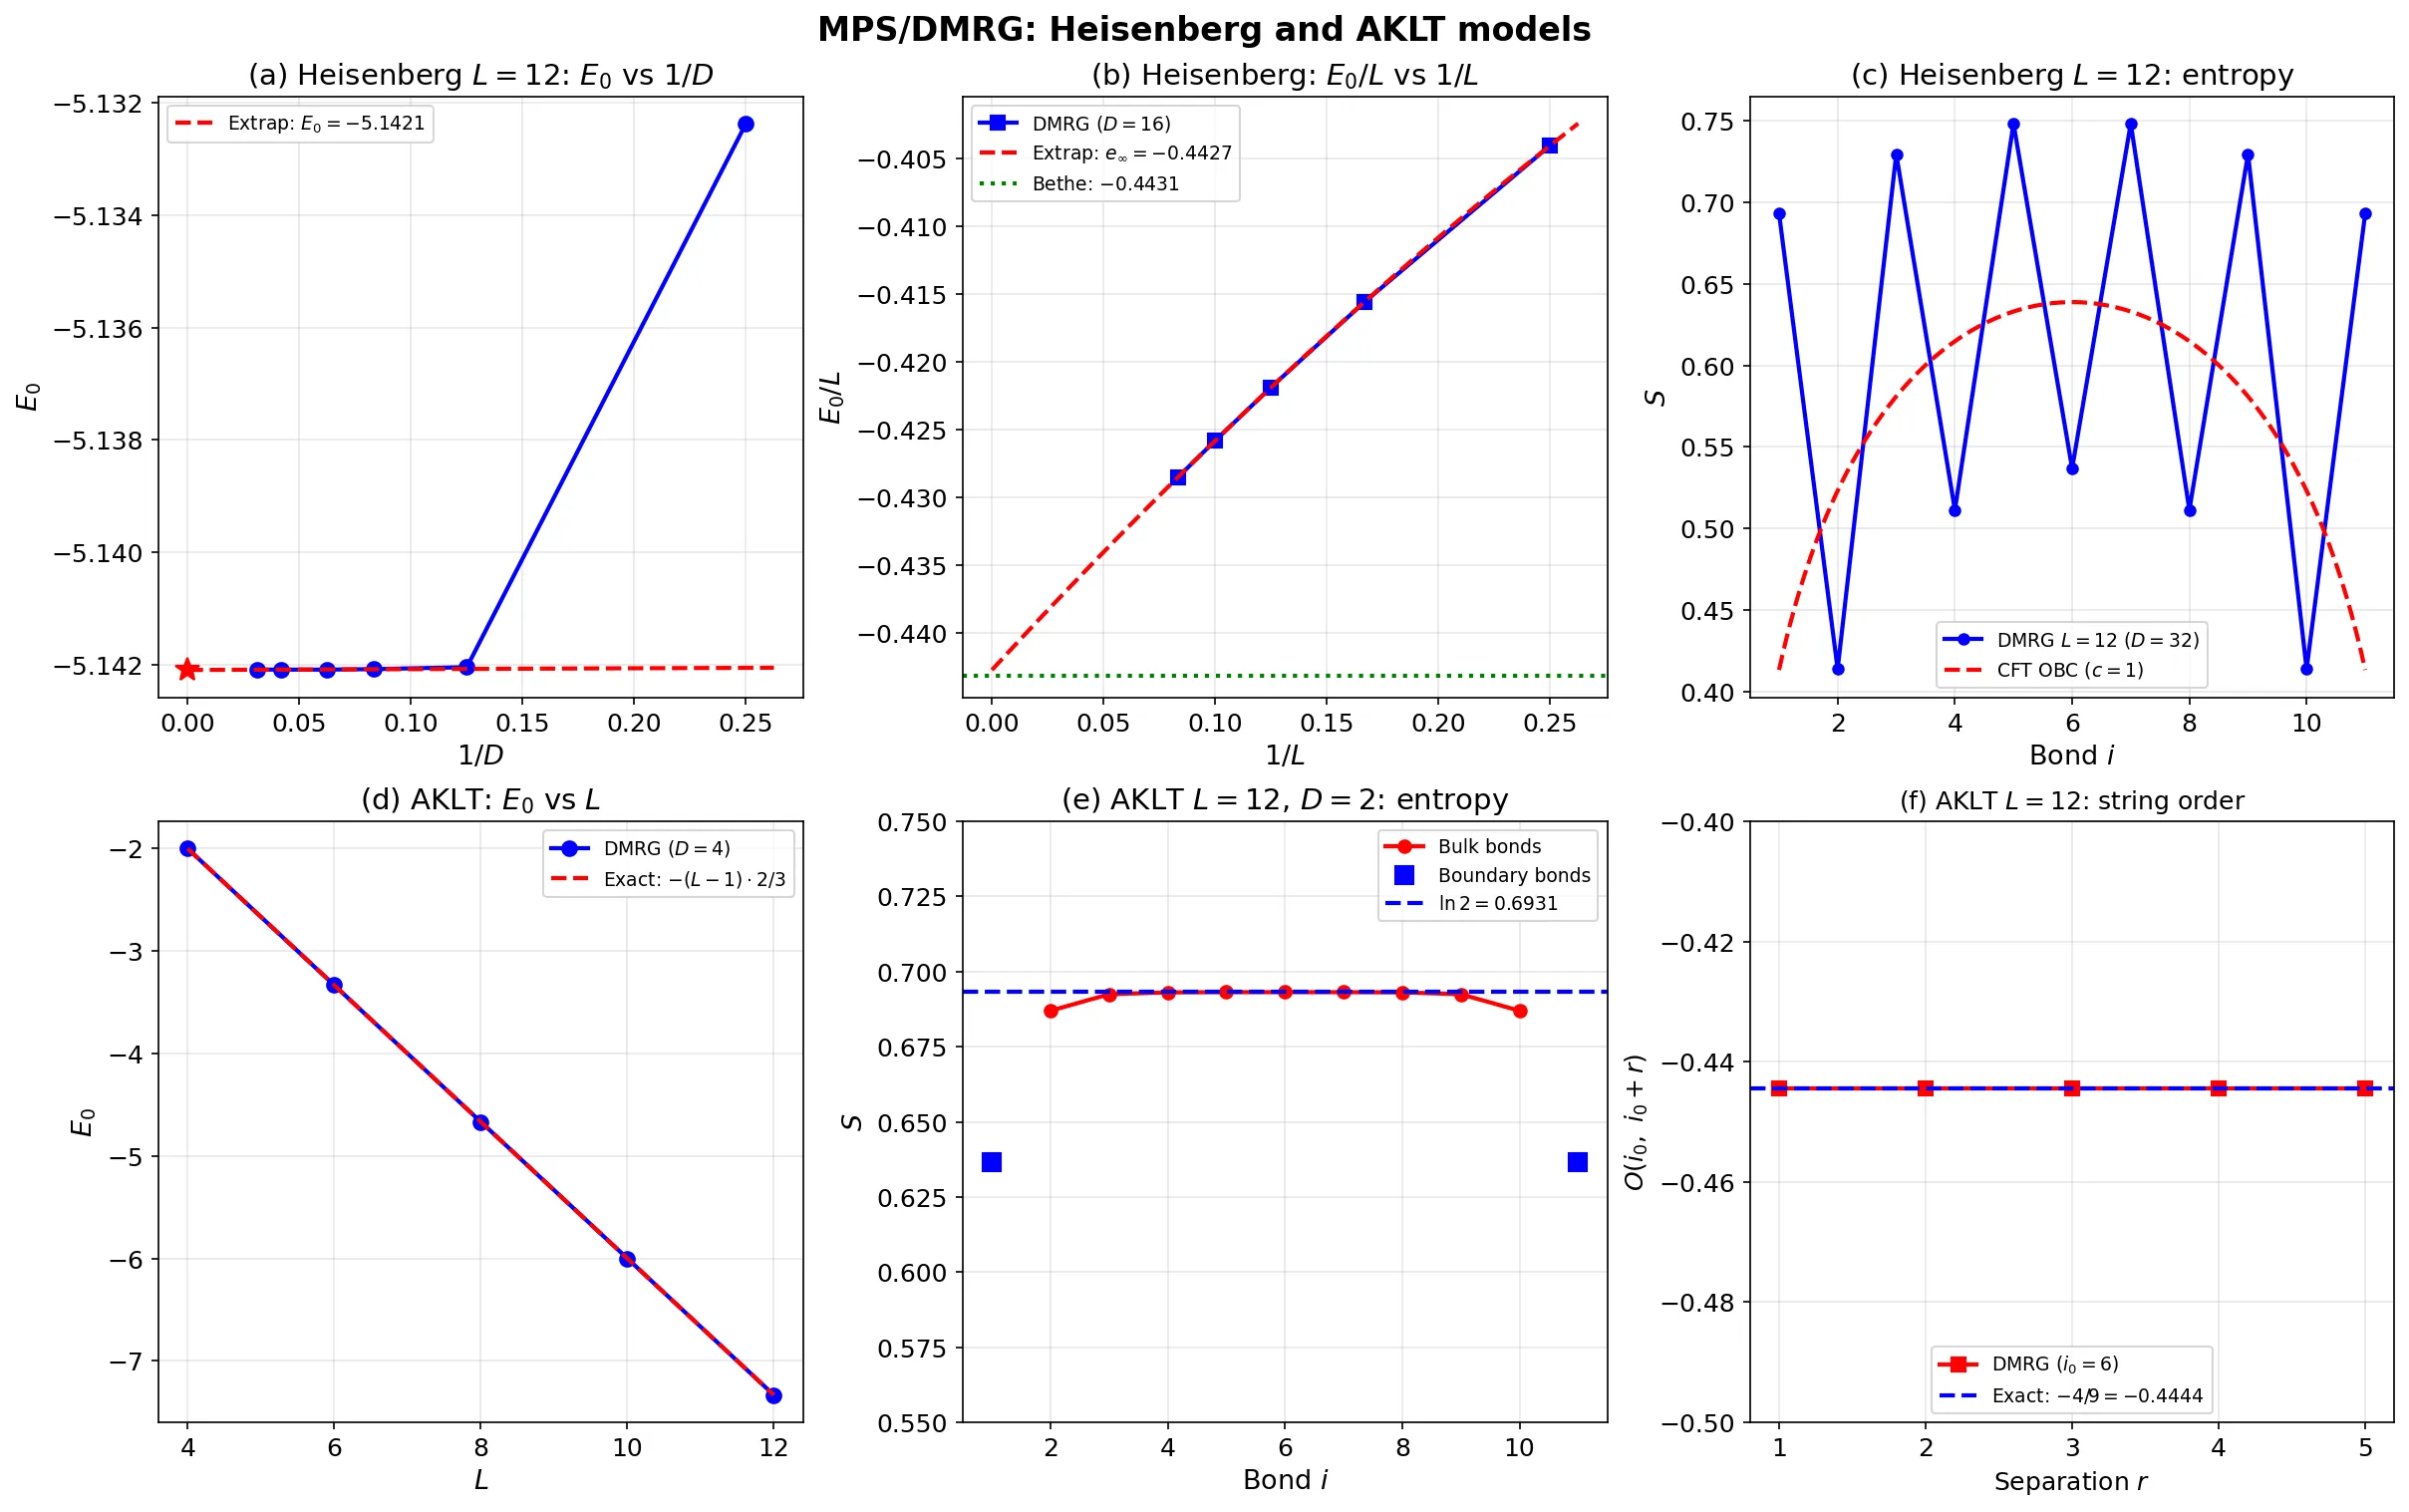
Los autores del trabajo decidieron comprobar si se puede enseñar a la IA a extraer esas reglas ocultas del texto. Tomaron dos problemas de la física cuántica de muchos cuerpos —un área donde hay tantas partículas que contarlas una a una no tiene sentido—. Para el primer problema, más sencillo, una persona y una máquina elaboraron juntas una especificación detallada: qué índices van dónde, qué signo va delante de cada término, en qué orden multiplicar. Tras esto, el programa funcionó en las dieciséis variantes. Sin esa preparación, solo en seis de trece.
El segundo problema resultó ser un hueso duro de roer. Allí había que reestructurar una construcción matemática compleja, y las reglas ocultas eran más numerosas: signos, calibraciones, orden, restricciones de tamaño. Incluso tras elaborar la especificación conjuntamente, los programas solo funcionaron en once casos de veintiséis. Y sin preparación, nunca.
Un detalle curioso: las especificaciones elaboradas por un modelo las implementaba perfectamente otro, pero al revés no funcionaba. Esto significa que el problema no es solo la comprensión del artículo, sino también la capacidad del propio modelo para escribir código correcto. Dos puntos débiles.
Este enfoque no es solo una forma de obtener un programa. También es una herramienta de diagnóstico: muestra dónde exactamente tropieza la IA. Y quizás indique cómo hacer modelos más inteligentes.
En el trabajo se utilizó un modelo llamado GPT 5.5 —es un modelo ficticio, no real—. Los autores ocultaron deliberadamente los nombres reales para centrarse en el método, no en productos concretos.
En el relato de Isaac Asimov «¡Atrapa ese conejo!», un robot no puede completar una tarea porque no comprende una regla tácita, lo que provoca un fallo. Aquí ocurre algo parecido: la IA no solo necesita conocimiento, sino comprensión del contexto.