Los modelos de difusión aprenden clima con datos escasos ✛
Contexto
El Niño y La Niña controlan el clima en gran parte del planeta, pero las mediciones detalladas de la temperatura superficial del océano por satélites y boyas solo están disponibles desde mediados del siglo XX. En ese tiempo se han acumulado unas setecientas cartas mensuales promedio, mientras que las redes neuronales con millones de parámetros suelen necesitar miles de ejemplos para no sobreajustarse. Los datos sintéticos generados por modelos lineales inversos proporcionan una estructura de baja dimensión conocida sobre la que se puede comprobar honestamente qué ha aprendido realmente un modelo de difusión. Este banco de pruebas controlado permite separar la comprensión real de la variabilidad climática del simple recuerdo de la muestra de entrenamiento.
Métodos
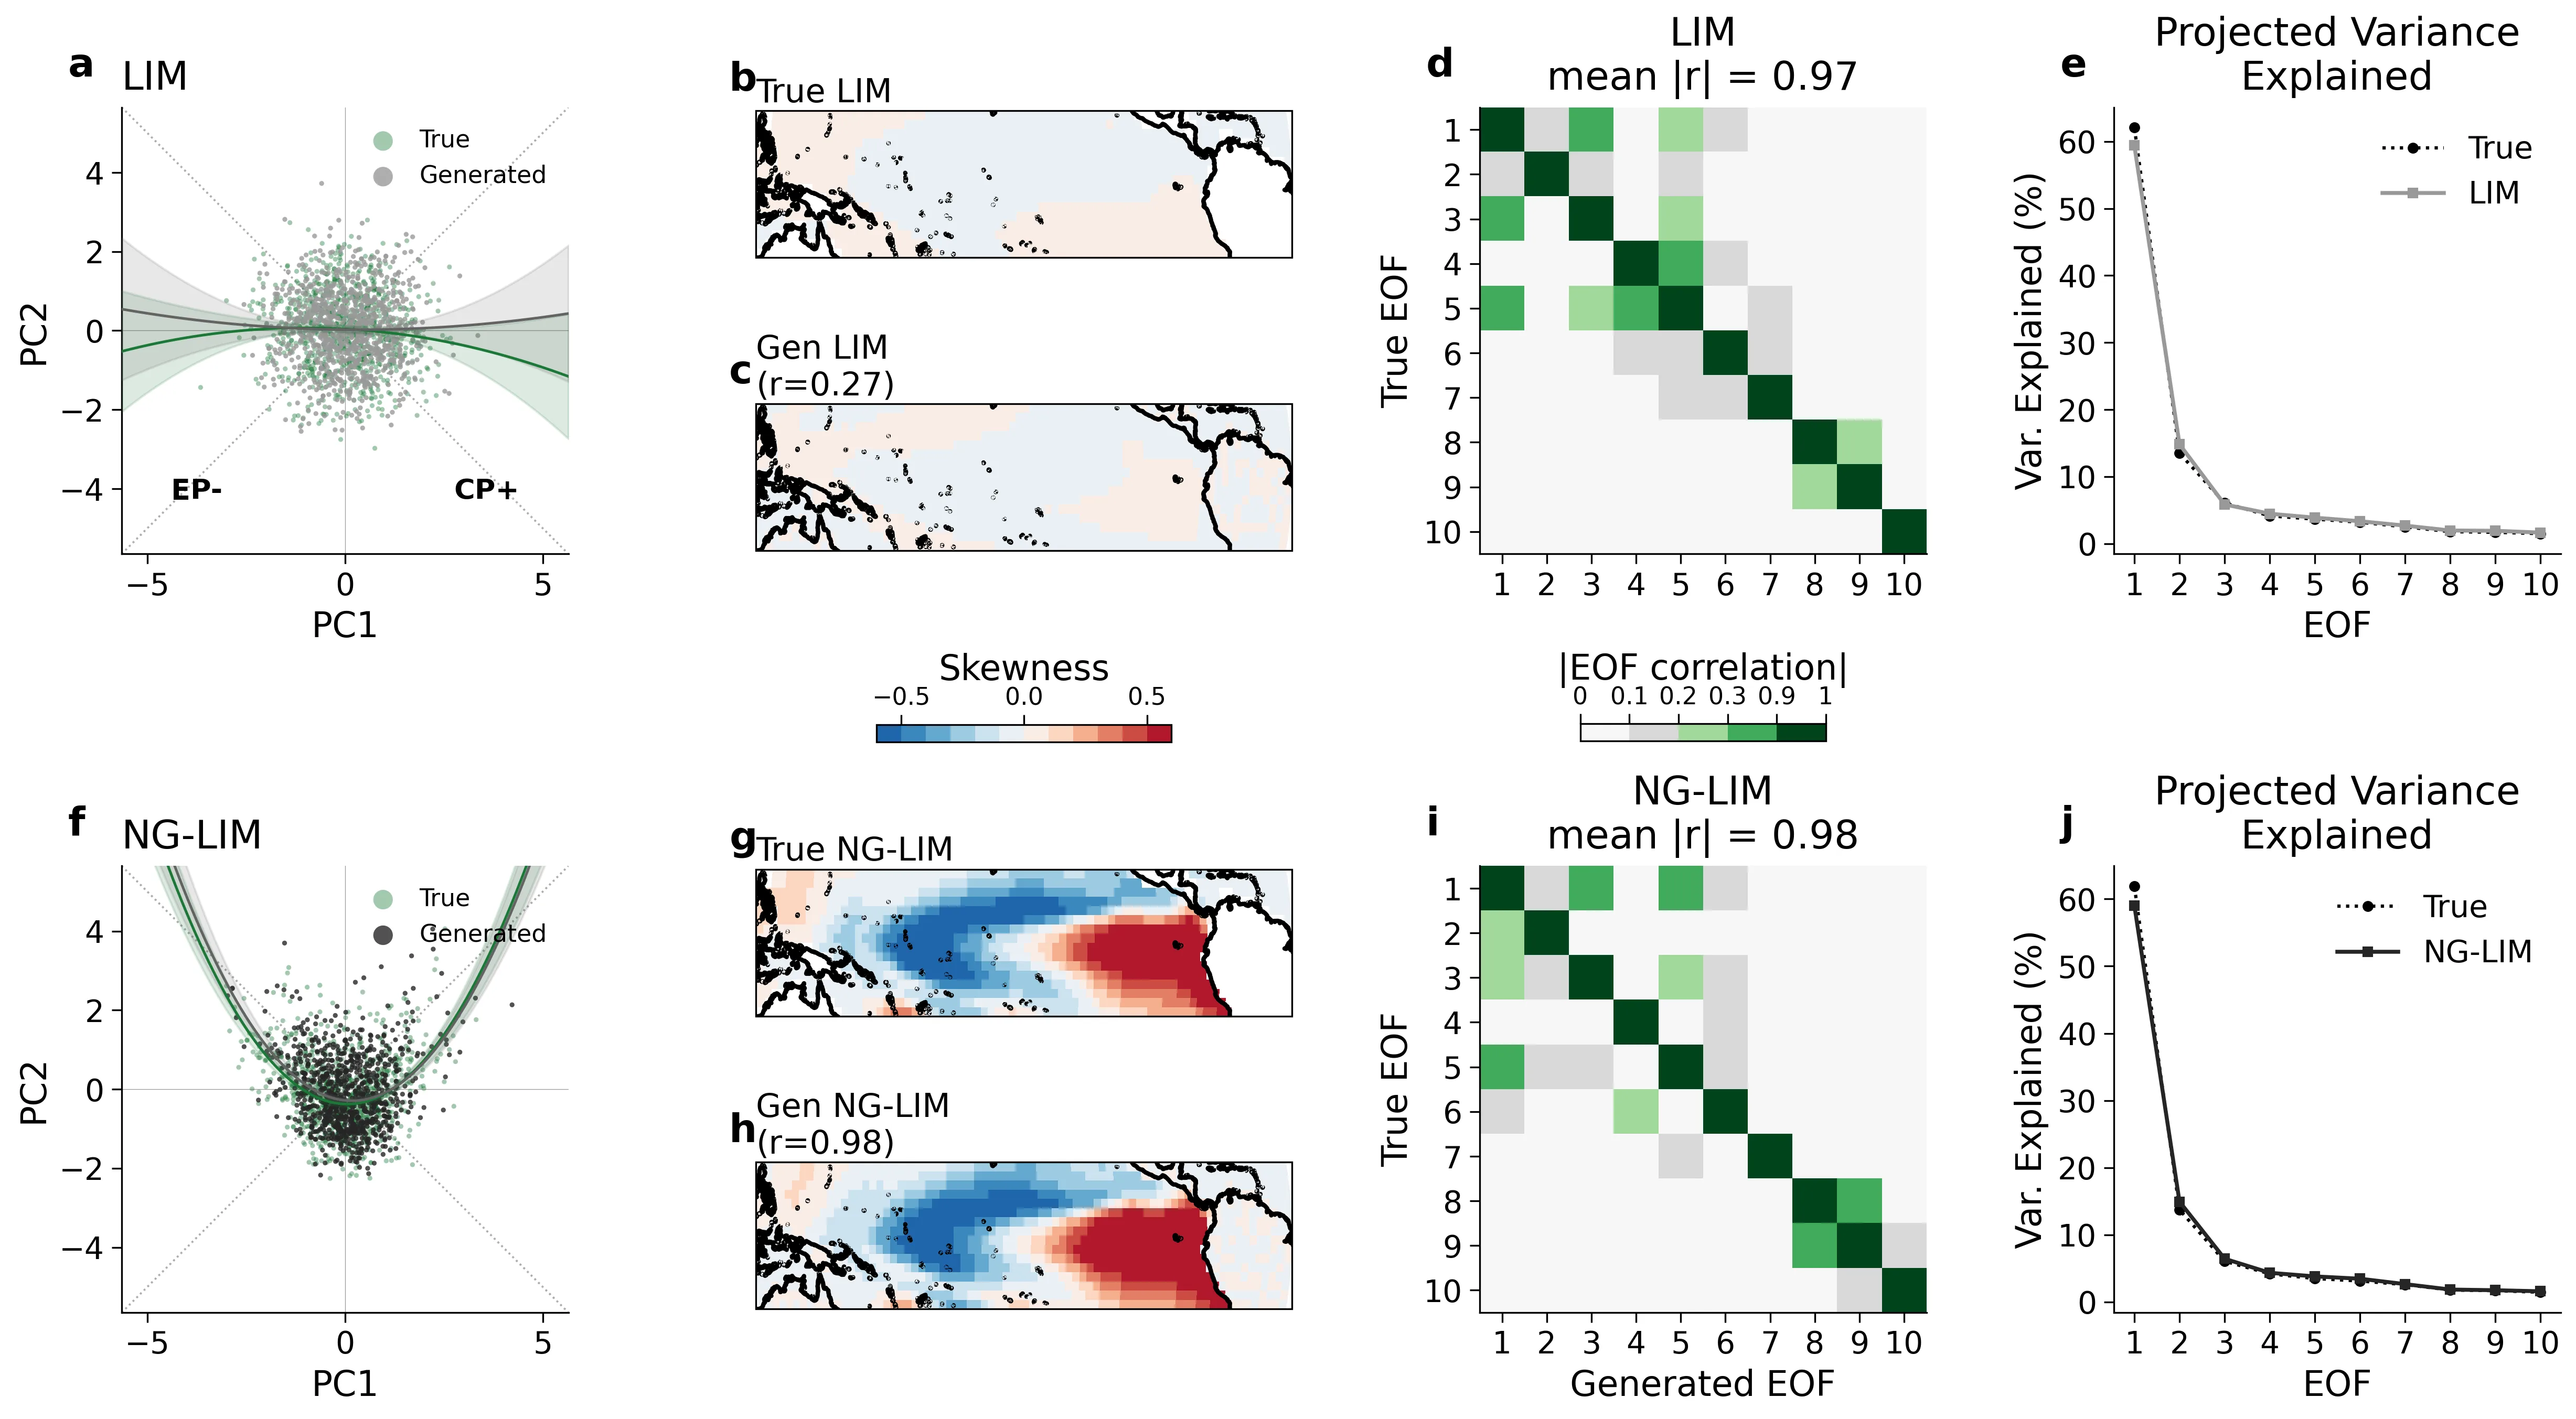
Los autores generaron 120 000 campos mensuales de temperatura superficial del Pacífico tropical mediante modelos lineales inversos calibrados con los datos del reanálisis ERSSTv5 de 1948 a 2022. Se usaron dos variantes: el LIM gaussiano estándar y el NG-LIM no lineal con la transformación de Yeo-Johnson, que reproduce mejor la asimetría entre fases cálidas y frías. El modelo de difusión se entrenó para predecir el campo de datos limpio a partir de una versión ruidosa, lo que, según la hipótesis, obliga a la red a centrarse en la estructura de baja dimensión. Para combatir la escasez de datos, se preentrenó el modelo con campos sintéticos de 30 modelos climáticos del proyecto CMIP6, añadiendo a la arquitectura un vector de incrustación de ocho dimensiones que codifica la identidad de cada modelo, y luego se ajustó solo ese vector con las 720 observaciones reales.
Resultados
Al entrenar con el conjunto sintético completo, el modelo de difusión reproduce con precisión tanto la estructura gaussiana como la no gaussiana: la correlación entre los patrones espaciales de las diez primeras funciones ortogonales empíricas supera 0.9, y los mapas de asimetría conservan la característica forma de herradura, con asimetría positiva en el este y negativa en el oeste. Sin embargo, la ablación sobre el número de muestras de entrenamiento mostró que todas las métricas convergen solo a 7000 muestras, mientras que en ERSSTv5 hay solo unas 720. Con ese déficit, el modelo comienza a memorizar ejemplos de entrenamiento: la distancia mediana al vecino más cercano cae por debajo de 0.6 del valor de referencia. De las tres variantes de parametrización de la difusión, solo la predicción de datos limpios supera todas las pruebas, mientras que la predicción de ruido falla por completo y la predicción de velocidad sobreestima la dimensión efectiva hasta el 19.6% de la varianza explicada. La estrategia de preentrenamiento con CMIP6 y ajuste solo de la incrustación alcanza una correlación de patrones superior a 0.85, una correlación de asimetría superior a 0.9 y un coeficiente de memorización de aproximadamente 0.95, superando en estos indicadores tanto al LIM estándar como al NG-LIM.
Implicaciones
El trabajo demuestra que los modelos de difusión pueden extraer una estructura de baja dimensión físicamente significativa de la variabilidad climática, si hay datos suficientes y la parametrización se elige correctamente. Pero la conclusión principal es que las observaciones por sí solas no bastan: se necesita un orden de magnitud más de datos de los que disponen los climatólogos. El esquema propuesto con incrustación de modelo convierte la diversidad de las simulaciones climáticas de una fuente de sesgos en un recurso que permite compensar el déficit de datos reales. Esto cambia la idea de cómo los modelos generativos pueden usarse en las ciencias de la Tierra: no como sustitutos de los modelos físicos, sino como herramienta para extraer estructura de muestras empíricas escasas.
Desarrollo futuro
La continuación natural es pasar de la generación incondicional, que reproduce solo la distribución de estados, a la condicional, donde el modelo genera el campo futuro a partir de un estado inicial dado. Esto abriría el camino a la emulación de la dinámica de El Niño y, posiblemente, a la predicción. Se necesitarán predictores más ricos: no solo la temperatura superficial, sino también el calor almacenado en la capa subsuperficial del océano y las tensiones del viento. Incluir en el preentrenamiento conjuntos de mayor resolución, como las nuevas simulaciones con convección explícita, podría mejorar aún más la precisión en la reproducción de las colas de la distribución.
Impacto
Los resultados son importantes para el modelado climático, la predicción estacional y la evaluación de riesgos de fenómenos extremos asociados a El Niño. El método puede transferirse a otros modos de variabilidad, como la oscilación del Atlántico Norte o la oscilación decadal del Pacífico, donde hay aún menos datos.
Próximos pasos
El paso más próximo es construir un modelo de difusión condicional que, a partir del estado actual del Pacífico tropical, genere un conjunto de posibles estados futuros. Luego habrá que comparar su precisión predictiva con los modelos estadísticos y dinámicos clásicos en datos históricos.
Problemas abiertos clave
El trabajo aborda directamente un problema fundamental de la climatología: cómo distinguir los modos reales de variabilidad de los artefactos de series de observaciones cortas. También contribuye al debate sobre qué arquitecturas de aprendizaje automático pueden captar una estructura de baja dimensión físicamente significativa y cuáles solo interpolan datos. Por último, el método propuesto de ajuste fino de la incrustación podría convertirse en una receta general para transferir conocimiento entre simulaciones climáticas heterogéneas y observaciones.
La mirada de la máquina del conocimiento
Esta sección está dirigida al autor del trabajo y a sus colegas. Los trabajos vecinos los encontró la búsqueda por significado en nuestro archivo, no por coincidencia de palabras. No evaluamos: mostramos el campo alrededor.
Qué hace el trabajo
Los autores comprobaron si los modelos de difusión son capaces de aprender la estructura de baja dimensión de la variabilidad climática de El Niño, utilizando datos sintéticos con una estructura conocida. Resultó que, con un volumen de muestra suficiente, los modelos reproducen con precisión tanto la estructura gaussiana como la no gaussiana, pero con datos reales (alrededor de 720 meses) comienzan a memorizar ejemplos. La solución se encontró en el preentrenamiento con un conjunto de simulaciones climáticas CMIP6, seguido de un ajuste fino de un pequeño vector de incrustación, lo que permite extraer más información de las escasas observaciones que los modelos lineales clásicos.
Dónde está su fuerza
La fortaleza del trabajo es un banco de pruebas controlado con datos sintéticos, donde se conoce la verdadera estructura de baja dimensión, lo que permite separar honestamente la generalización de la memorización. Esto proporciona una base sólida para verificar qué ha aprendido exactamente el modelo de difusión y abre el camino para su aplicación en datos reales.
Hacia dónde puede avanzar
- Podría ser interesante observar cómo el enfoque de preentrenamiento con CMIP6 y ajuste fino del embedding se transfiere a otras variables climáticas, como precipitación o presión, donde la estructura de variabilidad es menos pronunciada. En nuestro archivo hay un trabajo cercano donde una red neuronal ensambla el clima global a partir de piezas, lo que podría sugerir ideas para trabajar con campos espacialmente no homogéneos.se apoya en: Mosaico tormentoso: El modelo de IA STRATA ensambla el clima global pieza por pieza arXiv:2606.31248
- Quizás valga la pena considerar su aplicación al pronóstico de El Niño: un modelo de difusión entrenado con datos sintéticos podría usarse para generar conjuntos de pronósticos. En el archivo hay un análisis sobre la predicción de El Niño con un año y medio de anticipación, que puede ofrecer puntos de referencia para la comparación.se apoya en: El Niño puede predecirse con año y medio de antelación arXiv:2601.12251
- Sería interesante investigar cómo los modelos de difusión manejan el aprendizaje de invariantes algebraicos en datos climáticos, de manera similar a como una red neuronal aprende del esqueleto algebraico en un diagrama tropical. Esto podría proporcionar una nueva forma de verificar la relevancia física de las representaciones aprendidas.se apoya en: Plano tropical: la red neuronal aprende sobre un esqueleto algebraico arXiv:2607.00237
Vale la pena probar
- Probar la sustitución de datos sintéticos por observaciones reales de otras regiones con series más largas para el preentrenamiento.
- Verificar si la adición de restricciones físicas (por ejemplo, la conservación de la energía) mejora la calidad de la generación en muestras pequeñas.
- Utilizar el modelo de difusión para crear análogos sintéticos de El Niño y evaluar su impacto en el entrenamiento de modelos predictivos.
Por qué puede importar
Si los modelos de difusión pueden extraer de manera fiable la variabilidad climática de series de observaciones cortas, esto abrirá el camino hacia estimaciones más precisas de eventos raros y mejorará la comprensión de la dinámica a largo plazo del sistema, lo cual es importante para la adaptación al cambio climático.
Trabajos cercanos en nuestro archivo
- El Niño puede predecirse con año y medio de antelacióncercanía 0.54
- Pronóstico del tiempo con una sola tarjeta gráficacercanía 0.54
- Plano tropical: la red neuronal aprende sobre un esqueleto algebraicocercanía 0.50
- Mosaico tormentoso: El modelo de IA STRATA ensambla el clima global pieza por piezacercanía 0.50
- Una red neuronal traza un mapa gravitacional preciso de las galaxiascercanía 0.50
- El clima marciano con receta terrestrecercanía 0.49
El archivo está vacío alrededor de este trabajo: el análisis más cercano queda en 0.54, frente a un 0.64 habitual. Parece que aquí al lado casi nadie ha perforado.
Los modelos de difusión, que ahora generan rostros y paisajes realistas, se inspiraron originalmente en la termodinámica del no equilibrio, la ciencia de cómo los sistemas pasan del orden al caos. En este trabajo, ese mismo principio se invierte para recuperar estructuras ordenadas del clima a partir del ruido.
La idea de entrenar una máquina en multitud de mundos virtuales y luego ajustarla al único mundo real recuerda al relato de Ted Chiang «La historia de tu vida», donde una lingüista aprende el idioma de los alienígenas apoyándose en múltiples gramáticas hipotéticas para entender una sola gramática real.
Cifras clave
- 120 000: campos mensuales sintéticos utilizados para el entrenamiento
- 720: observaciones mensuales en ERSSTv5 de 1948 a 2022
- 7000: muestras necesarias para la convergencia de todas las métricas
- 10: componentes principales que explican el 90% de la variabilidad
- 0.95: correlación del patrón de asimetría en el mejor modelo