Los datos sintéticos se refieren a información generada artificialmente en lugar de recopilada de eventos del mundo real. En el contexto de los artículos proporcionados, se utilizan para entrenar modelos de aprendizaje automático sin exponerlos a datos reales de pacientes, que a menudo son sensibles y están protegidos por regulaciones de privacidad. El concepto es central en campos como la imagen médica, donde se pueden crear gemelos digitales de pacientes u órganos para simular condiciones y probar algoritmos de manera segura.
Historia
El término ganó prominencia en la década de 2010 con el auge del aprendizaje profundo, aunque la idea subyacente de generar datos artificiales para pruebas tiene raíces en técnicas de simulación anteriores. No se atribuye un inventor único.
Cómo funciona
El proceso generalmente implica el uso de modelos generativos, como redes generativas antagónicas (GAN) o autoencoders variacionales, para aprender la distribución estadística de los datos reales y luego muestrear nuevos ejemplos plausibles de esa distribución. Estos ejemplos sintéticos pueden etiquetarse con una verdad fundamental conocida, lo que permite entrenar y validar modelos en un entorno controlado. Los datos generados pueden imitar condiciones específicas, como diferentes estados de enfermedad o artefactos de imagen, que podrían ser raros o difíciles de obtener en conjuntos de datos reales.
En la práctica
Los datos sintéticos se utilizan para entrenar modelos de diagnóstico en imagen médica, para aumentar conjuntos de datos reales pequeños y para probar sistemas autónomos en entornos simulados antes de su implementación en el mundo real.
Dato curioso
Los datos sintéticos pueden usarse para generar imágenes de enfermedades raras que son tan escasas que los ejemplos reales serían insuficientes para entrenar un modelo de diagnóstico fiable.
A diferencia de las cámaras comunes, las cámaras de eventos solo registran los momentos en que la luz se vuelve más brillante o más tenue. No generan instantáneas, sino un flujo interminable de destellos. Los científicos transformaron este flujo en una imagen nítida de la Tierra mientras volaban sobre ella en un satélite.
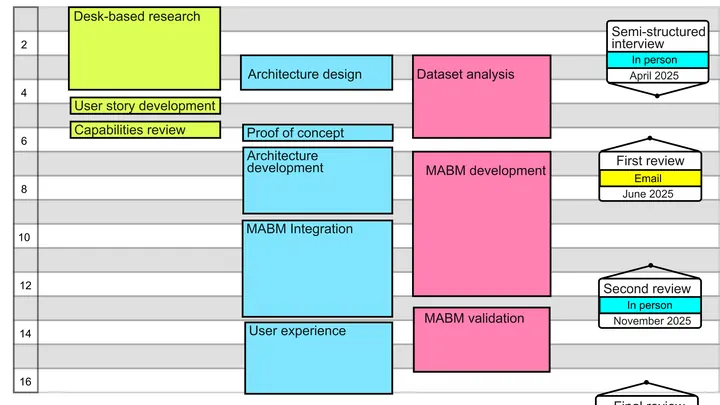
En cualquier proyecto urbano, el comportamiento de los habitantes es una fuerza invisible de la que depende el éxito. Un vecino indeciso puede retrasar la instalación de paneles solares en toda una manzana: su cautela desencadena un aumento del desorden.
Un cocinero que aprende a cocinar con dibujos corre el riesgo de arruinar cada plato. La misma trampa le espera a la visión por computadora: los modelos necesitan miles de imágenes etiquetadas, pero recopilarlas manualmente es costoso y tedioso. Las imágenes sintéticas resuelven el problema, solo si se ven realistas.
El método estándar de digitalización de voz: se toman lecturas de volumen miles de veces por segundo. Es como probar un caldo con una cucharadita: cada sorbo es aguado y casi no hay detalles. El flujo de datos se hincha, aunque el significado es ínfimo.
Los científicos propusieron primero ‘reducir’ la señal de audio.
Imagina una audición para una orquesta sinfónica, donde de cientos de aspirantes solo se quedan aquellos cuyos instrumentos suenan limpios y resisten un feroz crescendo. En el mundo de los materiales, las computadoras han aprendido a generar «partituras atómicas»: miles de cristales virtuales que prometen ser la base de chips cuánticos o superconductores.
Los 120 habitantes de Montelago no son personas, sino personajes digitales. Cada uno, además de un nombre y una biografía, tiene tres coordenadas ocultas: la confianza en las autoridades municipales, la evaluación de la fiabilidad de la fuente y la percepción de lo adecuada que es la información. Estos números los conocen los creadores, pero no el propio sistema.
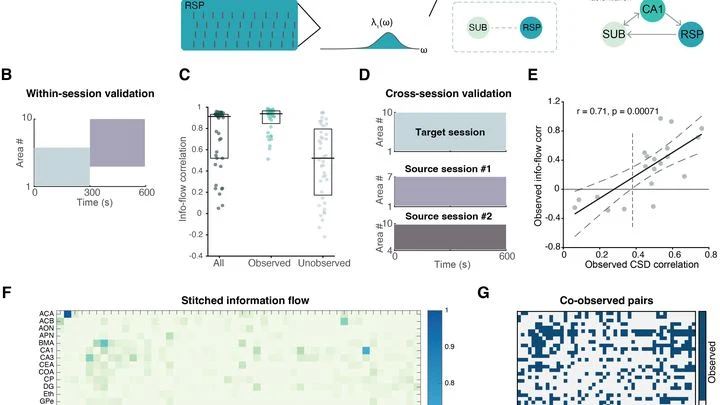
Una colcha de retazos donde cada retazo es un registro de la actividad de una pequeña región del cerebro. Un retazo se cosió el lunes en Londres, otro el martes en Nueva York, y un tercero hace un mes en Tokio. Todo este mosaico cubre el cerebro solo parcialmente, y no hay una costura común para unirlos.
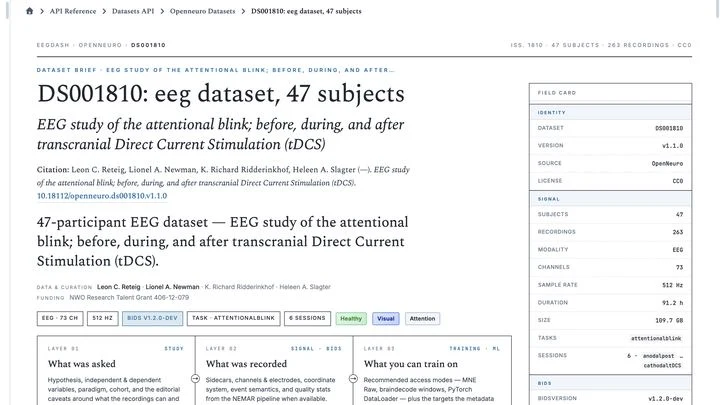
En los archivos abiertos OpenNeuro y NEMAR se almacenan 791 registros de la actividad eléctrica del cerebro de casi cuarenta mil personas. En total, son 86 051 horas de señales, aproximadamente diez años de escucha continua.
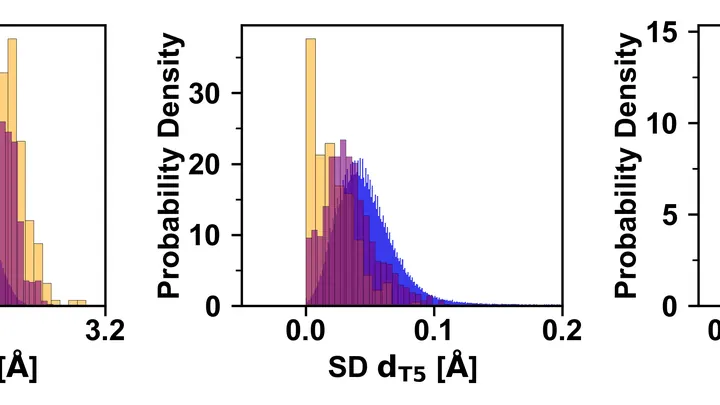
Danza de cientos de partículas: algunos pares giran lenta y suavemente, otros se sacuden a un ritmo frenético. Para entender la esencia del baile, hay que fijarse en los movimientos lentos: son la coreografía principal del sistema.
El brazo levanta una taza del estante: un movimiento habitual que no notamos hasta que los músculos se cansan. Entonces la trayectoria cambia: el codo se desvía un poco hacia un lado, la muñeca tiembla. Normalmente, el médico detecta estos cambios con las manos, palpando los músculos del paciente.
El hidrógeno es el campeón en energía por kilogramo, pero almacenarlo es un dolor de cabeza. En forma de gas ocupa un volumen enorme, y si se comprime o se enfría hasta licuarlo, se necesitan tanques pesados y mucha energía. Hay un tercer camino: algunos materiales sólidos absorben hidrógeno como una esponja absorbe agua y lo retienen en su interior.
Un cocinero prueba la sopa después de cada pizca de sal y decide al instante qué añadir a continuación. Algo así hace la nueva instalación para cultivar películas cristalinas delgadas. Solo que en lugar del sabor, lo que se observa es la imagen de un microscopio electrónico, y en lugar del cocinero, actúa un programa informático.
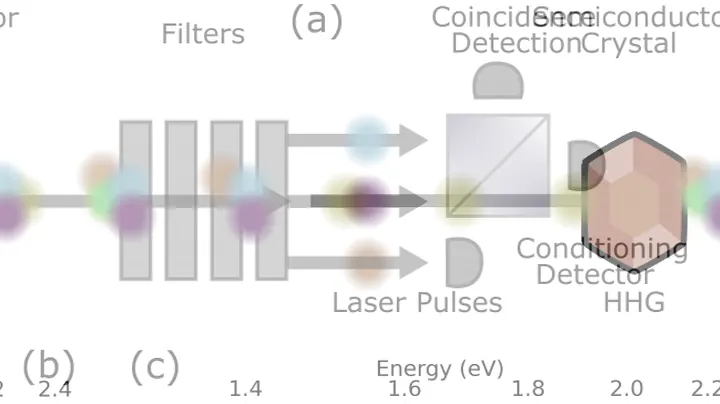
Un potente láser golpea el semiconductor, y este responde con luz en muchas frecuencias, como una cuerda que resuena con un coro de armónicos. Antes esto se usaba en espectroscopia para observar procesos ultrarrápidos.
Por la noche, la persona respira y, según el ritmo de esa respiración, se puede decir mucho sobre su sueño. Pero normalmente los médicos observan las ondas eléctricas del cerebro, que se registran con sensores colocados en la cabeza. El nuevo trabajo muestra cómo, a partir de la sola respiración, se pueden reconstruir esas ondas sin tocar la cabeza.
Las zeolitas, minerales porosos, funcionan como esponjas diminutas con orificios de un tamaño estrictamente definido. A través de esos orificios pasan moléculas de un tipo y se quedan atrapadas otras; así funcionan la purificación del agua, la separación de gases y la catálisis en la petroquímica.
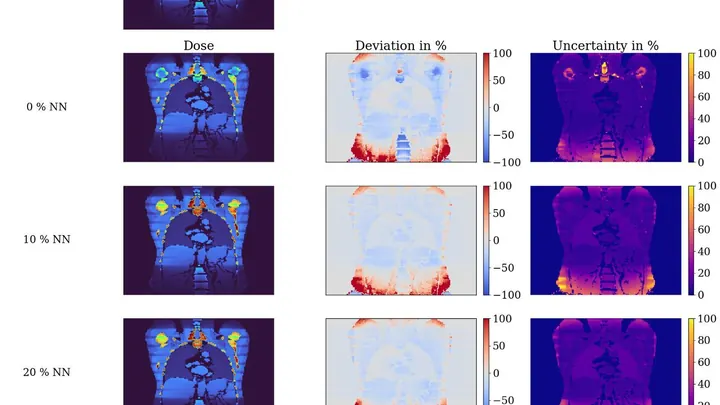
La tomografía computarizada es como una radiografía que toma cientos de imágenes desde distintos ángulos y con ellas construye una imagen tridimensional del cuerpo. Pero cada imagen implica una pequeña dosis de radiación, y los médicos necesitan saber cuánta recibe cada órgano.