Un graphe plutôt que des poids : comment sélectionner les meilleures prévisions d'El Niño ✛
Contexte
Ce travail s'inscrit à côté d'études où les réseaux de neurones tentent déjà de renforcer la prévision d'El Niño : certains apprennent sur des graphes, d'autres captent le signal dans le lentillage faible ou dans le bruit des détecteurs. Ici, la tâche est différente : il ne s'agit pas d'entraîner un nouveau modèle, mais de comprendre un ensemble déjà prêt de 80 prévisions. Auparavant, on les moyennait simplement avec des poids basés sur la précision globale des modules, sans examiner à quel point les prévisions individuelles se ressemblaient. Les auteurs introduisent une structure de graphe où la similarité entre les prévisions devient explicite, ce qui permet d'éliminer le bruit et de conserver un noyau cohérent.
Méthodes
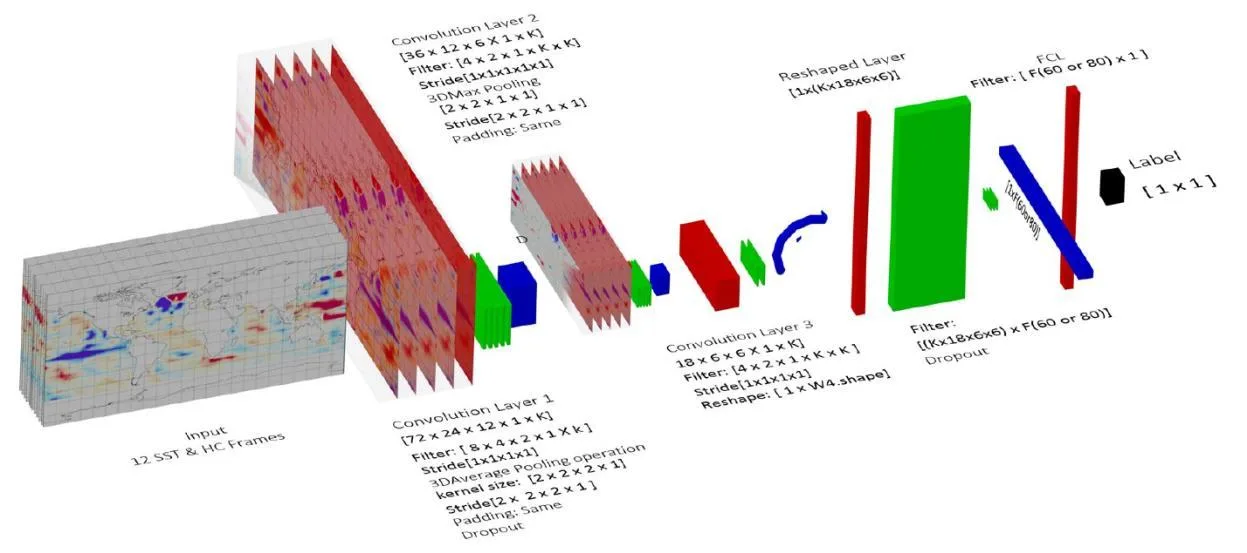
D'abord, le modèle MEF produit 80 prévisions : 40 provenant du réseau convolutif 3D, qui traite les cartes d'anomalies de température de l'océan comme des vidéos, et 40 du module de séries temporelles. Ensuite, chaque prévision devient un nœud d'un graphe non orienté et pondéré. Le poids de l'arête entre deux prévisions est calculé selon leur similarité : on utilise l'erreur quadratique moyenne et la corrélation de Pearson. Aux nœuds, on ajoute des caractéristiques telles que l'erreur et la lissité de la série temporelle. Ensuite, un algorithme de graphe identifie des communautés, c'est-à-dire des groupes de prévisions qui se comportent de manière similaire. À partir de la communauté la plus dense et la plus précise, on prend 20 prévisions et on les moyenne. Les calculs ont été effectués sur des cartes graphiques NVIDIA Tesla A100 dans Google Colab, avec environ un téraoctet de données provenant de 21 modèles CMIP5 et d'observations GODAS.
Résultats
La sélection par graphe a amélioré la corrélation de la prévision d'environ 10 % par rapport au modèle MEF original, en particulier pour les échéances supérieures à un an. Pour tous les horizons de 1 à 23 mois, la corrélation est restée supérieure à 0,4, et à 23 mois, le modèle a capté près de la moitié de tous les événements El Niño et La Niña. Les 20 prévisions sélectionnées ne sont pas seulement plus précises individuellement : elles présentent une plus faible dispersion de l'erreur entre les différentes échéances, des transitions plus lisses entre les phases et une connectivité plus dense dans le graphe. Cependant, l'approche par graphe ne bat pas toujours le MEF de base dans chaque scénario individuel, mais elle donne des résultats plus stables et plus cohérents, en particulier dans les cas complexes à long horizon.
Implications
Contrairement aux travaux voisins où les réseaux de neurones à graphes apprennent à prédire eux-mêmes ou améliorent des modèles individuels, ici le graphe est utilisé comme un méta-outil : il ne fait pas de prévision, mais met de l'ordre dans un ensemble déjà prêt. C'est la première vérification que la similarité structurelle entre les prévisions peut servir de filtre à bruit sans modifier le modèle lui-même. Cette approche est indépendante du modèle et transférable à tout système d'ensemble, des modèles climatiques dynamiques aux schémas statistiques hybrides.
Développements futurs
L'analyse par graphe des ensembles pourrait devenir une étape standard de post-traitement dans la prévision saisonnière et sous-saisonnière. Si l'on apprend à construire rapidement des graphes de similarité pour des milliers de membres d'ensemble, la sélection du noyau cohérent deviendra une opération de routine. Ensuite, on pourra essayer différentes mesures de similarité : déformation dynamique temporelle, distance cosinus, caractéristiques entropiques. Un intérêt particulier est de comprendre pourquoi les prévisions sélectionnées forment une communauté dense et quels mécanismes physiques se cachent derrière.
Impact
La méthode s'applique à tout système produisant de nombreuses prévisions : des modèles climatiques aux ensembles financiers ou épidémiologiques. Dans la prévision opérationnelle d'El Niño, elle pourrait accroître la fiabilité des alertes de sécheresses, d'inondations et de chaleurs anormales plusieurs mois à l'avance.
Prochaines étapes
Tester la méthode sur d'autres systèmes d'ensemble, par exemple les modèles dynamiques C3S ou les prévisions sous-saisonnières. Étudier comment le choix de la mesure de similarité et de la taille de la communauté influence la qualité de la sélection.
Problèmes ouverts clés
Ce travail aborde un problème de longue date en climatologie : la barrière de prévisibilité printanière, où la compétence des modèles chute brusquement lors du passage du printemps. La sélection par graphe n'élimine pas complètement la barrière, mais rend la prévision plus robuste sur les longues échéances, là où les méthodes classiques se dégradent. C'est un pas vers la compréhension de la manière d'extraire le signal d'un ensemble bruité dans un contexte de variabilité climatique croissante après 2000.
Le regard de la machine du savoir
Cette section s'adresse à l'auteur du travail et à ses collègues. Les travaux voisins ont été trouvés par une recherche sémantique dans notre archive, et non par correspondance de mots. Nous n'évaluons pas : nous montrons le champ autour.
Ce que fait ce travail
Les auteurs ont pris un ensemble de 80 prévisions du modèle MEF (40 issues d'un réseau convolutif 3D, 40 d'un module de séries temporelles), ont construit un graphe dont les nœuds sont les prévisions et les arêtes leur similarité en termes d'erreur et de corrélation, puis ont identifié des communautés et sélectionné les 20 prévisions les plus cohérentes et précises. La moyenne de ce noyau a amélioré la corrélation d'environ 10 % sur les horizons longs et a maintenu un skill supérieur à 0,4 pour tous les délais jusqu'à 23 mois.
Où est sa force
Ce travail introduit le graphe comme un méta-outil pour filtrer le bruit dans un ensemble déjà constitué, sans modifier le modèle lui-même. Cette approche est agnostique au modèle et transférable à d'autres systèmes d'ensemble.
Vers où avancer
- Il pourrait être intéressant de voir comment la sélection par graphe se comporte sur d'autres prévisions d'ensemble d'El Niño, par exemple dans un travail où un réseau de neurones prédit El Niño un an et demi à l'avance. Transposer la méthode à leur ensemble permettrait de tester l'universalité de l'approche.appui : El Niño se laisse prédire dix-huit mois à l'avance arXiv:2601.12251
- À proximité se trouve un travail sur la prévision météorologique avec une seule carte graphique, qui utilise une architecture efficace. On pourrait tenter de combiner la sélection par graphe avec leur modèle rapide pour gagner à la fois en vitesse et en qualité d'ensemble.appui : Prévisions météo sur une seule carte graphique arXiv:2603.21284
- Dans les archives, il y a un travail sur la compression de réseaux où les routes deviennent des points : là aussi, on sélectionne des éléments selon leur connectivité. Leurs métriques d'importance des nœuds pourraient peut-être aider à améliorer la détection de communautés dans le graphe des prévisions.appui : Compresser les réseaux : quand les routes deviennent des points arXiv:2607.14834
À essayer
- Essayer d'autres métriques de similarité entre prévisions, par exemple la corrélation dynamique ou la distance dans l'espace des états.
- Vérifier comment le résultat dépend de la taille du noyau sélectionné (pas seulement 20 sur 80).
- Appliquer la sélection par graphe à un ensemble de différents modèles (CMIP5 et observations), pas seulement aux prévisions d'un seul modèle.
Pourquoi cela peut compter
Si la sélection par graphe améliore effectivement de manière robuste les prévisions à long terme d'El Niño, elle pourrait devenir un post-traitement standard pour les ensembles en modélisation climatique, augmentant la fiabilité des prévisions d'événements extrêmes.
Travaux voisins dans notre archive
- El Niño se laisse prédire dix-huit mois à l'avanceproximité 0.49
- Un réseau de neurones qui sent les tensions dans les pièces de toutes formesproximité 0.49
- Un réseau de neurones apprend à lire les molécules grâce à l'empreinte du carboneproximité 0.49
- Prévisions météo sur une seule carte graphiqueproximité 0.47
- Sculpteur neuronal : comment interpréter une lentille gravitationnelle à partir de quatre pointsproximité 0.47
- SpecFANN : Esquisse éclair du spectre stellaireproximité 0.47
- Compresser les réseaux : quand les routes deviennent des pointsproximité 0.46
L'archive est vide autour de ce travail : l'analyse la plus proche n'est qu'à 0.49, contre 0,64 d'ordinaire. Il semble qu'on ait peu foré à côté.
Le modèle a été entraîné sur des données de 1875 à 1975, puis testé sur 2000–2017. Entre ces périodes, il y a un quart de siècle que le modèle n'a jamais vu. Cet écart a été laissé exprès pour éviter l'effet de mémoire de l'océan et vérifier si la prévision fonctionne dans des conditions complètement différentes.
Chiffres clés
- membres de l'ensemble au total: 80
- prévisions sélectionnées: 20
- horizon de prévision: jusqu'à 23 mois
- corrélation sur toutes les échéances: supérieure à 0,4
- amélioration de la corrélation: environ 10 %