L'estimation par maximum de vraisemblance (EMV) est une pierre angulaire de l'inférence statistique. Elle offre une méthode rigoureuse pour choisir les paramètres d'une distribution de probabilité qui expliquent le mieux les données observées. Étant donné un ensemble de points de données et un modèle candidat (par exemple, une distribution normale avec une moyenne et une variance inconnues), l'EMV sélectionne les valeurs des paramètres qui rendent les données observées les plus probables sous ce modèle. Cette « probabilité maximale » est quantifiée par la fonction de vraisemblance, qui mesure la probabilité des données en fonction des paramètres.
Histoire
La méthode a été introduite par Ronald Fisher dans les années 1920, en s'appuyant sur des travaux antérieurs de Carl Friedrich Gauss et d'autres. Fisher a formalisé le concept et établi ses propriétés souhaitables, telles que la convergence et l'efficacité.
Comment ça marche
La fonction de vraisemblance L(θ | données) est construite comme le produit des probabilités (ou densités de probabilité) de chaque point de données observé, étant donné le vecteur de paramètres θ. L'EMV trouve le θ qui maximise ce produit. En pratique, on maximise souvent la log-vraisemblance (le logarithme népérien de L) car elle transforme le produit en somme, ce qui est plus facile à dériver et numériquement stable. Le maximum est trouvé en annulant la dérivée de la log-vraisemblance par rapport à θ et en résolvant, ou en utilisant des algorithmes d'optimisation numérique itératifs lorsqu'aucune solution analytique n'existe.
En pratique
L'EMV est omniprésente en science et en ingénierie : elle sous-tend l'analyse de régression, l'entraînement des réseaux de neurones (via la perte d'entropie croisée) et l'estimation des paramètres dans les expériences de physique, de la physique des particules à la cosmologie.
Anecdote
L'EMV n'est pas toujours sans biais : par exemple, l'estimation par maximum de vraisemblance de la variance d'une distribution normale est biaisée vers le bas d'un facteur (n-1)/n, ce qui explique pourquoi la variance d'échantillon utilise n-1.
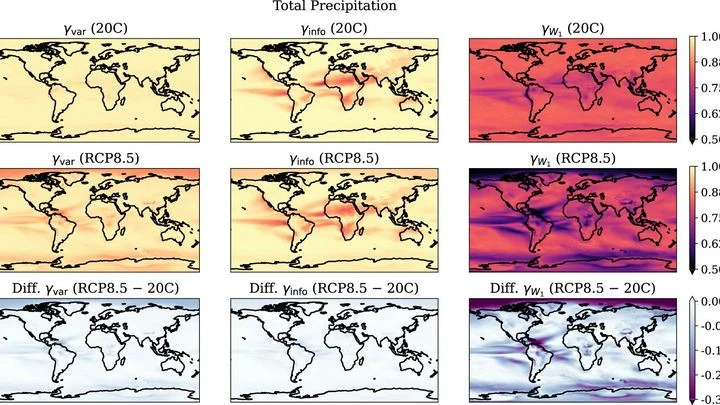
En hiver, dans un quartier de la ville, il tombe trois fois plus de neige que dans le quartier voisin. Une année, c'est la canicule, l'autre, le froid. Ce sont les caprices de la météo. Mais sur des décennies, on observe un autre glissement, plus lent : les hivers deviennent en moyenne plus doux. Distinguer l'un de l'autre est la tâche principale des climatologues.
En 1998, le mathématicien David Boyd a remarqué une chose étrange. Il étudiait la mesure de Mahler d'un polynôme — une quantité qui mesure la « complexité » de ses racines — et a découvert que pour une famille de courbes, elle s'exprime toujours par un nombre rationnel spécial, multiplié par la valeur de la dérivée de la fonction L.
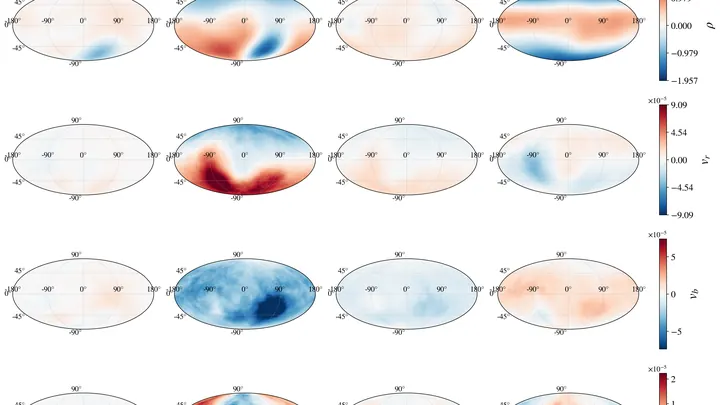
Deux galaxies – notre Voie lactée et son compagnon, le Grand Nuage de Magellan – tournent lentement l'une autour de l'autre. Leur attraction gravitationnelle agite les confins lointains de la Voie lactée, comme un caillou jeté dans un étang fait onduler l'eau.
Deux cents millions d'étoiles. Dans le centre de la Galaxie, où le futur relevé du télescope Nancy Grace Roman se concentrera, environ 250 fois au cours de la mission, la lumière de l'une d'elles vacillera sous une caresse invisible.
4 610 univers — c'est exactement le nombre de modèles cosmologiques qu'il a fallu aux astrophysiciens pour montrer que le masque gaussien ne fonctionne plus pour les données de nouvelle génération.
Reconstituer une image complète à partir de fragments, c'est un peu comme essayer de distinguer la mélodie d'un orchestre dans une salle bruyante. De telles tâches se posent en photométrie, où l'on reconstitue la luminosité d'une étoile à partir de faibles scintillements.
Le livre de recettes se réécrit de génération en génération, mais un jour, la recette du bortsch reçoit un ingrédient secret d'un pâtissier. Dès lors, le goût ne se souvient plus seulement des ancêtres, mais aussi du voisin. Dans le modèle standard de l'évolution, les gènes se comportent de la même manière.
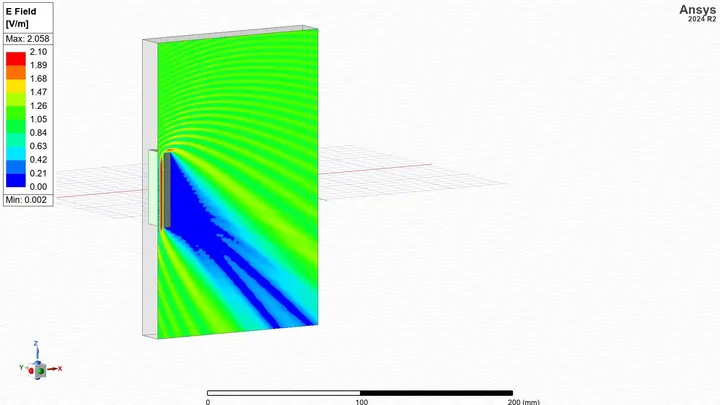
Lorsqu'une onde radio rencontre un bâtiment sur son chemin, elle ne se contente pas de se réfléchir ou d'être absorbée : elle le contourne, un peu comme les vagues de la mer épousent un rocher, laissant derrière lui une eau calme.
Les puces neuromorphiques fonctionnent différemment des ordinateurs classiques, construits selon les plans de John von Neumann, avec une mémoire et un processeur séparés.
Les assistants logiciels d'écriture de code agissent souvent comme un cuisinier qui, pour faire cuire un seul œuf, relit tout son livre de recettes. Face à une demande de correction minuscule, ils rouvrent des dizaines de fichiers et vérifient des liens connus depuis longtemps. C'est du travail inutile — de l'énergie gaspillée.
Des chercheurs ont pris 16 activités quotidiennes — de la vaisselle aux squats — et ont décomposé les mouvements en composantes élémentaires, un peu comme un spectroscope décompose la lumière en spectre. En comparant trois approches, ils ont trouvé une clé inattendue pour la reconnaissance : une simple image moyenne suffit.
Plongez votre regard dans le ciel nocturne : ce n'est pas un semis d'étoiles, mais un manuscrit à plusieurs couches. Sous l'encre brillante des étoiles et des galaxies transparaît un texte pâle, presque effacé.
La lumière coule comme une rivière invisible. Si l'on place un obstacle sur son passage, l'eau tourbillonne. De même, des surfaces spéciales créent des « tourbillons » de lumière qui piègent les nanoparticules comme des brindilles.
Un remorqueur spatial à moteur ionique accélère lentement, mais consomme très peu de carburant. Pour passer d'une orbite à une autre, il faut résoudre un problème délicat : combien de temps allumer le moteur et où le diriger. On cherche généralement le trajet le plus rapide pour une masse donnée de l'engin.
Un médecin feuillette un dossier médical et voit une ligne : « Ce médicament réduit le risque ». Mais à quel point peut-on s'y fier ? L'affirmation repose-t-elle sur quelques cas cliniques ou sur des dizaines de milliers de patients dans une étude en aveugle ? De la réponse dépend le traitement.
L'Univers n'est pas silencieux : il est parcouru d'un bourdonnement continu d'ondes gravitationnelles. Dans une décennie, l'observatoire spatial LISA accordera ses « oreilles » sur la gamme des millihertz, et notre Galaxie s'avérera être la source la plus riche — des dizaines de milliers de paires de naines…
Le trou noir n'est pas un vide figé, mais un moteur magnétique vivant. Son « cœur » — le disque d'accrétion — pulse : à l'inspiration, la matière s'enroule en entonnoir ; à l'expiration, la reconnexion magnétique déchire les lignes de champ, et le plasma jaillit loin de l'horizon.
Nous avons l'habitude de penser que ne remarquer que les confirmations de nos intuitions est une erreur. Mais des calculs récents, inspirés par le comportement des vagues, renversent ce point de vue. Il s'avère que l'habitude de chercher ce qui est familier est le meilleur moyen de réduire le bruit informationnel (les scientifiques l'appellent entropie).
Un réseau social ressemble à une ville : il y a des quartiers géants et des ruelles minuscules. Quand un algorithme y cherche des groupes soudés, il sort souvent deux ou trois énormes ensembles et beaucoup de petits fragments. Mais le client — par exemple, une municipalité — a besoin de quartiers à peu près de la même taille pour répartir équitablement les cliniques ou les écoles.
Un enregistrement sur dictaphone d'une place de ville. On entend le bourdonnement de la foule, des pas, des bribes de conversations, le bruit des voitures. Quelque part dans ce mélange de sons, un musicien de rue joue une mélodie simple à la flûte. L'entendre n'est pas facile — il y a trop de choses mélangées.
Une usine où des centaines de minuscules chaînes de montage tournent sans arrêt. Chaque chaîne est un moteur moléculaire qui convertit un carburant chimique en mouvement. Pour que le moteur aille plus vite ou dans la bonne direction, l'ingénieur modifie les réglages — la forme des pièces, la force des interactions.
Vous goûtez un plat au restaurant, mais vous n'avez pas vu le menu. Vous posez des questions au serveur — trop salé ? avec quelles épices ? — et à partir des réponses, vous essayez de deviner quel chef l'a préparé.
Un thermostat maintient une pièce à 20 degrés. Ouvrez la fenêtre en hiver – il enclenche le chauffage pour rétablir l'équilibre. Le cerveau fait quelque chose de similaire : il prédit constamment ce qui va se passer l'instant d'après et se corrige s'il se trompe. C'est ainsi qu'il apprend.
Les calculs quantiques sont une recette avec des ingrédients parfaits, mais le chef nature cuisine à sa façon. Les modèles de machine des atomes apprennent la recette par cœur et prédisent les propriétés de la matière en quelques secondes au lieu de semaines.
Une bibliothèque de 27 000 livres, et tous sur le béton. Dans chacun, on trouve la recette du mélange, la température, la résistance. Mais ces informations sont dispersées dans des paragraphes, des tableaux et des notes de bas de page. Pour qu'une personne les rassemble, il faudrait des années. Le programme, lui, a réussi en une heure.
Un film mince pour panneau solaire ou écran, c'est comme une foule dense sur une place : chaque personne est tournée dans sa direction, et de la direction de tous dépend si la lumière traversera la foule ou restera bloquée. Dans l'électronique organique, les molécules jouent le rôle des passants.
Une épidémie, ce n'est pas seulement un virus, c'est aussi des millions de décisions personnelles. L'un continue de prendre le métro, l'autre s'enferme chez lui. Les modèles classiques décrivent le comportement moyen de la foule, mais ne se demandent pas pourquoi chacun agit ainsi.
Lorsqu'un neutron ou un proton pénètre dans un noyau atomique, il se comporte comme une balle qui frappe un mur irrégulier : la rebond peut varier selon l'endroit où il touche.
La pince optique est un faisceau lumineux qui capture et déplace de minuscules objets comme des bactéries ou des grains de poussière. Pour transporter une particule d'un point A à un point B, on pourrait la tirer en ligne droite. Mais cela consommerait plus d'énergie qu'un trajet détourné astucieux.
Un chimiste à la recherche d'un nouveau médicament ressemble à un cuisinier sans recette : il a une liste de propriétés souhaitées, mais des millions d'ingrédients possibles. Chaque essai coûte cher et prend du temps, il faut donc procéder avec méthode.
Le nouveau programme SEISMO agit comme un cuisinier qui goûte le plat après chaque étape et décide aussitôt quoi ajouter ensuite.
Lorsqu'un quark top naît dans un détecteur de particules, il se désintègre aussitôt en une pluie d'autres particules. Saisir dans cette pluie un indice de nouvelle physique, c'est comme essayer d'entendre un murmure dans un concert de rock.
Les électrons, ces minuscules particules dans les molécules, manœuvrent constamment, évitant les collisions comme des passagers à l'heure de pointe. Pour calculer leur comportement, les scientifiques définissent une règle de distance personnelle : une fonction mathématique qui indique à quel point un électron peut s'approcher de son voisin.
Dans une pièce avec 80 conseillers, chacun crie sa vérité, et si l'on se contente d'écouter tout le monde et de faire la moyenne, on obtient un brouet. Il en va de même pour les prévisions d'El Niño : le modèle produit 80 scénarios d'avenir, mais ils ne sont pas tous aussi utiles. Certains se trompent moins souvent, d'autres plus, et d'autres encore parlent d'autre chose.