Des molécules en laisse : le calcul rapide des médicaments express
Il faut essayer des millions de clés pour trouver celle qui ouvrira la serrure de la maladie. Chaque clé est une molécule, et la serrure est une protéine de notre corps. Il est impossible de tester chaque clé manuellement, c'est pourquoi les chimistes utilisent des modèles informatiques qui prédisent comment une molécule se comportera dans la réalité. Jusqu'à récemment, des calculs précis prenaient des heures, voire des jours, sur des ordinateurs puissants. Le nouvel outil AceFF fait cela en quelques secondes.
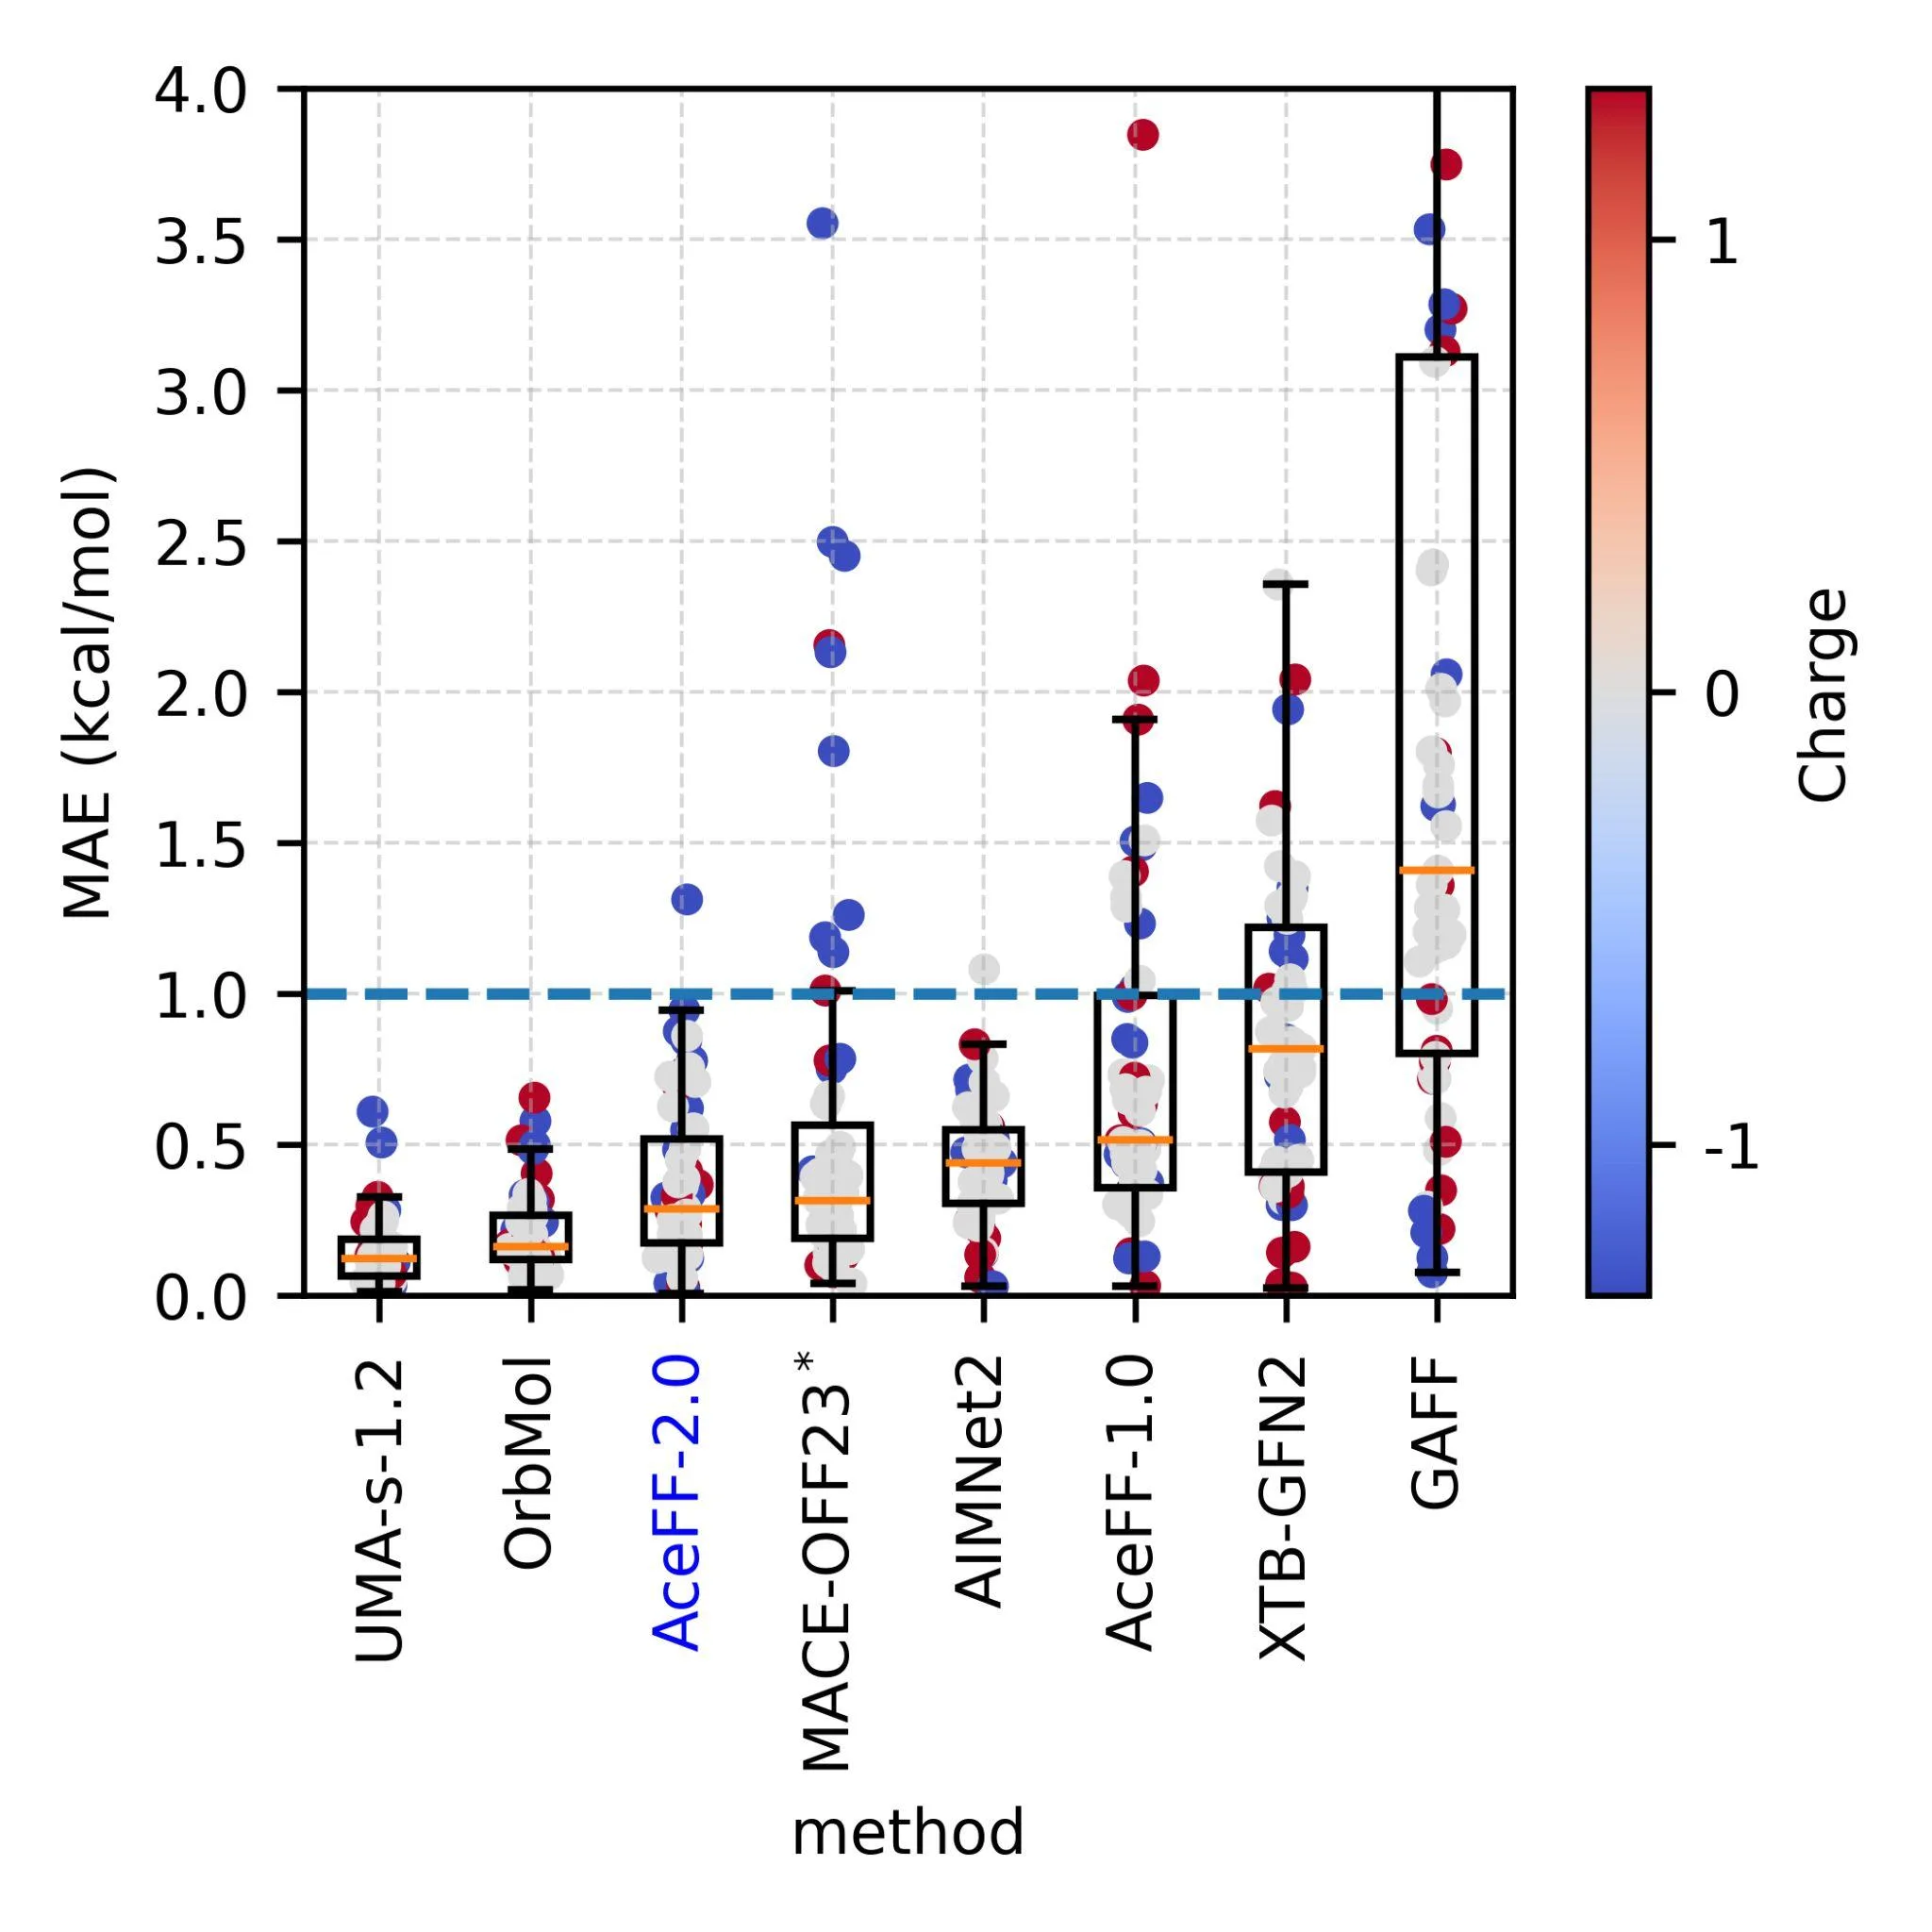
AceFF est un modèle pré-entraîné sur un vaste ensemble de données, qui comprend comment les atomes dans les molécules s'attirent, se repoussent et tournent autour des liaisons. Il a été entraîné sur des exemples de molécules similaires à celles utilisées dans les médicaments : avec du carbone, de l'azote, de l'oxygène, du soufre et d'autres éléments. L'essentiel est que le modèle ne se contente pas de mémoriser, mais déduit des règles générales, il peut donc gérer même de nouvelles molécules jamais vues auparavant. Lors des tests, il a montré une précision au niveau des calculs quantiques les plus stricts, mais fonctionne des milliers de fois plus vite.
La recherche d'un nouveau médicament, c'est comme chercher une aiguille dans une botte de foin. Il faut tester des millions de variantes, et si chaque calcul prend une heure, le processus s'étire sur des années. AceFF réduit ce temps à quelques minutes. Le modèle est déjà disponible en accès libre, et tout chercheur peut le télécharger et l'utiliser dans son travail. C'est comme donner à chaque chimiste un superordinateur personnel qui tient dans la poche.
Cette approche change l'idée même de la recherche de médicaments. Au lieu de synthétiser et de tester des centaines de substances en laboratoire, les scientifiques peuvent d'abord passer des millions de candidats au crible de l'ordinateur, sélectionner les plus prometteurs, puis passer aux expériences. Cela économise des années de travail et des millions de dollars.
Le modèle AceFF a été entraîné sur un ensemble de données comprenant plus de 1,5 million de configurations moléculaires — c'est comme si vous appreniez le comportement de tous les habitants d'une petite ville pour prédire leurs déplacements.