Comment distinguer une mutation dangereuse d'une mutation inoffensive express
Dans une immense bibliothèque où chaque livre est un gène, il faut trouver une seule faute de frappe. L'erreur peut être anodine, ou bien changer complètement le sens de la phrase. C'est à peu près ainsi que les généticiens cherchent des mutations nocives parmi des millions de différences inoffensives.
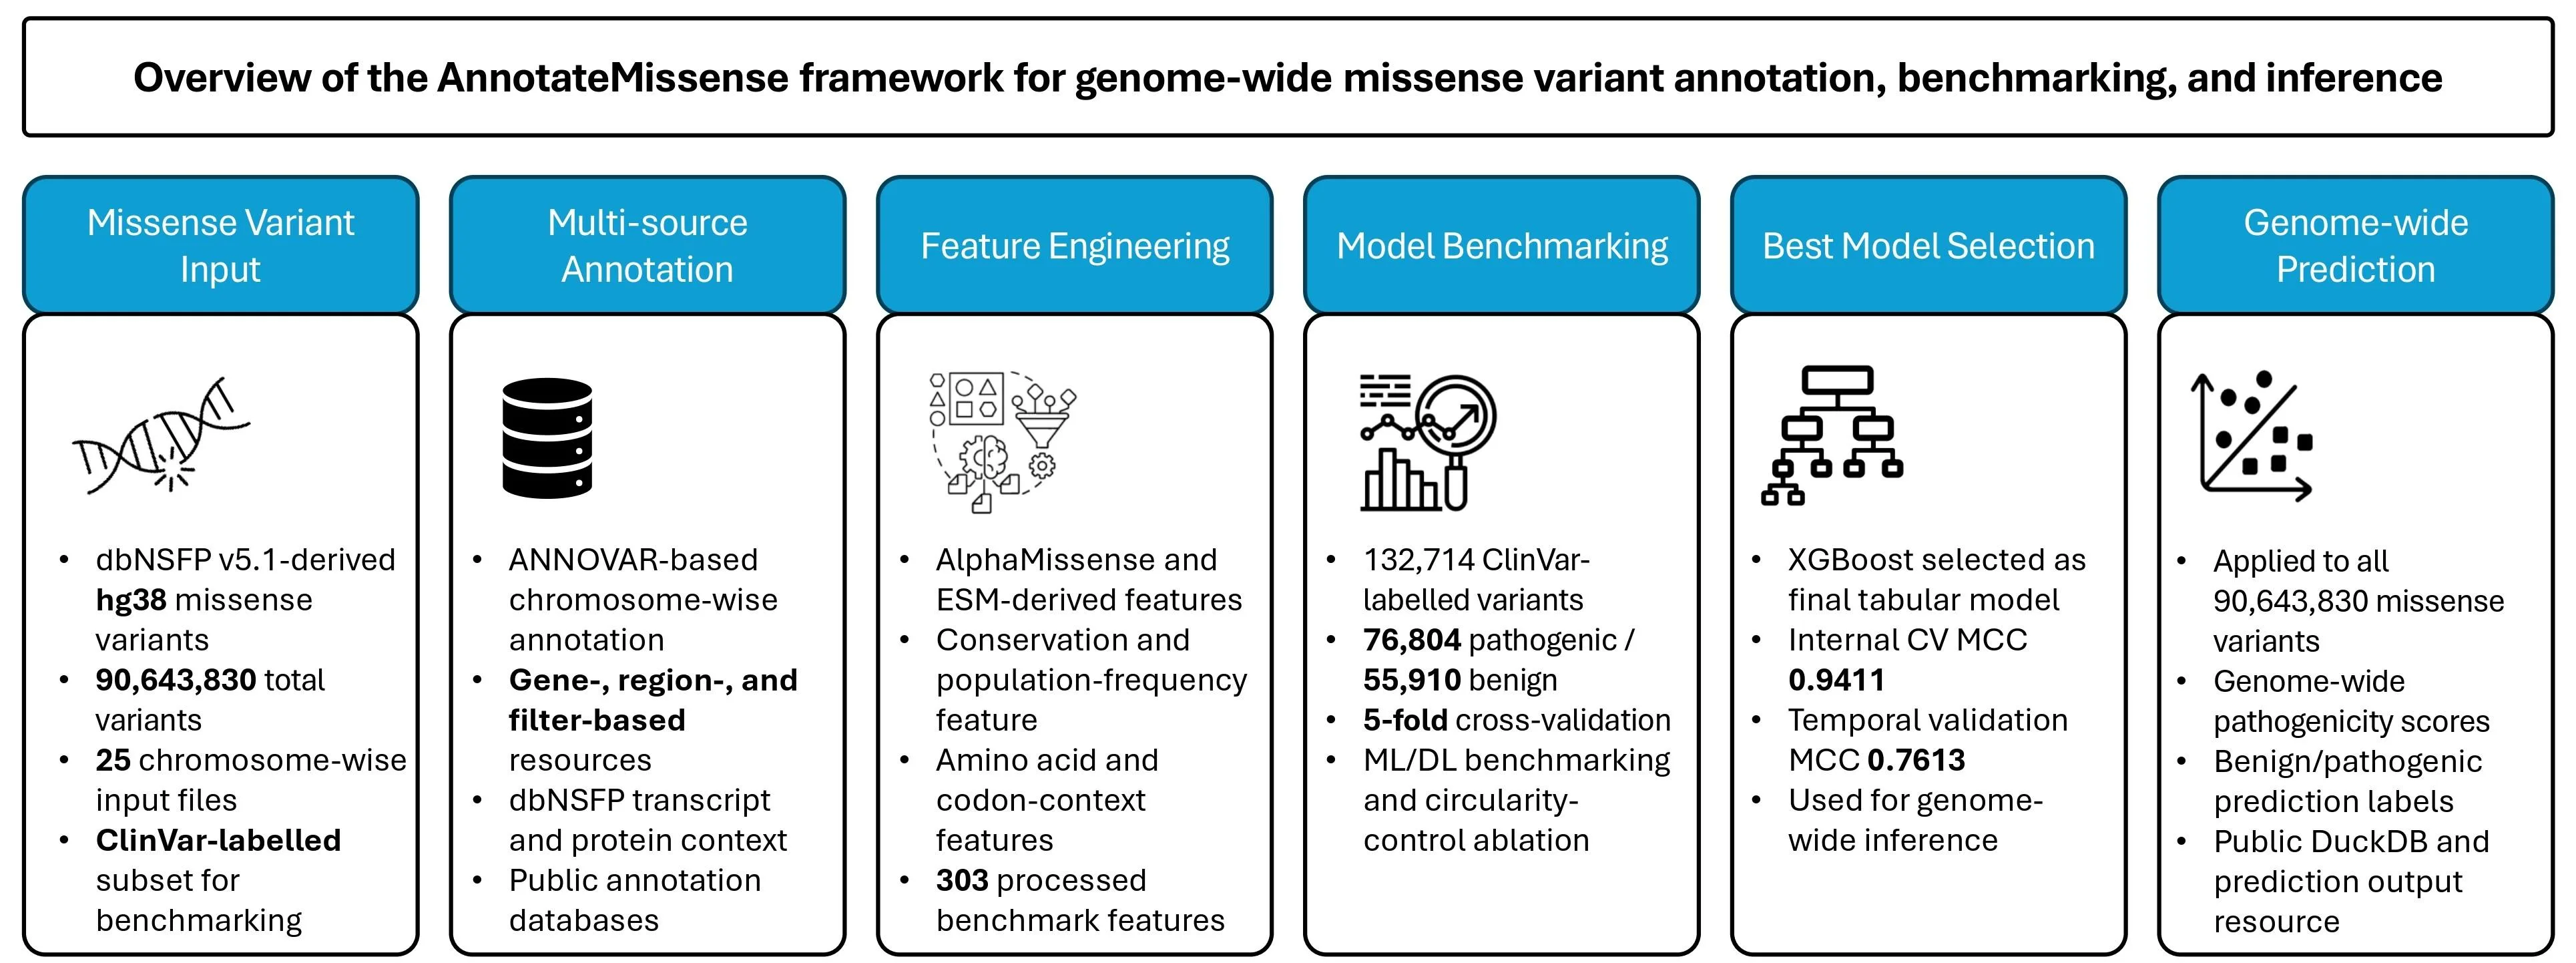
Le programme, baptisé AnnotateMissense, agit comme un correcteur méticuleux. Il ne se contente pas de regarder la lettre remplacée : il rassemble tous les indices possibles — la fréquence de cette substitution chez les personnes en bonne santé, l'ampleur du changement de forme de la protéine, ce que disent d'autres programmes de prédiction, et même ce que révèle l'« écriture » de l'évolution, c'est-à-dire si cette région est restée inchangée chez différentes espèces. Au total, 303 indices ont été réunis.
Le plus intéressant s'est produit lorsqu'on a retiré des indices au programme. Sans les données sur la fréquence de la mutation dans la population et sans les indications des autres prédicteurs, la précision chutait brutalement — comme si le correcteur avait perdu son dictionnaire et son manuel de grammaire. En revanche, supprimer les évaluations à la mode issues des modèles de langage protéiques n'a presque rien changé au résultat. La version finale a été testée sur des données fraîches, apparues après l'apprentissage : la précision est restée élevée — 88 %. Ensuite, le programme a scanné l'intégralité du génome humain et a attribué des scores de danger à 90 millions de mutations.
Résumé original
tel que rédigé par les auteurs, en anglais arXiv:2605.24520
Missense variant interpretation remains challenging because pathogenicity depends on heterogeneous evidence from population frequency, evolutionary conservation, transcript context, amino acid substitution severity, prior pathogenicity predictors and protein-language-model-derived features. We present AnnotateMissense, a scalable annotation, benchmarking and genome-wide prediction framework for missense variant interpretation. AnnotateMissense integrates hg38 missense variants derived from dbNSFP v5.1 with ANNOVAR annotations, dbNSFP transcript/protein descriptors, AlphaMissense scores, ESM-derived features, conservation metrics, population-frequency variables, established pathogenicity predictors and engineered amino acid/codon-context features. Using 132,714 ClinVar-labelled missense variants, we benchmarked machine-learning and deep-learning models under controlled feature configurations. The full 303-feature benchmark set achieved the strongest performance with XGBoost, reaching mean MCC = 0.9411 and ROC-AUC = 0.9950 across stratified five-fold cross-validation. Restricted naive and location-oriented feature sets achieved lower best MCC values of 0.4989 and 0.5113, respectively. Circularity-controlled ablations showed that removing prior-predictor, population-frequency and clinically overlapping evidence reduced performance, whereas excluding AlphaMissense and ESM-derived features alone had minimal effect. Temporal ClinVar validation on newly observed pathogenic/benign variants achieved MCC = 0.7613, accuracy = 0.8798 and F1-score = 0.8750. The final model was applied to 90,643,830 hg38 missense variants to generate AnnotateMissense pathogenicity scores and binary prediction labels. Code and outputs are available at https://github.com/MuhammadMuneeb007/CAGI7_Annotate_All_Missense and https://doi.org/10.5281/zenodo.19981867.
Le mot « missens » dans le nom signifie que la mutation ne change qu'un seul acide aminé dans la protéine — comme le remplacement d'une seule lettre dans un mot. Mais même ce petit changement peut transformer « maison » en « fumée ».
Dans le film « Bienvenue à Gattaca », la société était divisée entre « valides » et « non-valides » selon un pronostic génétique — des programmes comme celui-ci rapprochent un peu ce scénario de la réalité.