Comment un réseau de neurones apprend le climat à partir de données maigres ✛
Un élève qui a passé des années à résoudre des problèmes tirés de manuels d'autrui reçoit soudain trois cahiers contenant de véritables observations de l'océan. Les problèmes sont rares, mais il a déjà vu des centaines de cas similaires, et il lui suffit de quelques exemples pour saisir la manière de faire de son nouveau professeur. C'est ainsi qu'un modèle de diffusion (un réseau de neurones qui apprend à éliminer le bruit des données) s'approprie le climat du Pacifique, où la phase chaude d'El Niño alterne avec la phase froide de La Niña, influençant la météo de la planète.
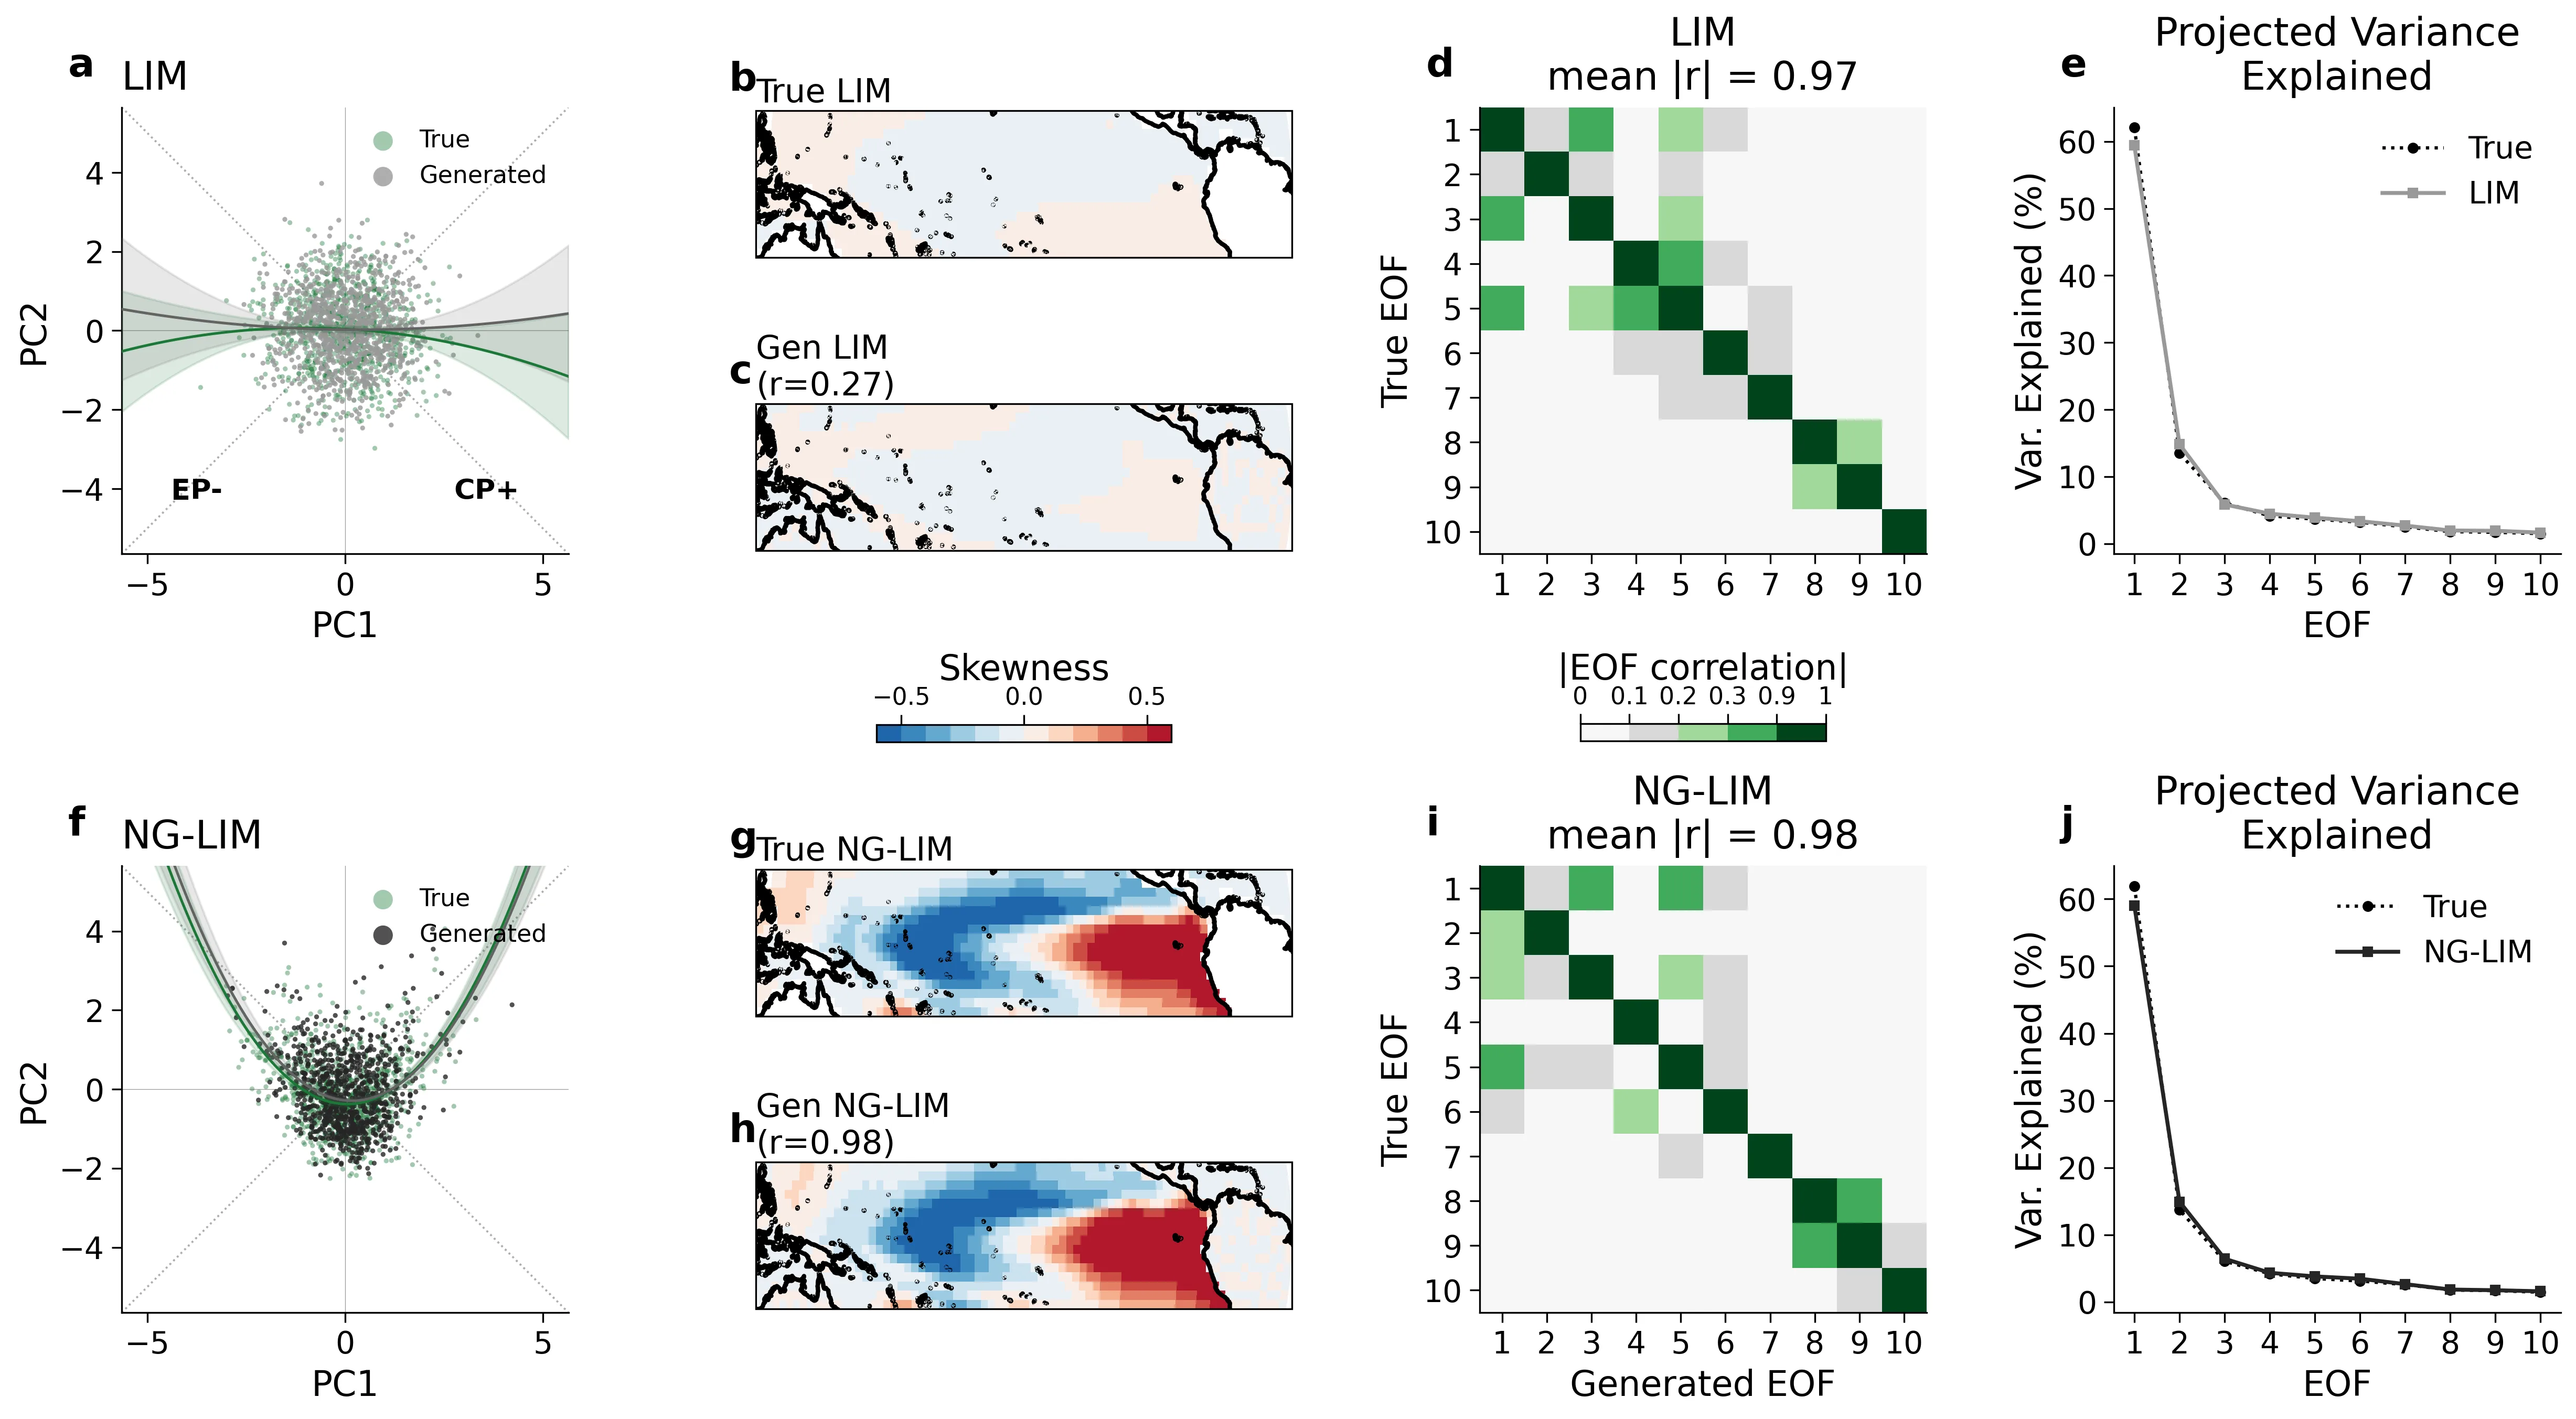
Le problème est que les mesures de température de surface de l'océan, par satellite ou par bouées, ne remontent qu'au milieu du XXe siècle. Depuis, on a accumulé environ 720 cartes mensuelles moyennes, alors que les réseaux de neurones à des millions de paramètres nécessitent généralement des milliers d'exemples. Pour vérifier honnêtement ce que le modèle a appris, les auteurs ont créé un banc d'essai : ils ont généré 120 000 champs synthétiques avec une structure connue. Sur ces données, le modèle a reproduit avec précision la variabilité symétrique et asymétrique, mais dès que l'échantillon a été réduit à la taille réelle, il a commencé à mémoriser les exemples d'entraînement au lieu de généraliser.
La solution est venue de la nature même de l'apprentissage. D'abord, le modèle a été pré-entraîné sur des champs synthétiques issus de 30 modèles climatiques du projet CMIP6, en ajoutant à l'architecture un vecteur à huit dimensions encodant l'identité de chaque modèle. Ensuite, sur les 720 observations réelles, seul ce vecteur a été affiné. Cette approche a permis d'atteindre une corrélation des motifs supérieure à 0.85 et une corrélation de l'asymétrie supérieure à 0.9, surpassant les modèles linéaires classiques. L'élève, entraîné sur une multitude de mondes virtuels, assimile en quelques exemples l'unique monde réel.
Cela change notre vision de la manière dont les modèles génératifs peuvent fonctionner dans les sciences de la Terre : non pas comme substituts des modèles physiques, mais comme outils pour extraire une structure d'échantillons empiriques maigres. La méthode peut être appliquée pour générer des ensembles réalistes d'états d'El Niño lors de l'évaluation des risques climatiques, ainsi que pour améliorer les modèles statistiques de prévision en situation de pénurie de données. L'élève qui a commencé avec les manuels des autres écrit désormais lui-même de nouvelles pages.
Les modèles de diffusion, qui génèrent aujourd'hui des visages et des paysages réalistes, ont été initialement inspirés par la thermodynamique hors équilibre, la science qui étudie comment les systèmes passent de l'ordre au chaos. Dans ces travaux, le même principe est inversé pour restaurer des structures climatiques ordonnées à partir du bruit.
L'idée d'entraîner une machine sur une multitude de mondes virtuels, puis de l'ajuster sur un seul monde réel, fait écho à la nouvelle de Ted Chiang « L'histoire de ta vie », où une linguiste apprend la langue des extraterrestres en s'appuyant sur une multitude de grammaires hypothétiques pour comprendre une seule grammaire réelle.