Les modèles de diffusion apprennent le climat à partir de données rares ✛
Contexte
El Niño et La Niña gouvernent le temps sur une grande partie de la planète, mais les mesures détaillées par satellite et par bouées de la température de surface de l'océan ne sont disponibles que depuis le milieu du XXe siècle. Pendant cette période, environ sept cents cartes mensuelles moyennes ont été accumulées, alors que les réseaux de neurones à des millions de paramètres ont généralement besoin de milliers d'exemples pour éviter le sur-apprentissage. Les données synthétiques, générées par des modèles inverses linéaires, fournissent une structure de faible dimension connue sur laquelle on peut honnêtement vérifier ce qu'un modèle de diffusion a réellement appris. Ce terrain d'essai contrôlé permet de distinguer une véritable compréhension de la variabilité climatique d'une simple mémorisation de l'échantillon d'entraînement.
Méthodes
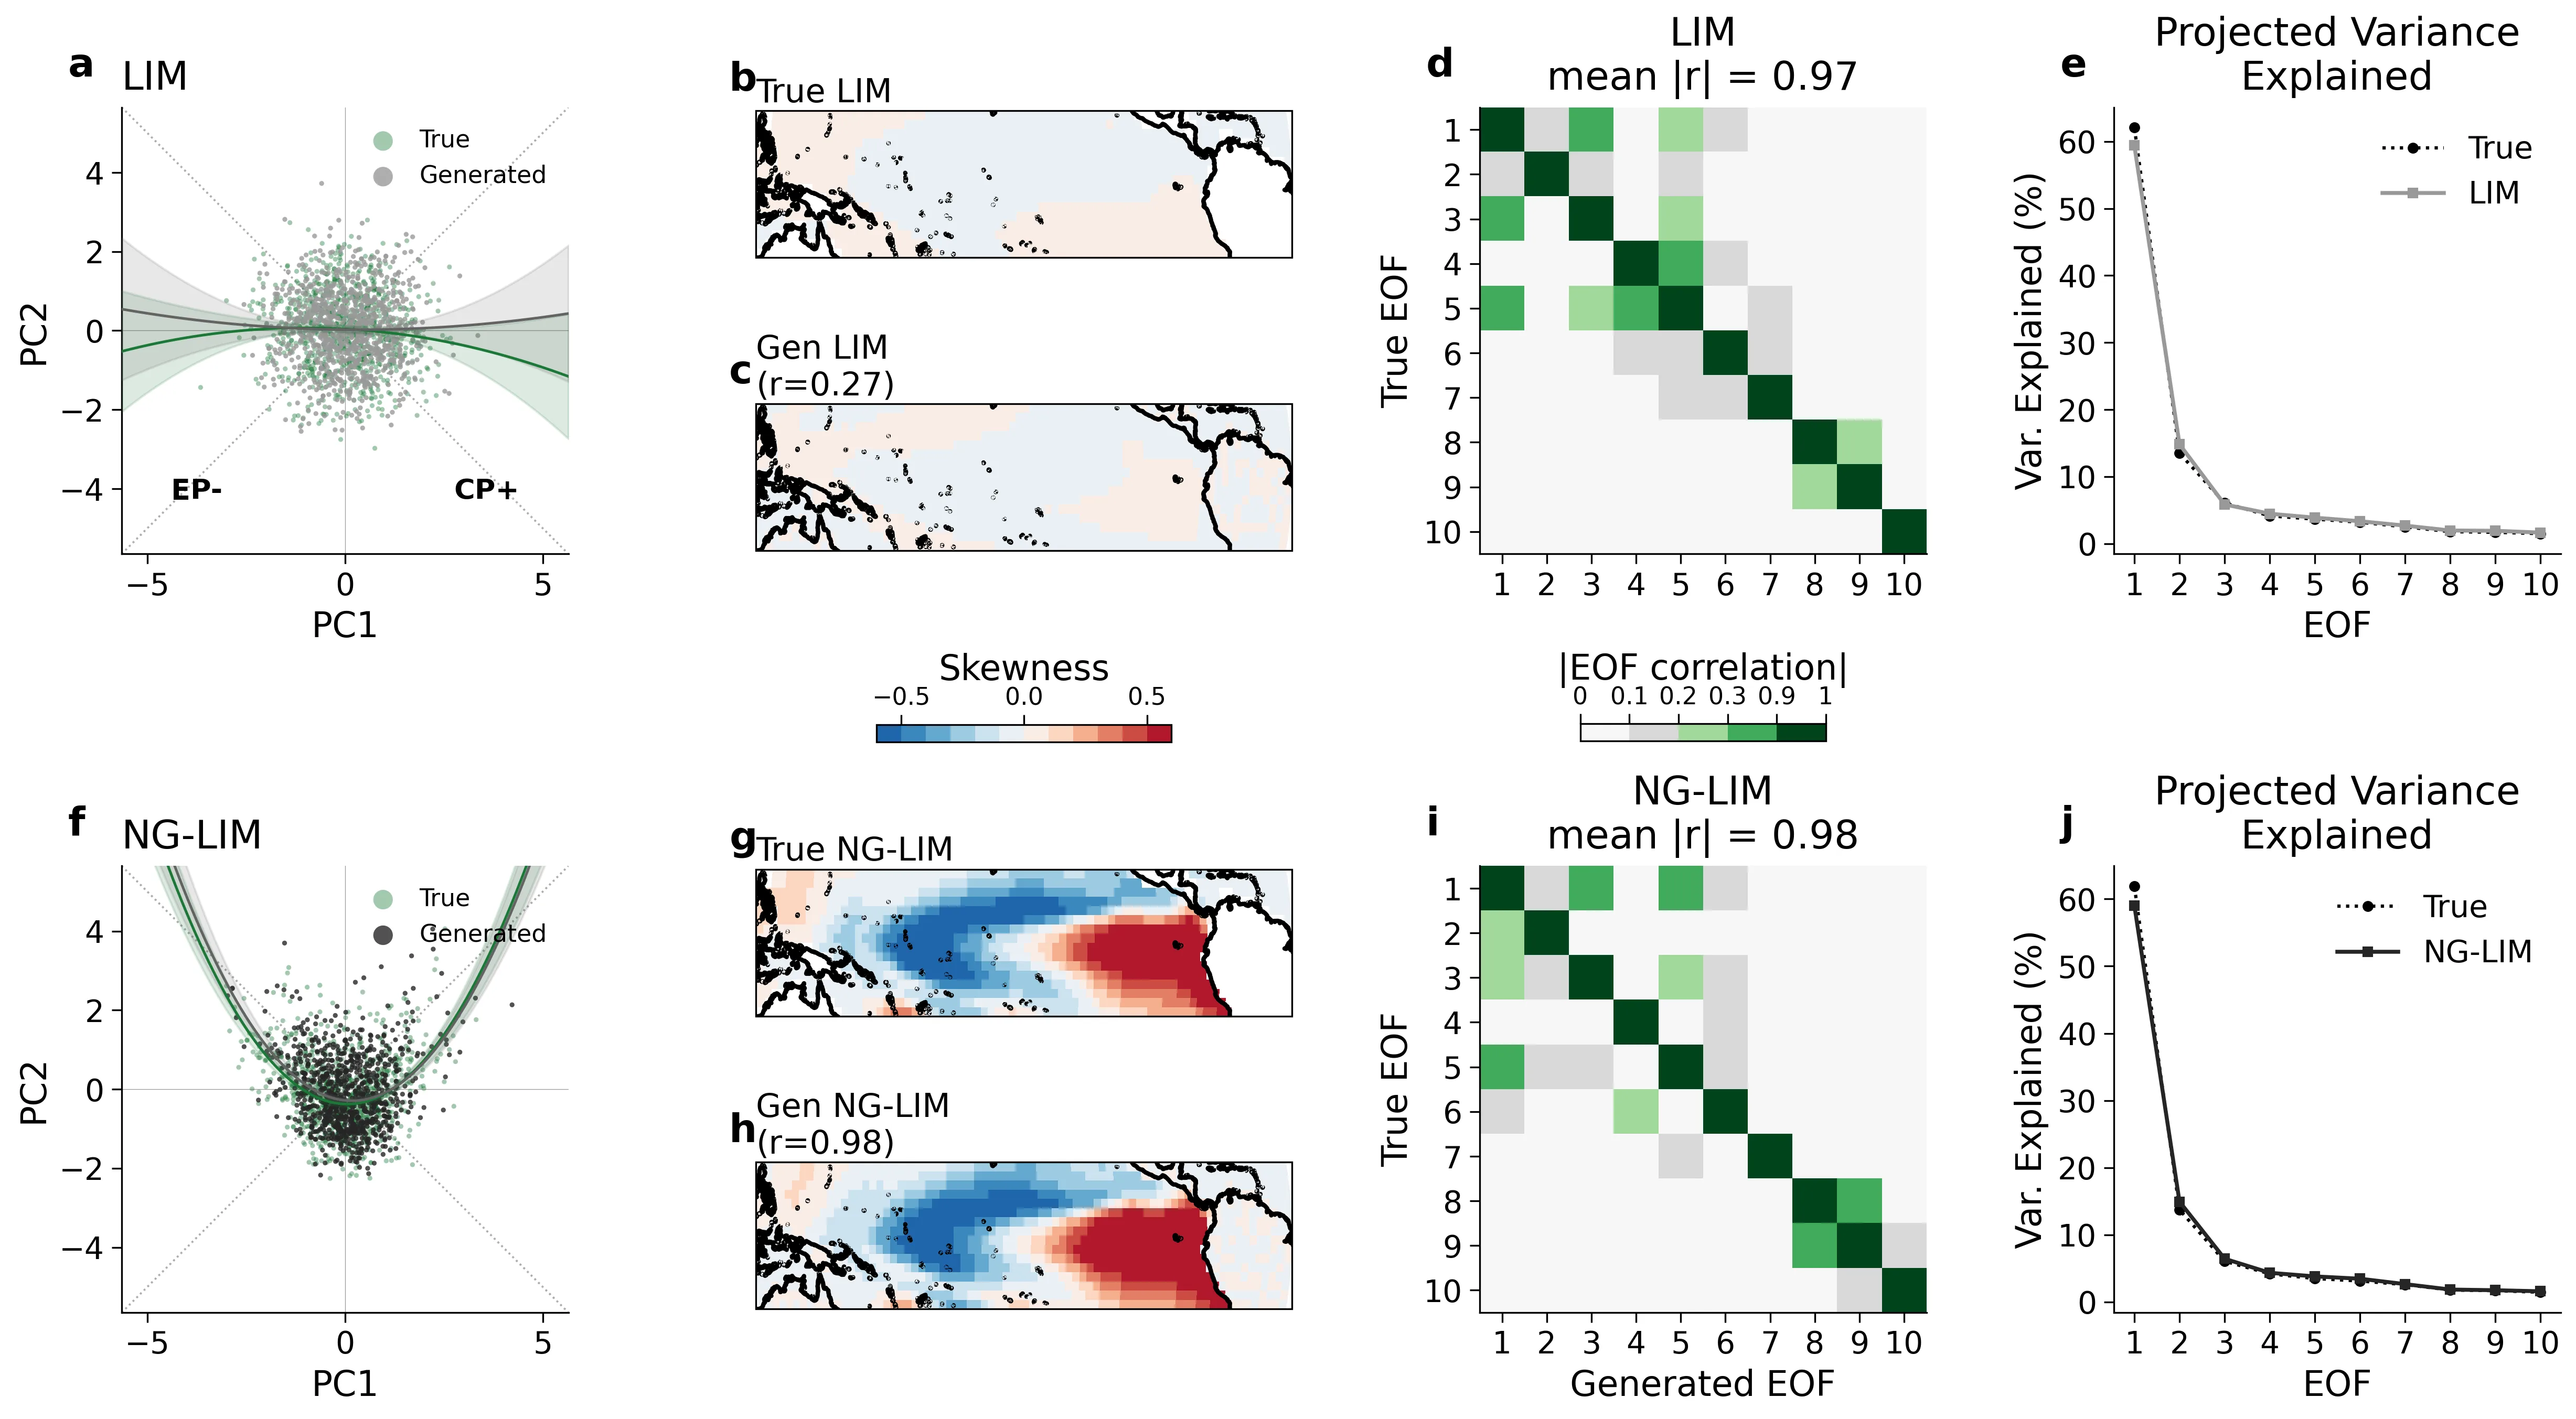
Les auteurs ont généré 120 000 champs mensuels de température de surface du Pacifique tropical à l'aide de modèles inverses linéaires calibrés sur les données de réanalyse ERSSTv5 de 1948 à 2022. Deux variantes ont été utilisées : un LIM gaussien standard et un NG-LIM non linéaire avec une transformation de Yeo-Johnson, qui rend mieux compte de l'asymétrie entre les phases chaudes et froides. Le modèle de diffusion a été entraîné à prédire le champ de données propre à partir d'une version bruitée, ce qui, selon l'hypothèse, force le réseau à se concentrer sur la structure de faible dimension. Pour faire face au manque de données, le modèle a été pré-entraîné sur des champs synthétiques provenant de 30 modèles climatiques du projet CMIP6, en ajoutant à l'architecture un vecteur d'intégration à huit dimensions codant l'identité de chaque modèle, puis seul ce vecteur a été ajusté sur les 720 observations réelles.
Résultats
Lors de l'entraînement sur l'ensemble synthétique complet, le modèle de diffusion reproduit avec précision la structure gaussienne et non gaussienne : la corrélation entre les motifs spatiaux des dix premières fonctions orthogonales empiriques dépasse 0.9, et les cartes d'asymétrie conservent la forme caractéristique en fer à cheval avec une asymétrie positive à l'est et négative à l'ouest. Cependant, l'ablation sur le nombre d'échantillons d'entraînement a montré que toutes les métriques ne convergent qu'à partir de 7000 échantillons, alors que dans ERSSTv5, il n'y en a qu'environ 720. Avec un tel déficit, le modèle commence à mémoriser les exemples d'entraînement : la distance médiane au plus proche voisin tombe en dessous de 0.6 de la valeur de référence. Parmi les trois variantes de paramétrage de la diffusion, seule la prédiction des données propres résiste à tous les diagnostics, tandis que la prédiction du bruit échoue complètement et que la prédiction de la vélocité surestime la dimension effective jusqu'à 19.6% de variance expliquée. La stratégie de pré-entraînement sur CMIP6 et d'ajustement du seul vecteur d'intégration atteint une corrélation des motifs supérieure à 0.85, une corrélation de l'asymétrie supérieure à 0.9 et un coefficient de mémorisation d'environ 0.95, surpassant à ces égards à la fois le LIM standard et le NG-LIM.
Implications
Ce travail montre que les modèles de diffusion sont capables d'extraire une structure de faible dimension physiquement significative de la variabilité climatique, si les données sont suffisantes et si la paramétrisation est bien choisie. Mais la conclusion principale est que les seules observations ne suffisent pas : il faut un ordre de grandeur de données dix fois supérieur à ce dont disposent les climatologues. Le schéma proposé avec le vecteur d'intégration du modèle transforme la diversité des simulations climatiques d'une source de biais en une ressource permettant de compenser le déficit de données réelles. Cela change la façon de concevoir l'utilisation des modèles génératifs dans les sciences de la Terre : non pas comme un remplacement des modèles physiques, mais comme un outil pour extraire la structure d'échantillons empiriques rares.
Développements futurs
La suite naturelle est le passage de la génération inconditionnelle, qui ne reproduit que la distribution des états, à la génération conditionnelle, où le modèle génère le champ futur à partir d'un état initial donné. Cela ouvrirait la voie à l'émulation de la dynamique d'El Niño et peut-être à la prévision. Des prédicteurs plus riches seront nécessaires : non seulement la température de surface, mais aussi la chaleur stockée dans la couche sous-superficielle de l'océan et les contraintes de vent. L'inclusion dans le pré-entraînement d'ensembles à plus haute résolution, tels que les nouvelles simulations avec résolution explicite de la convection, pourrait encore améliorer la précision de la reproduction des queues de distribution.
Impact
Les résultats sont importants pour la modélisation climatique, la prévision saisonnière et l'évaluation des risques d'événements extrêmes associés à El Niño. La méthode peut être transposée à d'autres modes de variabilité, par exemple l'oscillation nord-atlantique ou l'oscillation décennale du Pacifique, où les données sont encore plus rares.
Prochaines étapes
La prochaine étape est la construction d'un modèle de diffusion conditionnel qui, à partir de l'état actuel du Pacifique tropical, génère un ensemble d'états futurs possibles. Ensuite, il faudra comparer sa précision prédictive avec les modèles statistiques et dynamiques classiques sur des données historiques.
Problèmes ouverts clés
Ce travail aborde directement le problème fondamental de la climatologie : comment distinguer les modes réels de variabilité des artefacts de courtes séries d'observations. Il contribue également au débat sur les architectures d'apprentissage automatique capables de saisir une structure de faible dimension physiquement significative, par opposition à celles qui ne font qu'interpoler les données. Enfin, la méthode proposée d'ajustement fin du vecteur d'intégration pourrait devenir une recette générale pour le transfert de connaissances entre des simulations climatiques hétérogènes et des observations.
Le regard de la machine du savoir
Cette section s'adresse à l'auteur du travail et à ses collègues. Les travaux voisins ont été trouvés par une recherche sémantique dans notre archive, et non par correspondance de mots. Nous n'évaluons pas : nous montrons le champ autour.
Ce que fait ce travail
Les auteurs ont vérifié si les modèles de diffusion peuvent apprendre la structure de faible dimension de la variabilité climatique d'El Niño, en utilisant des données synthétiques dont la structure est connue. Il s'avère qu'avec un échantillon suffisant, les modèles reproduisent fidèlement la structure gaussienne et non gaussienne, mais sur des données réelles (environ 720 mois), ils commencent à mémoriser les exemples. La solution réside dans le pré-entraînement sur un ensemble de simulations climatiques CMIP6, suivi d'un ajustement fin d'un petit vecteur d'intégration, ce qui permet d'extraire plus d'informations des observations limitées que les modèles linéaires classiques.
Où est sa force
La force de ce travail réside dans le banc d'essai contrôlé sur des données synthétiques, où la véritable structure de faible dimension est connue, ce qui permet de distinguer clairement la généralisation de la mémorisation. Cela fournit une base solide pour vérifier ce que le modèle de diffusion a réellement appris et ouvre la voie à une application sur des données réelles.
Vers où avancer
- Il pourrait être intéressant d'examiner comment l'approche de pré-entraînement sur CMIP6 et d'ajustement de l'intégration se transpose à d'autres variables climatiques, comme les précipitations ou la pression, où la structure de la variabilité est moins prononcée. Dans nos archives, un travail voisin où un réseau de neurones assemble le temps global pièce par pièce pourrait inspirer des idées pour traiter des champs spatialement hétérogènes.appui : Mosaïque orageuse : le modèle d'IA STRATA assemble la météo mondiale pièce par pièce arXiv:2606.31248
- On pourrait envisager une application à la prévision d'El Niño : un modèle de diffusion entraîné sur des données synthétiques pourrait générer des ensembles de prévisions. Nos archives contiennent une analyse sur la prévision d'El Niño à un an et demi, qui pourrait fournir des points de repère pour la comparaison.appui : El Niño se laisse prédire dix-huit mois à l'avance arXiv:2601.12251
- Il serait intéressant d'étudier comment les modèles de diffusion apprennent les invariants algébriques dans les données climatiques, à l'instar d'un réseau de neurones qui apprend sur un squelette algébrique dans un diagramme tropical. Cela pourrait offrir une nouvelle façon de vérifier la pertinence physique des représentations apprises.appui : Le plan tropical : un réseau de neurones apprend sur un squelette algébrique arXiv:2607.00237
À essayer
- Tester le remplacement des données synthétiques par des observations réelles provenant d'autres régions avec des séries plus longues pour le pré-entraînement.
- Vérifier si l'ajout de contraintes physiques (par exemple, la conservation de l'énergie) améliore la qualité de la génération sur de petits échantillons.
- Utiliser le modèle de diffusion pour créer des analogues synthétiques d'El Niño et évaluer leur impact sur l'apprentissage des modèles de prévision.
Pourquoi cela peut compter
Si les modèles de diffusion parviennent à extraire de manière fiable la variabilité climatique à partir de courtes séries d'observations, cela ouvrirait la voie à des estimations plus précises des événements rares et améliorerait notre compréhension de la dynamique à long terme du système, ce qui est crucial pour l'adaptation au changement climatique.
Travaux voisins dans notre archive
- El Niño se laisse prédire dix-huit mois à l'avanceproximité 0.54
- Prévisions météo sur une seule carte graphiqueproximité 0.54
- Le plan tropical : un réseau de neurones apprend sur un squelette algébriqueproximité 0.50
- Mosaïque orageuse : le modèle d'IA STRATA assemble la météo mondiale pièce par pièceproximité 0.50
- Un réseau de neurones dresse une carte gravitationnelle précise des galaxiesproximité 0.50
- La météo martienne à la mode terrestreproximité 0.49
L'archive est vide autour de ce travail : l'analyse la plus proche n'est qu'à 0.54, contre 0,64 d'ordinaire. Il semble qu'on ait peu foré à côté.
Les modèles de diffusion, qui génèrent aujourd'hui des visages et des paysages réalistes, ont été initialement inspirés par la thermodynamique hors équilibre, la science qui étudie comment les systèmes passent de l'ordre au chaos. Dans ce travail, le même principe est inversé pour restaurer des structures ordonnées du climat à partir du bruit.
L'idée d'entraîner une machine sur une multitude de mondes virtuels, puis de l'ajuster sur un seul monde réel, fait écho à la nouvelle de Ted Chiang « L'histoire de ta vie », où une linguiste apprend la langue des extraterrestres en s'appuyant sur une multitude de grammaires hypothétiques pour comprendre une seule grammaire réelle.
Chiffres clés
- 120 000: champs mensuels synthétiques utilisés pour l'entraînement
- 720: observations mensuelles dans ERSSTv5 de 1948 à 2022
- 7000: échantillons nécessaires pour la convergence de toutes les métriques
- 10: composantes principales expliquent 90% de la variabilité
- 0.95: corrélation du motif d'asymétrie pour le meilleur modèle