Le surapprentissage se produit lorsqu'un modèle statistique décrit l'erreur aléatoire ou le bruit plutôt que la relation sous-jacente. Le modèle fonctionne bien sur les données d'entraînement mais mal sur de nouvelles données inédites. C'est un problème central en apprentissage automatique et en statistiques, car l'objectif est de construire des modèles qui généralisent, et non qui mémorisent simplement.
Histoire
Le concept est connu depuis les débuts de la statistique et de l'ajustement de courbes. Le terme « surapprentissage » est devenu important dans les années 1960-1970 avec l'essor des réseaux de neurones et des arbres de décision.
Comment ça marche
Les modèles très flexibles (par exemple, avec de nombreux paramètres) peuvent ajuster presque parfaitement les données d'entraînement, y compris leurs particularités. Lorsque le modèle est trop complexe par rapport à la quantité de données, il capture des motifs fallacieux qui n'existent pas dans la population réelle. Cela conduit à une variance élevée : de petites modifications de l'ensemble d'entraînement entraînent de grandes modifications du modèle. Des techniques comme la validation croisée, la régularisation et l'élagage sont utilisées pour détecter et prévenir le surapprentissage.
En pratique
En modélisation prédictive, le surapprentissage est une préoccupation constante. Les praticiens utilisent des ensembles de validation et la régularisation pour garantir que les modèles, comme ceux utilisés pour la notation de crédit ou le pronostic médical, restent fiables sur de nouveaux patients.
Anecdote
Un modèle qui mémorise parfaitement les données d'entraînement (par exemple, une table de correspondance) a une erreur d'entraînement nulle, mais en général, il ne fait pas mieux qu'une supposition aléatoire sur de nouvelles données — un exemple classique de surapprentissage.
Une carte au trésor dessinée par un réseau de neurones promet de montrer où l'or est enterré. Mais si l'on transporte la carte sur une autre île, les marques peuvent pointer vers le vide. C'est exactement ce qui arrive avec les explications d'un modèle qui estime le pouls à partir d'une vidéo du visage.
Imaginez que vous essayez de comprendre ce qui s'est passé dans une pièce à partir du son qui subsiste après un coup de feu. Le coup de feu n'est plus là, mais l'écho résonne encore contre les murs.
Deux coureurs s'élancent sur une piste dont la pente varie. L'un part plus tôt, l'autre plus tard, et l'arbitre mesure leurs vitesses sans connaître la différence de départ. C'est la même chose avec les variants du virus : les données arrivent avec des retards, et si ces retards ne sont pas identiques, l'estimation de l'avantage compétitif peut être grossièrement erronée.
Dans un entrepôt, des cartons de pommes et de poires. Les pommes sont nombreuses, les poires rares. Mais quand le magasinier dit « un fruit à la peau lisse », nous pensons plus souvent à la poire rare qu'à la pomme fréquente. C'est l'effet de taux de base inversé : un dérèglement persistant dans la façon dont le cerveau résout l'ambiguïté entre les catégories.
Cent mille étoiles dans le noyau dense d’un amas globulaire se déplacent comme des billes d’acier dans un flipper géant. Chaque « choc » — une rencontre gravitationnelle entre un couple binaire et une étoile isolée — déclenche une cascade d’événements imprévisibles.
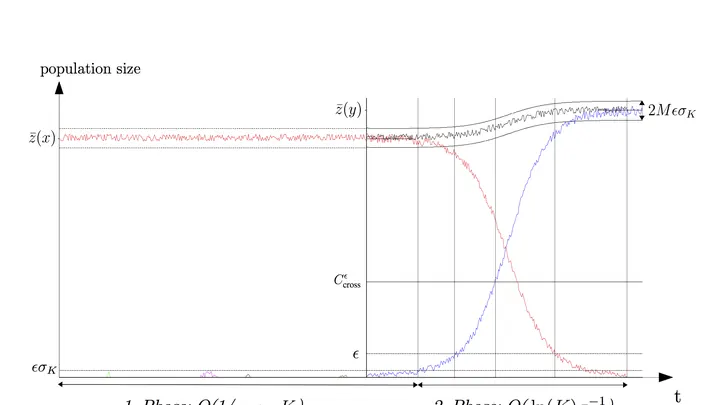
L'évolution coule comme l'eau. Dans une large rivière, les changements sont lents et progressifs, tandis qu'un torrent de montagne bouillonne à chaque pierre. La taille de la population et la fréquence des mutations tracent le lit : large et calme, ou étroit et plein de rapides.
L'apprentissage automatique n'est plus depuis longtemps un simple outil — il devient un chercheur qui extrait lui-même les lois de la nature à partir des données. Mais comment un esprit de silicium parvient-il à la compréhension ?
60 souris, 1980 échantillons, 234 patients atteints d'un cancer du poumon. Derrière chaque chiffre se cachent des milliers de gènes. Leur activité est mesurée pour comprendre la maladie.
Les modèles statistiques sont une tentative de tendre une toile mathématique idéale sur le paysage accidenté des données. Lorsque le modèle résiste, il émet une tension, mais nous avons pris l'habitude de l'ignorer. Les chercheurs passent des heures à scruter les graphiques de résidus, essayant de deviner où le modèle « craque ». Squealer traduit cette résistance en son.
Un élève qui a passé des années à résoudre des problèmes tirés de manuels d'autrui reçoit soudain trois cahiers contenant de véritables observations de l'océan. Les problèmes sont rares, mais il a déjà vu des centaines de cas similaires, et il lui suffit de quelques exemples pour saisir la manière de faire de son nouveau professeur.
Dans un stade de football, l'émotion de la foule est la somme des conversations des supporters individuels. Si l'humeur pouvait être à la fois joyeuse et triste, on aurait une superposition quantique. Mais le murmure de milliers de voix fait basculer instantanément ce mélange dans un état bien défini.
Former un modèle aérodynamique précis, c'est un peu comme la cuisine : d'abord, le chef apprend des centaines de recettes pour saisir les principes généraux, puis il perfectionne facilement un plat particulier.
Le noyau d'uranium ressemble à un portefeuille bien rempli, fermé par deux moitiés qui s'emboîtent. Pour qu'il éclate et libère de l'énergie — c'est-à-dire pour que le noyau se divise — il faut franchir une barrière d'énergie. La hauteur de ce seuil détermine si la matière est stable ou prête à se désintégrer à tout moment.
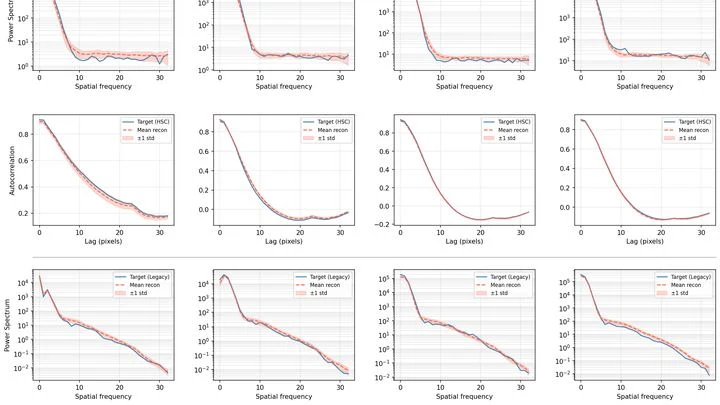
Si l'on photographie la même montagne avec un appareil argentique et un smartphone moderne, on obtient des images différentes : ici les couleurs sont plus vives, là les détails sont flous.
Un ordinateur quantique ressemble à un orchestre où chaque musicien joue sa partition. Si le chef d'orchestre fait une fausse note, la musique s'effondre. Dans les simulations quantiques numériques, le rôle du chef d'orchestre est joué par une séquence d'opérations simples, et les erreurs s'accumulent comme des fausses notes.
Un écoulement turbulent dans un tuyau et les oscillations d'un pendule semblent très différents. Mais ils ont un point commun : tous deux obéissent à leurs propres lois du mouvement, qui peuvent être décrites par des nombres.
On peut comparer un réseau de neurones à une résidence où chaque locataire dispose de sa propre chambre. En général, chaque signal dans les données occupe un neurone distinct, et l'apprentissage se fait séquentiellement : d'abord un signal, puis un autre. C'est lent et cela dépend des données rencontrées.