Плотные связи против остаточных: как DenseNet-121 обходит ResNet-50 в распознавании рака мозга ✛
Контекст
Ручная интерпретация снимков биопсии мозга трудоёмка и страдает от разногласий между специалистами: один и тот же срез разные врачи могут оценить по-разному. Вокруг этой проблемы уже выстроился целый пласт работ: соседние исследования в нашем архиве используют нейросети для сегментации опухолей, синтеза изображений и оценки уверенности модели. Данная статья стоит в том же русле автоматизации анализа медицинских изображений, но фокусируется на прямом сравнении двух популярных архитектур свёрточных сетей для классификации снимков мозговой ткани. Это не новая задача, но систематическое сопоставление на одном наборе данных с тщательным контролем переобучения заполняет пробел в доказательной базе выбора архитектуры.
Методы
Использовали коммерческий тканевой микрочип (TMA) с 24 круглыми образцами мозговой ткани толщиной 5 микрон, отсканированный на микроскопе Olympus BX61 с 40-кратным объективом в режиме автоматического сканирования (около 100 точек за 6 минут). Из 2931 изображения выделили 1996 для обучения, 437 для валидации и 498 для теста, разделяя по пациентам, чтобы избежать утечки данных. Каждое изображение привели к размеру 256×256 пикселей и нормализовали по среднему и дисперсии обучающей выборки. Взяли две предобученные на ImageNet сети — ResNet-50 и DenseNet-121, заменили последний слой на классификатор с двумя выходами. Дообучали в два этапа: сначала 10 эпох только новый классификатор при замороженных свёрточных слоях, затем ещё 20 эпох с размороженными двумя последними блоками и меньшей скоростью обучения. Применяли случайные повороты, отражения, сдвиги и изменения яркости, а также раннюю остановку при отсутствии улучшения валидационной ошибки в течение 5 эпох.
Результаты
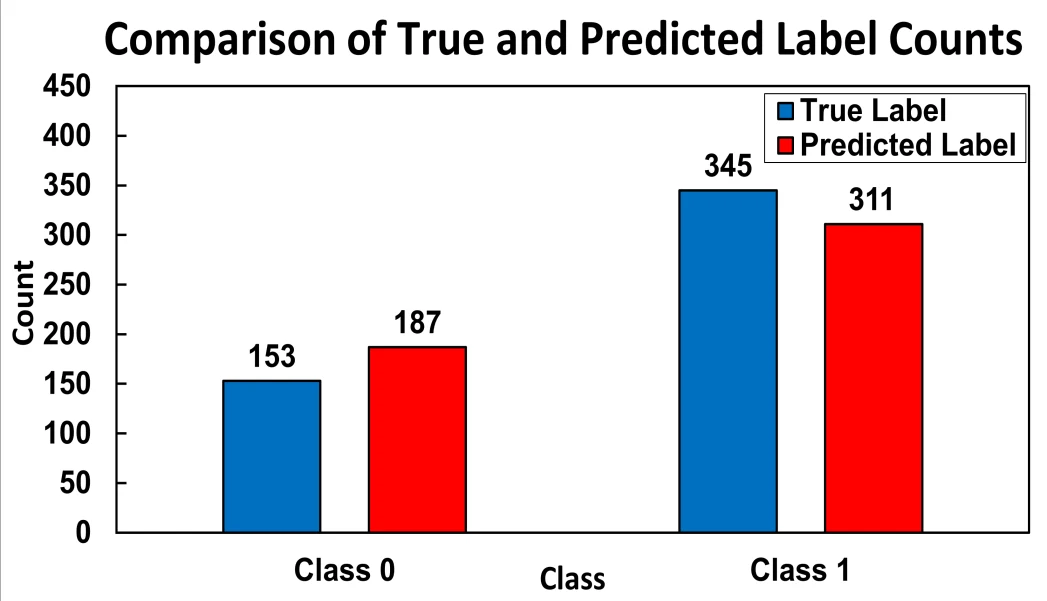
На отложенном тестовом наборе из 498 срезов DenseNet-121 показал точность 88,35% (95% доверительный интервал ±1,28%), точность класса «рак» 0,9614, полноту 0,8667 и F1-меру 0,9116. ResNet-50 достиг 82,12% (±1,75%), точности 0,9035, полноты 0,8142 и F1-меры 0,8563. Разница в точности 6,23 процентных пункта статистически значима (p=0,004 по тесту МакНемара). Матрица ошибок DenseNet-121 показывает 299 истинно положительных, 141 истинно отрицательный, 46 ложноотрицательных и лишь 12 ложноположительных случаев — низкая доля ложных тревог (7,9%) критична для клиники. Сеть слегка переоценивает класс «нет рака» (187 против 153) и недооценивает «рак» (311 против 345), что можно скорректировать взвешиванием классов.
Значение
Работа демонстрирует, что плотные связи между слоями (как в DenseNet) эффективнее остаточных обходных путей (как в ResNet) для переноса знаний на небольшие медицинские наборы данных. По сравнению с соседними исследованиями, которые часто используют одну архитектуру или решают задачу сегментации, здесь проведено прямое сравнение двух сетей с одинаковым протоколом обучения и статистической проверкой значимости. Это даёт практическую рекомендацию: для классификации снимков тканей при ограниченном числе примеров стоит предпочесть DenseNet-подобные архитектуры. Методика двухэтапного дообучения с агрессивной аугментацией воспроизводима и может служить шаблоном для других задач бинарной классификации в патологии.
Развитие
Естественное расширение — переход от бинарной классификации к многоклассовой градации опухолей (низкая, промежуточная, высокая степень злокачественности) с использованием порядковых функций потерь. Другое направление — объединение нескольких модальностей изображений (например, разных окрасок или фазово-контрастной микроскопии) для более полной характеристики ткани. Для повышения доверия врачей необходимы методы объяснимости, такие как карты значимости Grad-CAM, показывающие, на какие участки снимка опирается сеть. Наконец, федеративное обучение позволит обучать модели на данных из разных клиник без их централизации, улучшая обобщаемость.
Влияние
Результаты могут ускорить внедрение автоматического скрининга биопсий мозга в клиническую практику, снизив нагрузку на патоморфологов и повысив воспроизводимость диагнозов. Методология применима к другим типам тканей и задачам классификации в цифровой патологии.
Следующие шаги
Проверить предложенный протокол на независимых наборах данных из разных клиник для подтверждения обобщаемости. Реализовать многоклассовую классификацию и интегрировать карты объяснимости в рабочий процесс патолога.
Ключевые проблемы
Для медицинской визуализации остаётся нерешённой проблема нехватки размеченных данных: аннотирование снимков требует дорогостоящего труда экспертов. Данная работа показывает, что грамотный перенос предобученных моделей с агрессивной аугментацией частично компенсирует этот дефицит, но не снимает вопрос о систематических смещениях в обучающих выборках. Связь с фундаментальной проблемой интерпретируемости моделей также остаётся открытой: высокая точность не гарантирует, что сеть опирается на клинически значимые признаки, а не на артефакты окраски или съёмки.
Взгляд машины знаний
Этот раздел адресован автору работы и его коллегам. Соседние работы нашёл смысловой поиск по нашему архиву — не по совпадению слов, а по смыслу. Мы не рецензируем: мы показываем поле вокруг.
Что сделано в работе
В работе проведено прямое сравнение ResNet-50 и DenseNet-121 для бинарной классификации срезов мозговой ткани на наборе из 2931 изображения. Использовано двухэтапное дообучение с заморозкой и разморозкой блоков, агрессивная аугментация и ранняя остановка. DenseNet-121 показал точность 88,35% и F1 0,9116, значимо превзойдя ResNet-50.
В чём сила
Систематическое сопоставление двух популярных архитектур на одном наборе с тщательным контролем переобучения даёт конкретные цифры для выбора архитектуры. Низкая доля ложноположительных результатов (7,9%) у DenseNet-121 подчёркивает её практическую пригодность.
Куда можно двигаться
- Рядом лежит работа об оценке уверенности нейросети на снимках опухоли мозга — возможно, будет интересно посмотреть, как добавить калибровку предсказаний к выбранной архитектуре, чтобы отсеивать случаи, где модель сомневается.опора: Опухоль мозга на снимках: где заканчивается уверенность arXiv:2601.17504
- В архиве есть исследование о прореживании сетей без потери точности — может быть полезно применить эти методы к DenseNet-121, чтобы уменьшить вычислительную нагрузку для потенциального клинического использования.опора: Как проредить сеть, не порвав её arXiv:2603.14564
- Ещё одна соседняя работа посвящена улучшению медицинских снимков через физическую модель — интересно проверить, поможет ли предобработка изображений таким способом повысить качество классификации на вашем наборе.опора: Геометрия воды в медицинской визуализации: как плавность контуров улучшает диагностику arXiv:2607.12586
Что можно попробовать
- Попробовать калибровку вероятностей (например, temperature scaling) на выходе DenseNet-121 и оценить, как меняется доля уверенных ошибок.
- Применить прунинг к обученной DenseNet-121 и сравнить точность и скорость инференса с исходной сетью.
- Прогнать изображения через модель улучшения на основе физики воды и проверить, растёт ли точность на тестовом наборе.
Почему это может быть важно
Если удастся совместить точность DenseNet-121 с калиброванной уверенностью и сниженными вычислительными требованиями, это приблизит автоматическую классификацию срезов мозга к реальной клинической практике, где важны и надёжность, и скорость.
Работы рядом в нашем архиве
- Нейросеть на слух: как измерить энергию частицы в шуме коллайдераблизость 0.53
- Два глаза лучше одного: как нейросеть учится видеть опухольблизость 0.53
- Как графы находят меланому на кожеблизость 0.53
- Опухоль мозга на снимках: где заканчивается уверенностьблизость 0.53
- Геометрия воды в медицинской визуализации: как плавность контуров улучшает диагностикублизость 0.51
- Как проредить сеть, не порвав еёблизость 0.51
Вокруг этой работы в архиве пусто: ближайший разбор всего на 0.53, при обычных 0.64. Похоже, рядом почти не бурили.
Толщина среза мозговой ткани в исследовании — всего 5 микрон, что примерно в 20 раз тоньше человеческого волоса. При этом сеть DenseNet-121 содержит около 8 миллионов обучаемых параметров — по одному параметру на каждые 0,37 изображения в выборке.
Ключевые числа
- точность DenseNet-121: 88,35%
- точность ResNet-50: 82,12%
- F1-мера DenseNet-121: 0,9116
- количество изображений: 2931
- ложноположительные случаи: 12 из 498