Обучающие данные — это примеры (изображения, тексты или измерения), используемые для обучения модели машинного обучения распознаванию закономерностей и составлению прогнозов. Качество и разнообразие этих данных определяют, чему научится модель и насколько хорошо она будет обобщать новые ситуации. Без репрезентативных обучающих данных даже самый сложный алгоритм потерпит неудачу.
История
Концепция возникла в 1950-х годах с перцептронами, но современное глубокое обучение опирается на огромные наборы данных и вычислительные мощности, которые стали доступны в 2010-х годах.
Как это работает
Во время обучения модель корректирует свои внутренние параметры, чтобы минимизировать разницу между своими прогнозами и правильными ответами в обучающих данных. Это делается итеративно, часто с использованием градиентного спуска, где модель учится извлекать релевантные признаки из примеров. Процесс аналогичен подгонке кривой к точкам, но в многомерных пространствах.
Где применяется
Обучающие данные питают нейронные сети, которые диагностируют заболевания по медицинским изображениям, прогнозируют погодные условия и переводят языки в реальном времени.
Любопытный факт
Некоторые обучающие наборы данных содержат миллиарды примеров, например, текстовый корпус, используемый для обучениябольших языковых моделей, который включает значительную часть публичного интернета.
В антарктическом льду частица-призрак оставляет после себя лишь слабую вспышку синего света. Детектор IceCube ловит эти вспышки, и по ним нужно понять, откуда прилетела частица. Модель PolarBERT научилась это делать, но что именно она видит внутри — оставалось загадкой.
Белок в клетке не статичен, как манекен в витрине. Его атомы непрерывно колеблются, растягиваются и изгибаются — подобно натянутой гитарной струне, которая продолжает вибрировать после щипка. Чтобы понять функцию белка, необходимо оценить жёсткость связей между его участками.
Белковый инженер похож на повара, который пытается сделать блюдо одновременно вкусным, полезным и дешёвым. Изменяя один ингредиент, он рискует испортить другой. Раньше компьютерные помощники умели оценивать свойства белков только по отдельности, не видя, как они связаны между собой.
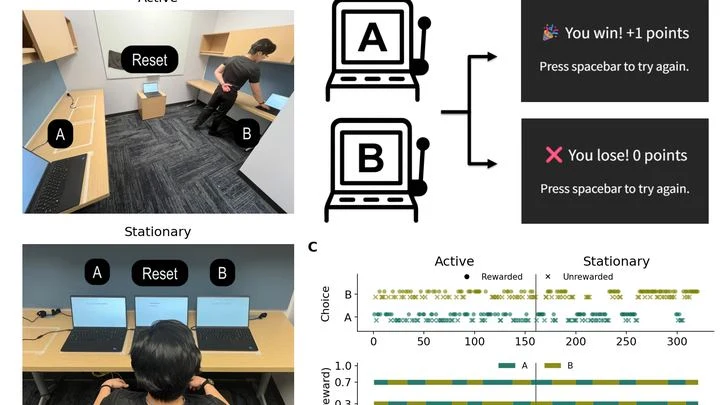
Человек подбрасывает монетку, чтобы принять решение. Стоя на месте, он видит орла. Делает несколько шагов — и снова бросает. Интуитивно кажется, что ходьба не должна влиять на исход броска. Но что, если сама прогулка меняет то, как часто он решает просто повторить прошлый результат?
Именно это проверили исследователи.
Четыре слабых штриха на снимке — всё, что видит астроном. Так скульптор по четырём теням восстанавливает форму невидимого стекла. Около ста лет назад Альберт Эйнштейн предсказал, а Фриц Цвикки предложил использовать гравитационные линзы — естественные телескопы из тёмной материи, усиливающие свет далёких…
Сто тысяч звёзд в тесном ядре шарового скопления движутся как стальные шарики в гигантском пинбольном автомате. Каждый «толчок» — гравитационная встреча двойной системы с одиночной звездой — запускает каскад непредсказуемых событий. Пара может разлететься, чужак может выбить одного из партнёров и занять его место, а иногда все трое застревают в запутанном иерархическом танце.
Огромная библиотека, где каждая книга — точная инструкция по сборке одной молекулы белка. Нейросеть AlphaFold2 прочитала миллионы таких книг и научилась мгновенно выдавать готовую трёхмерную модель. Но внутри этой сети, в самом её «мозгу», осталось нечто большее — не просто правила сборки, а целый атлас возможных движений белка, его скрытая жизнь.
Исследователи придумали способ заглянуть в этот атлас.
Пилоту в воздушном бою необходимо мгновенно идентифицировать объект и его намерения. Традиционные системы ожидают полного набора радарных данных — это сродни вратарю, который реагирует лишь после удара по мячу. Новый алгоритм действует как опытный вратарь: анализируя начальные движения нападающего, он предсказывает манёвр цели задолго до завершения траектории.
Радиосигналы в замкнутом пространстве ведут себя подобно акустическим волнам в концертном зале: многократно отражаясь от стен, мебели и других поверхностей, они формируют уникальную интерференционную картину — своего рода безмолвную «мелодию» каждого места. Смартфон, оснащённый приёмником, подобно чуткому уху, регистрирует эту картину через анализ помех и искажений сигнала.
Робот-жонглёр ловит и бросает мячи в точном ритме с человеком, словно два пульсара — быстро вращающихся нейтронных звёзд, испускающих строго периодические импульсы, — посылающих сигналы в унисон. Жонглирование тремя мячами — это классический каскад, подчиняющийся чёткому такту, похожему на равномерное вращение космического маяка. Нарушишь ритм — и узор рассыплется.
Искусственный интеллект, предсказывающий акустику помещения, напоминает студента на экзамене со шпаргалкой. Если проверочные точки совпадают с учебными, модель просто запоминает звуковой «отпечаток» каждой позиции — как студент, узнающий билет по загибу уголка.
Модели, превращающие текст в аудио, хорошо воссоздают одиночные звуки, но путаются, когда в сценарии их несколько. Например, по сценарию сначала звонок, потом шаги, потом хлопок двери. Генератор может переставить события, и зритель услышит шаги до звонка.
Исследователи нашли неожиданное решение: вместо программирования сложных правил они взяли нейросеть, которая «понимает» аудио, и сделали её строгим контролёром.
Современный стандартный подход к обучению искусственного интеллекта можно сравнить с ребёнком, запертым в библиотеке: он запоминает миллионы книг, но не знает, что огонь обжигает, а падение приносит боль.
Мозг общается короткими электрическими разрядами — потенциалами действия. Прежде расшифровка этого языка требовала тысяч размеченных примеров: экспериментатор сопоставлял сигнал с конкретным движением или словом. Метод MOJO предлагает иной подход — подобно изучению языка через погружение, он сначала вслушивается в «поток сознания» без всяких подсказок и самостоятельно выявляет повторяющиеся паттерны.
Оценка качества снимка — это работа для дотошного контролёра с целым арсеналом инструментов. Нейросеть IQA-T1 действует именно так: она не просто разглядывает картинку, а методично применяет то спектроскоп, то люксметр. Цифровой шум, словно рябь на воде, маскирует дефекты, но анализ частот — спектроскопия изображения — позволяет выявить потерю резкости.
Традиционно алгоритмы машинного обучения действуют в статичном окружении — подобно воде, которая течёт по уже проложенному руслу, не меняя его формы. Новый метод переворачивает эту парадигму: он позволяет агенту одновременно осваивать действия и целенаправленно изменять саму среду, в которой он существует.
Когда вы набираете «салат», а интеллектуальная клавиатура предлагает «цезарь», за кулисами миллионы телефонов совместно обучаются предсказывать слова. Они обмениваются не вашими сообщениями, а лишь улучшениями общего алгоритма — подобно тренеру, который рассылает спортсменам только изменения в плане тренировок: «добавьте 5 отжиманий к вчерашней программе».
Исследователи отобрали 16 повседневных действий — от мытья посуды до приседаний — и разложили движения на элементарные составляющие, подобно тому, как спектроскоп разделяет свет на спектр частот. Они сравнили три подхода к анализу и обнаружили неожиданный ключ к распознаванию: для идентификации действия достаточно усреднённого стоп-кадра, то есть статичной позы.
Семейное древо превращается в клубок, если учесть приёмных детей и повторные браки. Эволюция часто похожа на такой клубок: хотя стандартная модель — традиционное представление о дивергентной эволюции, где виды ветвятся подобно дереву — рисует аккуратное древо видов, на деле гены кочуют не только по наследству, но и напрямую между неродственными организмами — этот…
Сложные технические системы — от дронов до роботов-хирургов — порой ведут себя подобно дикому мустангу: они полны беспорядка и капризов, где лёгкое прикосновение вызывает бурю. Вместо того чтобы заучивать громоздкие формулы, новый метод наблюдает за системой, словно опытный объездчик.
Живая энергосистема подобна организму: линии электропередач — это сосуды, по которым течёт ток-кровь. Данные же — нервные импульсы, которые прежде рассеивались, не достигая единого центра обработки. Проект mAIEnergy подключает эти «нервы» к общему «мозгу», создавая хранилище, где собраны спутниковые снимки, показания электросчётчиков, научные статьи и метеосводки.
Опытный сыщик не вычисляет путь преступника, решая дифференциальные уравнения движения, — он обращается к картотеке схожих дел. Точно так же действует новый метод предсказания: в его основе не сложные формулы, а гигантский архив уже реализованных траекторий — движений планет, колебаний валютных курсов, сигналов из глубин космоса.
Машинное обучение давно перестало быть просто инструментом — оно становится исследователем, самостоятельно выуживающим законы природы из данных. Но как кремниевый разум приходит к пониманию? Чтобы подсмотреть этот процесс, физики обратились к игрушечной, но глубокой модели — решётке Изинга, где спины танцуют под диктовку температуры.
Гамма-небо, запечатлённое телескопом Fermi, — это грандиозная симфония из тысяч источников. Здесь ритмичные пульсации пульсаров, мощные аккорды активных ядер галактик, но больше всего — неотождествлённых объектов, чья партия остаётся загадкой.
Гравитационные сигналы от умирающих массивных звёзд — это шёпот, долетающий до нас из самых жестоких лабораторий Вселенной. Эйнштейн предсказал эти гравитационные волны более века назад, но лишь сегодня, с детекторами вроде LIGO, мы начинаем их слышать.
Гибридные перовскиты — восходящие звёзды фотовольтаики: их эффективность растёт так быстро, что кажется, будто мы на пороге солнечной революции. Но эти материалы, словно искусные мозаики из атомов, чрезвычайно уязвимы: влага, тепло и свет быстро превращают их в пыль.
Нейрон похож на сложный музыкальный инструмент. Чтобы понять, как он отзовётся на прикосновение, раньше приходилось подключаться к каждой струне напрямую — процедура тонкая, медленная и доступная лишь для единичных клеток. Матрицы микроэлектродов (сетки из сотен датчиков) слушают весь оркестр сразу, но расшифровать, какой именно инструмент играет, по общему гулу долго не удавалось.
Представьте прослушивание в симфонический оркестр, где из сотен претендентов остаются лишь те, чьи инструменты звучат чисто и выдерживают яростное крещендо. В мире материалов компьютеры научились генерировать «атомные партитуры» — тысячи виртуальных кристаллов, обещающих стать основой для квантовых чипов или сверхпроводников.
Спустя почти век после того, как Фриц Цвикки заподозрил неладное в движении галактик скопления Волос Вероники, а Вера Рубин измерила звёздные скорости в спиральных рукавах, природа тёмной материи остаётся одной из самых мучительных загадок.
60 мышей, 1980 образцов, 234 пациента с раком лёгкого. За каждым числом — тысячи генов. Их активность измеряют, чтобы понять болезнь. Но данные не однородны: у одного больного оценивают уровень белка (непрерывное число), ставят диагноз (да/нет) и определяют подтип опухоли (категория). Смешать их в одной модели — как сложить градусы Цельсия и километры.
Врач листает историю болезни и видит строчку: «Препарат снижает риск». Но насколько этому можно верить? Основано ли утверждение на паре случаев из практики или на десятках тысяч пациентов в слепом исследовании? От ответа зависит лечение. Сегодня такие тексты всё чаще пишут не люди, а большие языковые модели — те самые, что помогают искать информацию и составлять сводки.
Обычные нейросети учатся на примерах, как человек, заучивающий мелодии на слух: они накапливают статистические закономерности, но не понимают глубинных правил. Иной подход — физически-информированные нейронные сети, в архитектуру которых изначально встроены фундаментальные законы физики, такие как уравнения сохранения энергии или уравнения движения.
Шеф-повар не тратит продукты, готовя всё блюдо, чтобы оценить вкус, — он пробует каплю соуса. Та же логика лежит в основе метода «информационного сопоставления» (information matching) для предсказания прочности металлов.
Проектирование машин сродни кулинарии: необходимо точно знать, где «тесто» порвётся. Классические численные методы, например, анализ методом конечных элементов, проверяют каждую точку детали часами — это как обмерять всю кастрюлю, чтобы ручка не отвалилась.
Представьте кипящий чайник с плотно закрытой крышкой: бурления не видно, но звук и вибрация выдают мощность нагрева воды. Подобно этому, квантовые системы скрывают свою предельную чувствительность — способность улавливать магнитные поля или гравитационные волны — за сложной внутренней динамикой.
Кассир в супермаркете в час пик не запоминает каждую пробитую покупку — он держит в голове общую сумму и следит за очередью. Примерно так же мозг распределяет свои силы: дорогая и точная кора (то, что отвечает за обдумывание) и более простые, экономные подкорковые ядра (где живут привычки) работают в паре.
Классические нейросети требуют тысяч примеров, часов обучения и гигаватты энергии. Физики предложили квантовый обходной путь, опирающийся на фундаментальные принципы. Ещё Макс Планк установил дискретность энергии — её квантование, и сегодня это позволяет генерировать образы без этапа обучения.
У одного человека болезнь начинается с дрожи в руке — чашка пляшет на блюдце, пока он несёт её к столу. У другого — ноги вдруг отказываются идти ровно: шаг становится коротким, шаркающим, будто пол внезапно покрылся липким слоем. Это не две разные болезни, а два лица одной и той же — болезни Паркинсона.
Мозаика из крупных цветных плиток. Каждая плитка — это среднее количество осадков за целый месяц на территории размером с небольшую страну. Для общего понимания картина годится, но если нужно узнать, прошёл ли вчера ливень над конкретным городом, — бесполезна.
Каждый раз, когда вы раздумываете над рискованным шагом — вложить ли деньги в акции или переждать, — в голове идёт внутренний диалог. Обычно учёные пытаются восстановить ход этого диалога по одному лишь итоговому выбору, как если бы детектив восстанавливал разговор двух людей, глядя на фотографию места встречи. Такой картины часто не хватает: одни и те же действия могут родиться из совершенно разных размышлений.