Обучение — это ключевой процесс в машинном обучении, в ходе которого внутренние параметры модели итеративно корректируются, чтобы минимизировать разницу между её предсказаниями и реальными результатами в наборе данных. Это достигается путём подачи модели примеров, сравнения её выхода с известным правильным ответом и обновления параметров для уменьшения ошибки. Цель состоит в том, чтобы модель выявила закономерности в данных и могла делать точные предсказания на новых, ранее не виденных данных.
История
Концепция обучения нейронных сетей путём подстройки весов восходит к 1950-м годам и перцептрону Фрэнка Розенблатта, однако современный алгоритм обратного распространения ошибки, сделавший обучение многослойных сетей практичным, был популяризирован в 1980-х годах Дэвидом Румельхартом, Джеффри Хинтоном и Рональдом Уильямсом.
Как это работает
Обучение обычно включает алгоритм оптимизации, такой как градиентный спуск. Модель делает предсказание, функция потерь количественно оценивает, насколько оно ошибочно, и алгоритм вычисляет градиент этой ошибки по каждому параметру. Затем параметры корректируются в направлении уменьшения ошибки, и этот процесс повторяется на протяжении многих итераций (эпох), пока ошибка не сойдётся к минимуму. Выбор архитектуры, качество данных и гиперпараметры, такие как скорость обучения, влияют на то, насколько эффективно модель обучается.
Некоторые модели нейронных сетей настолько сложны, что их обучение может потреблять столько же электроэнергии, сколько небольшой город, и для завершения процесса за разумное время часто требуется специализированное оборудование, такое как GPU или TPU.
Белок в клетке не статичен, как манекен в витрине. Его атомы непрерывно колеблются, растягиваются и изгибаются — подобно натянутой гитарной струне, которая продолжает вибрировать после щипка. Чтобы понять функцию белка, необходимо оценить жёсткость связей между его участками.
Алмаз — не просто украшение. Внутри его кристаллической решётки прячутся дефекты, которые чувствуют магнитное поле лучше многих приборов. Один такой дефект — NV-центр — работает как крошечный компас, но его стрелка колеблется от тепла и шума. Чтобы компас показывал точное направление, нужна калибровка.
Белковый инженер похож на повара, который пытается сделать блюдо одновременно вкусным, полезным и дешёвым. Изменяя один ингредиент, он рискует испортить другой. Раньше компьютерные помощники умели оценивать свойства белков только по отдельности, не видя, как они связаны между собой.
Переводчик отвлекается на каждый шорох в зале — и час совещания превращается в два. Так и молекулярные фундаментальные модели: они выучивают язык молекул на гигантских корпусах, но для каждого нового разговора требуют настройки. Monroe меняет правила: она не учит новый язык, а мгновенно находит общий смысл по нескольким примерам.
Термоядерный реактор — это сверхгорячая печь, где плазма раскалена до миллионов градусов. Стенки такой печи делают из вольфрама: он тугоплавкий, как никакой другой металл. Но даже вольфрам не выдерживает без защиты: быстрые частицы из плазмы бомбардируют поверхность и выбивают атомы.
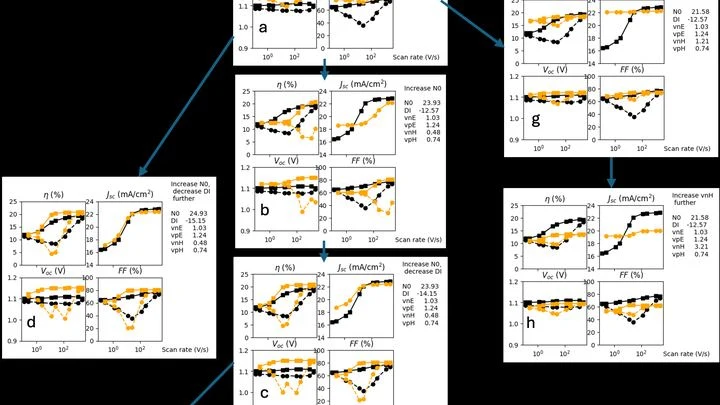
Перовскитная солнечная батарея напоминает молодую спортсменку: на старте демонстрирует выдающиеся показатели, но быстро утомляется. Всего за восемь часов её эффективность заметно снижается, хотя видимых дефектов — трещин, пыли, отслоений — не наблюдается.
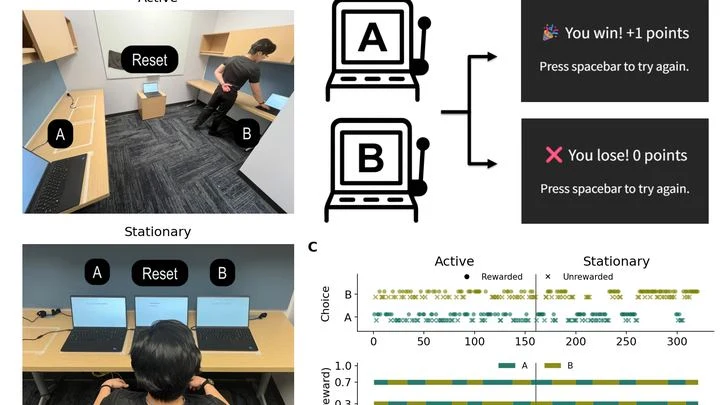
Человек подбрасывает монетку, чтобы принять решение. Стоя на месте, он видит орла. Делает несколько шагов — и снова бросает. Интуитивно кажется, что ходьба не должна влиять на исход броска. Но что, если сама прогулка меняет то, как часто он решает просто повторить прошлый результат?
Именно это проверили исследователи.
Представьте склад с коробками яблок и груш. Яблок много, груш мало. Но когда кладовщик говорит «фрукт с гладкой кожурой», мы почему-то чаще вспоминаем редкую грушу, а не частое яблоко. Это проявление эффекта обратной базовой ставки — устойчивого когнитивного искажения, при котором мозг, разрешая неоднозначность между категориями, систематически переоценивает редкие варианты за счёт частых.
Нейросеть предсказывает будущее динамической системы — например, эволюцию плазмы в магнитном поле или изменение лица на видео. Ошибки неизбежны, и чем дальше модель заглядывает вперёд, тем больше их накапливается. Свериться с правильным ответом в момент работы невозможно: его просто не существует.
Авторы новой работы нашли простой, как всё гениальное, трюк: обучить одну модель двигаться и вперёд, и назад по времени.
Внутри каждой клетки кипит своя логистика: крошечные белковые моторы, словно курьеры, таскают грузы по сети микротрубочек. Один из главных работяг — кинезин, шагающий с помощью энергии АТФ (главной энергетической валюты клетки). Долгое время его пытались оценить, как автомобиль: сколько топлива потратил, как быстро доехал.
Сто тысяч звёзд в тесном ядре шарового скопления движутся как стальные шарики в гигантском пинбольном автомате. Каждый «толчок» — гравитационная встреча двойной системы с одиночной звездой — запускает каскад непредсказуемых событий. Пара может разлететься, чужак может выбить одного из партнёров и занять его место, а иногда все трое застревают в запутанном иерархическом танце.
Пилоту в воздушном бою необходимо мгновенно идентифицировать объект и его намерения. Традиционные системы ожидают полного набора радарных данных — это сродни вратарю, который реагирует лишь после удара по мячу. Новый алгоритм действует как опытный вратарь: анализируя начальные движения нападающего, он предсказывает манёвр цели задолго до завершения траектории.
Алгоритм улучшения фотографий можно представить как навигатор, который шаг за шагом ведёт размытое изображение к чёткости. Он удаляет шум — случайные искажения сигнала и дефекты, перемещаясь от пикселя к пикселю по своеобразной «карте», заложенной при обучении.
Радиосигналы в замкнутом пространстве ведут себя подобно акустическим волнам в концертном зале: многократно отражаясь от стен, мебели и других поверхностей, они формируют уникальную интерференционную картину — своего рода безмолвную «мелодию» каждого места. Смартфон, оснащённый приёмником, подобно чуткому уху, регистрирует эту картину через анализ помех и искажений сигнала.
Обычные алгоритмы компьютерного зрения воспринимают медицинские изображения как набор несвязанных фрагментов — любые два несовпадающих снимка для них абсолютно различны. Это напоминает попытку отличить близнецов, не зная об их родстве. В медицине же пациенты с одним заболеванием часто выглядят на МРТ почти идентично, и алгоритм ошибается, путая «родственные» случаи.
Робот-жонглёр ловит и бросает мячи в точном ритме с человеком, словно два пульсара — быстро вращающихся нейтронных звёзд, испускающих строго периодические импульсы, — посылающих сигналы в унисон. Жонглирование тремя мячами — это классический каскад, подчиняющийся чёткому такту, похожему на равномерное вращение космического маяка. Нарушишь ритм — и узор рассыплется.
Искусственный интеллект, предсказывающий акустику помещения, напоминает студента на экзамене со шпаргалкой. Если проверочные точки совпадают с учебными, модель просто запоминает звуковой «отпечаток» каждой позиции — как студент, узнающий билет по загибу уголка.
Вы стоите под душем: поворачиваете вентиль, а вода — то ледяная, то обжигающая. Трубы живут собственной жизнью: давление скачет непредсказуемо, словно капризный оркестр без дирижёра.
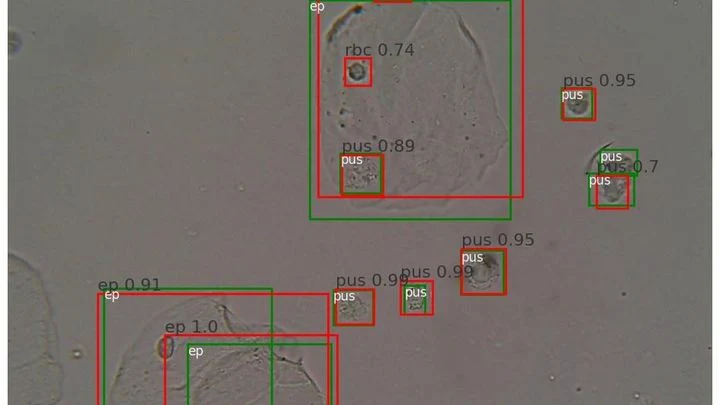
Капля мочи под микроскопом — не плоская лужица, а многослойный объём. Представьте стопку прозрачных страниц: если фокусироваться на одной, соседние расплываются. Так и свет микроскопа, подчиняясь законам оптики, чётко показывает только один слой глубины.
Мозг общается короткими электрическими разрядами — потенциалами действия. Прежде расшифровка этого языка требовала тысяч размеченных примеров: экспериментатор сопоставлял сигнал с конкретным движением или словом. Метод MOJO предлагает иной подход — подобно изучению языка через погружение, он сначала вслушивается в «поток сознания» без всяких подсказок и самостоятельно выявляет повторяющиеся паттерны.
В кастрюле с супом достаточно двух термометров, чтобы понять температуру везде — если знать, что тепло идёт кругами от дна. Так и в науке: по редким замерам нужно восстановить полную картину теплового поля.
Представьте водителя на обледенелой трассе: он не знает точной реакции машины на поворот руля и вынужден учиться в процессе, интуитивно сохраняя запас пространства для возможной ошибки. Сходным образом действует адаптивный алгоритм управления.
Традиционно алгоритмы машинного обучения действуют в статичном окружении — подобно воде, которая течёт по уже проложенному руслу, не меняя его формы. Новый метод переворачивает эту парадигму: он позволяет агенту одновременно осваивать действия и целенаправленно изменять саму среду, в которой он существует.
Приготовление сложного блюда требует чёткого рецепта: сначала нарезать, потом обжарить, добавить специи в нужный момент. Химические превращения тоже идут по пошаговым рецептам — механизмам, где атомы углерода и водорода перестраиваются строго по очереди.
Раньше нейросети часто выдумывали несуществующие шаги, как повар-фантазёр, заменяющий соль сахаром.
Когда вы набираете «салат», а интеллектуальная клавиатура предлагает «цезарь», за кулисами миллионы телефонов совместно обучаются предсказывать слова. Они обмениваются не вашими сообщениями, а лишь улучшениями общего алгоритма — подобно тренеру, который рассылает спортсменам только изменения в плане тренировок: «добавьте 5 отжиманий к вчерашней программе».
Исследователи отобрали 16 повседневных действий — от мытья посуды до приседаний — и разложили движения на элементарные составляющие, подобно тому, как спектроскоп разделяет свет на спектр частот. Они сравнили три подхода к анализу и обнаружили неожиданный ключ к распознаванию: для идентификации действия достаточно усреднённого стоп-кадра, то есть статичной позы.
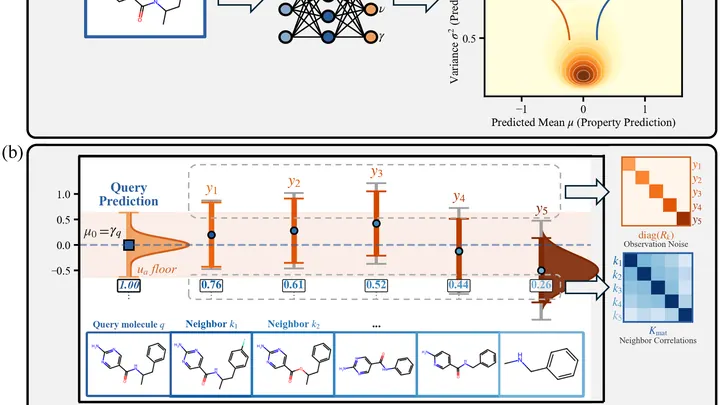
Предсказать свойства новой молекулы — сродни попытке угадать вкус незнакомого блюда. Программа работает как опытный повар: она «пробует» похожие молекулы, чьи свойства уже известны, и на основе их «вкуса» уточняет свою догадку. Например, для воды или углекислого газа алгоритм находит изученные аналоги и корректирует температуру кипения или растворимость.
Поплавок в бачке унитаза — идеальный контроллер: чувствуя уровень воды, он мгновенно приводит систему в равновесие без оглядки на прошлое. Инженеры применили этот принцип к нейросетям. Они переписали стандартную архитектуру так, что вместо каскада вычислений она решает одно уравнение равновесия.
Сложные технические системы — от дронов до роботов-хирургов — порой ведут себя подобно дикому мустангу: они полны беспорядка и капризов, где лёгкое прикосновение вызывает бурю. Вместо того чтобы заучивать громоздкие формулы, новый метод наблюдает за системой, словно опытный объездчик.
Долгое время идентификация квантовых фаз напоминала допрос свидетеля: нужно было добраться до каждого уголка системы, чтобы выведать её тайну. В эпоху Ландау порядок связывали с нарушением симметрии и локальным параметром — всё как на ладони.
Машинное обучение давно перестало быть просто инструментом — оно становится исследователем, самостоятельно выуживающим законы природы из данных. Но как кремниевый разум приходит к пониманию? Чтобы подсмотреть этот процесс, физики обратились к игрушечной, но глубокой модели — решётке Изинга, где спины танцуют под диктовку температуры.
DFTB — это скоростной поезд в мире квантовой химии: в сотни раз быстрее классического DFT, но всё ещё на электронных рельсах. Однако его двигатель — итеративное самосогласование зарядов — порой напоминает оркестр, где каждый инструмент начинает с произвольной ноты.
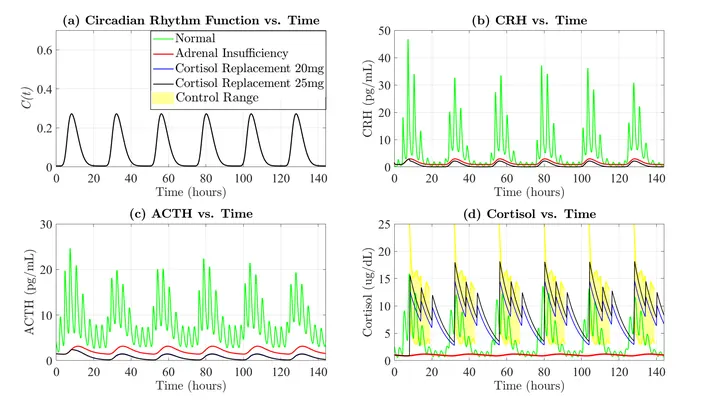
Внутри каждого из нас тикают невидимые часы. Они управляют выбросом кортизола — гормона, который помогает просыпаться по утрам, справляться с тревогой и держать иммунитет в тонусе. При надпочечниковой недостаточности эти часы ломаются: организм не может сам производить нужное количество кортизола.
Гравитационные сигналы от умирающих массивных звёзд — это шёпот, долетающий до нас из самых жестоких лабораторий Вселенной. Эйнштейн предсказал эти гравитационные волны более века назад, но лишь сегодня, с детекторами вроде LIGO, мы начинаем их слышать.
Гравитационное микролинзирование — удивительный космический эффект, предсказанный Эйнштейном и развитый Цвикки. Массивное тело, проходя между нами и далёкой звездой, искривляет её свет подобно линзе, создавая характерные усиления и искажения.
Гибридные перовскиты — восходящие звёзды фотовольтаики: их эффективность растёт так быстро, что кажется, будто мы на пороге солнечной революции. Но эти материалы, словно искусные мозаики из атомов, чрезвычайно уязвимы: влага, тепло и свет быстро превращают их в пыль.
В кастрюле с бульоном плавают молекулы. Одни копируют себя сами, другие помогают соседям, третьи только мешают. Это не суп, а модель ранней жизни — репликаторная система. Обычно считают, что правила игры заданы раз и навсегда: кто быстрее размножается, тот и побеждает. Но авторы работы предположили другое — правила тоже могут меняться, просто очень медленно.
Они разделили время на два потока.
Рекомендательные системы, определяющие, какой пост вы увидите следующим, работают на глубоких нейросетях из тысяч операций — сложных графов вычислений (схемах из операций над данными). Эти системы — живые, постоянно эволюционирующие динамические системы: малейшее изменение архитектуры распространяется каскадом по всему графу.
Представьте прослушивание в симфонический оркестр, где из сотен претендентов остаются лишь те, чьи инструменты звучат чисто и выдерживают яростное крещендо. В мире материалов компьютеры научились генерировать «атомные партитуры» — тысячи виртуальных кристаллов, обещающих стать основой для квантовых чипов или сверхпроводников.
60 мышей, 1980 образцов, 234 пациента с раком лёгкого. За каждым числом — тысячи генов. Их активность измеряют, чтобы понять болезнь. Но данные не однородны: у одного больного оценивают уровень белка (непрерывное число), ставят диагноз (да/нет) и определяют подтип опухоли (категория). Смешать их в одной модели — как сложить градусы Цельсия и километры.