Скоростьобучения — это гиперпараметр в машинном обучении, который управляет размером шага при обновлении параметров модели во время тренировки. Он определяет, насколько быстро уменьшается ошибка (потери) модели при итерациях по данным. Высокая скорость обучения заставляет модель учиться быстро, но существует риск перескочить оптимальное решение; низкая скорость обучения делает обучение медленным, но более стабильным. Скорость обучения — одна из наиболее критичных настроек при обучении нейронных сетей, так как она напрямую влияет на сходимость и итоговую производительность.
История
Понятие скоростиобучения возникло с развитием градиентной оптимизации в 1950-х и 1960-х годах, особенно в контексте обучения перцептрона и ранних нейронных сетей. Оно стало стандартным термином в 1980-х годах с появлением метода обратного распространения ошибки.
Как это работает
Во время обучения модель вычисляет градиент функции потерь по своим параметрам. Затем параметры обновляются вычитанием градиента, умноженного на скорость обучения. Это стандартное правило обновления градиентного спуска. Скорость обучения масштабирует градиентный шаг: большее значение означает большие прыжки в пространстве параметров, а меньшее — более тонкие корректировки. Современные оптимизаторы, такие как Adam, адаптивно регулируют скорость обучения для каждого параметра, но базовую скорость обучения всё равно задаёт специалист.
Где применяется
Планирование скоростиобучения — регулировка скорости обучения во время тренировки — используется практически во всех приложениях глубокого обучения, от распознавания изображений до обработки естественного языка, для улучшения сходимости и избежания локальных минимумов.
Любопытный факт
Слишком высокая скоростьобучения может привести к расхождению потерь до бесконечности, а слишком низкая — к застреванию на плато, что делает время обучения непрактично долгим.
Старый водопровод гудит иначе, чем новый. Труба, потерявшая гибкость, отзывается на каждый толчок воды резким эхом, которое возвращается к насосу быстрее, чем в молодой системе. Нечто похожее происходит с нашими артериями: с годами их стенки твердеют, и пульсовая волна, добежав до мелких сосудов, отражается назад к сердцу почти без задержки.
Белок в клетке не статичен, как манекен в витрине. Его атомы непрерывно колеблются, растягиваются и изгибаются — подобно натянутой гитарной струне, которая продолжает вибрировать после щипка. Чтобы понять функцию белка, необходимо оценить жёсткость связей между его участками.
Белковый инженер похож на повара, который пытается сделать блюдо одновременно вкусным, полезным и дешёвым. Изменяя один ингредиент, он рискует испортить другой. Раньше компьютерные помощники умели оценивать свойства белков только по отдельности, не видя, как они связаны между собой.
Перовскитная солнечная батарея напоминает молодую спортсменку: на старте демонстрирует выдающиеся показатели, но быстро утомляется. Всего за восемь часов её эффективность заметно снижается, хотя видимых дефектов — трещин, пыли, отслоений — не наблюдается.
Представьте горный перевал, соединяющий две долины. В одной долине белок пребывает в свёрнутом, функциональном состоянии, в другой — в развёрнутом, хаотичном. Чтобы перейти из одной формы в другую, молекуле необходимо преодолеть седловину — наивысшую точку на энергетическом ландшафте.
Нейросеть предсказывает будущее динамической системы — например, эволюцию плазмы в магнитном поле или изменение лица на видео. Ошибки неизбежны, и чем дальше модель заглядывает вперёд, тем больше их накапливается. Свериться с правильным ответом в момент работы невозможно: его просто не существует.
Авторы новой работы нашли простой, как всё гениальное, трюк: обучить одну модель двигаться и вперёд, и назад по времени.
Художник делает быстрый набросок углём — и лицо на портрете уже узнаваемо. Астрофизики решают схожую задачу: спектр звезды — это её индивидуальный портрет, раскрывающий температуру, состав, силу тяжести. До недавнего времени для получения такого портрета требовалась кропотливая «живопись маслом» — код радиативного переноса в условиях отклонения от локального теплового равновесия (non-LTE).
Сто тысяч звёзд в тесном ядре шарового скопления движутся как стальные шарики в гигантском пинбольном автомате. Каждый «толчок» — гравитационная встреча двойной системы с одиночной звездой — запускает каскад непредсказуемых событий. Пара может разлететься, чужак может выбить одного из партнёров и занять его место, а иногда все трое застревают в запутанном иерархическом танце.
Связь со спутником напоминает попытку расслышать шёпот в бурю: полезный сигнал тонет в хаосе помех. Инженеры разработали алгоритм на основе искусственного интеллекта, который функционирует непосредственно на борту спутника и при минимальном энергопотреблении распознаёт искажения точнее традиционных методов.
Искусственный интеллект, предсказывающий акустику помещения, напоминает студента на экзамене со шпаргалкой. Если проверочные точки совпадают с учебными, модель просто запоминает звуковой «отпечаток» каждой позиции — как студент, узнающий билет по загибу уголка.
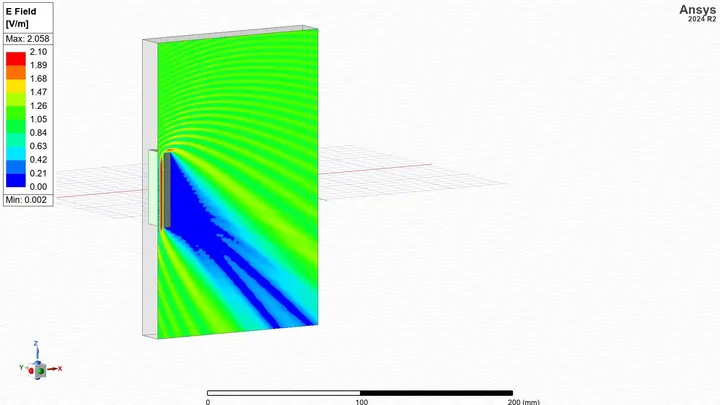
Когда радиоволна встречает на пути здание, она не просто отражается или поглощается — она огибает его, подобно тому как морские волны обтекают скалу, оставляя за ней спокойную воду. В радиофизике это явление создаёт радиотень — сложный узор из зон усиления и ослабления сигнала, который учёные называют радиопортретом.
Автоматические судьи речи — это алгоритмы, обученные оценивать произношение и эмоциональную окраску голоса. Однако, как показали исследования, они часто ведут себя подобно кулинарному критику, который выносит вердикт, прочитав меню, но не попробовав само блюдо.
Представьте себе умную антенную панель — фазированную решётку, — которая управляет радиоволнами, несущимися с скоростью света. Она работает подобно оркестру: сотни миниатюрных излучателей, словно музыкальные инструменты, по команде с изменяемым напряжением сдвигают фазу (момент «вступления» в общее звучание).
Представьте опытного шеф-повара в час пик: внезапно отказывает плита или заканчивается ключевой ингредиент. Вместо паники он мгновенно перекраивает рецептуру — ускоряет приготовление одних блюд, замедляет другие, перебрасывая ресурсы на ходу. Этот принцип динамической адаптации лёг в основу нового поколения сверхнадёжных сетей.
После брошенного камня круги на воде исчезают, но жидкость хранит микроскопические колебания. Малейший порыв — и рябь возникает снова. Сети нейронов ведут себя похоже. Когда электрические сигналы затихают, память о них остаётся в точках контакта — синапсах, где передача импульсов меняет силу связей. Как вода после шторма, эти следы таят скрытую энергию.
В кастрюле с супом достаточно двух термометров, чтобы понять температуру везде — если знать, что тепло идёт кругами от дна. Так и в науке: по редким замерам нужно восстановить полную картину теплового поля.
Традиционно алгоритмы машинного обучения действуют в статичном окружении — подобно воде, которая течёт по уже проложенному руслу, не меняя его формы. Новый метод переворачивает эту парадигму: он позволяет агенту одновременно осваивать действия и целенаправленно изменять саму среду, в которой он существует.
Приготовление сложного блюда требует чёткого рецепта: сначала нарезать, потом обжарить, добавить специи в нужный момент. Химические превращения тоже идут по пошаговым рецептам — механизмам, где атомы углерода и водорода перестраиваются строго по очереди.
Раньше нейросети часто выдумывали несуществующие шаги, как повар-фантазёр, заменяющий соль сахаром.
Программные помощники для написания кода, или AI-ассистенты, часто действуют как повар, который ради варки одного яйца перечитывает всю кулинарную книгу. Получив задачу внести крошечное исправление, они заново открывают десятки файлов и проверяют давно известные связи.
Фотограф снимает ночной лес и пытается поймать в кадр светлячков. Вспышки редкие, слабые, а вокруг — шум ветра и далёкие огни. Примерно так работает огромный детектор Hyper-Kamiokande в Японии: он ловит нейтрино — почти неосязаемые частицы — по крошечным вспышкам света в 260 тысячах тонн воды.
Квантовые расчёты — это рецепт с идеальными ингредиентами, но повар-природа готовит по-своему. Машинные модели атомов выучивают рецепт назубок и предсказывают свойства вещества за секунды вместо недель. Беда в том, что сам рецепт — уравнения Шрёдингера — содержит упрощения: где-то пренебрегли дрожанием электронов, где-то заменили сложный обмен на среднее поле.
В любой компании есть свои негласные тройки: трое друзей, которые всегда вместе. А есть пары, которые существуют сами по себе. Оказывается, от того, насколько тройки «вмещают» в себя пары, зависит, как по группе распространяется всё — от вируса до новой идеи.
Учёные ввели меру, которую назвали коэффициентом вложенности. Он показывает, как часто связи внутри тройки повторяют связи в парах.
Обучение точной аэродинамической модели сродни кулинарному искусству: сначала повар осваивает сотни рецептов, чтобы уловить общие принципы, а затем легко доводит до совершенства конкретное блюдо.
Ядро урана напоминает тугой кошелёк, защёлкнутый на две половинки. Чтобы он лопнул и высвободил энергию — то есть чтобы ядро разделилось, — нужно перевалить через энергетический барьер. Высота этого порога определяет, стабильно вещество или готово распасться в любой момент.
Квантовый компьютер похож на оркестр, где каждый музыкант играет свою партию, но один неверный звук может испортить всю симфонию. Чтобы этого не случилось, нужен слушатель, который мгновенно улавливает фальшь, но не мешает игре. Именно такого слушателя создали физики: детектор, который за 384 наносекунды находит сбой в квантовой системе, почти не касаясь самой информации.
Обучение нейросети похоже на спуск с горы на санках: нужна правильная скорость, чтобы не застрять и не вылететь с трассы. В популярном методе обучения с моментом (как инерция) обычно берут постоянное значение 0,9.
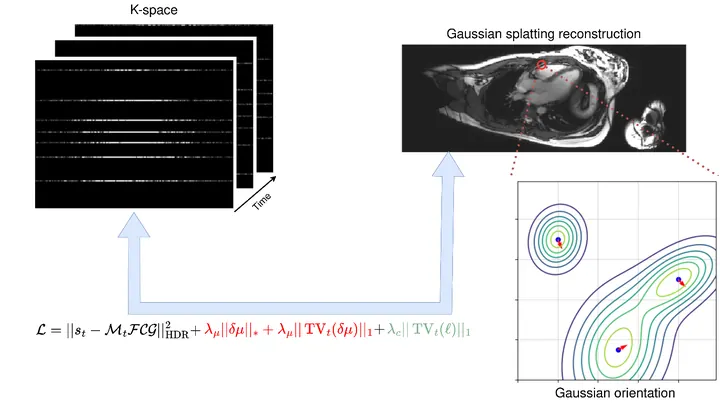
Магнитно-резонансный томограф — это как фотоаппарат, который делает снимки внутренностей, но очень медленно. Пациент должен лежать неподвижно несколько минут, а сердце при этом продолжает биться. Если человек пошевелится или ритм собьётся, картинка смазывается. Врачам приходится повторять сканирование, тратить время и нервы.
Новый метод решает эту проблему необычным способом.
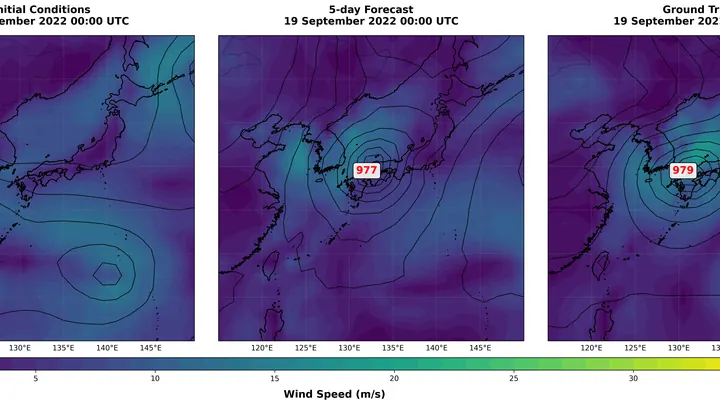
Прогноз погоды — это как попытка предсказать, куда покатится камень по склону, зная форму каждого бугорка и силу ветра. Ошибёшься в начале — и через неделю ошибка вырастет в целую бурю. Раньше для точных прогнозов нужны были огромные компьютеры и многодневные расчёты. Теперь появилась модель Sonny, которая делает то же самое на одной видеокарте.
Sonny работает в два шага.
Перед каждым запуском токамака — установки, где раскалённый газ удерживается магнитным полем, — операторы часами считают, как поведёт себя плазма. Слишком дорого ошибиться: один неверный параметр может сорвать эксперимент. Теперь на помощь приходит нейросеть, которая учится на прошлых запусках и выдаёт прогноз быстрее, чем вы моргнёте.
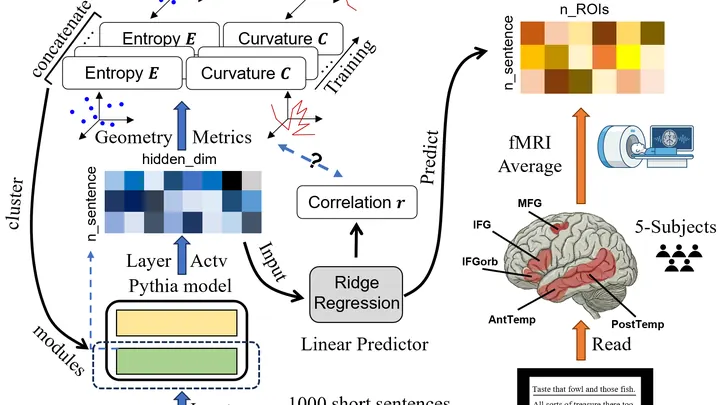
Языковая модель — это многослойная конструкция, где каждый слой обрабатывает слова по-своему. В начале обучения слои хаотичны, но постепенно выстраиваются в две команды. Первая команда работает по-простому: её внутренняя геометрия сглаживается, становится менее запутанной. Вторая остаётся сложной и витиеватой.
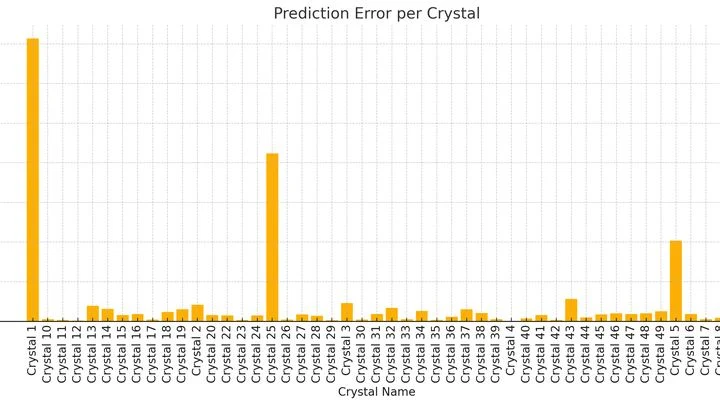
Рост кристалла сверхчистого германия напоминает выпечку капризного суфле: малейший перегрев или лишняя крупинка примеси — и весь слиток годится лишь в переплавку. Такие кристаллы — сердце детекторов, которые ловят редчайшие события: от тёмной материи до двойного бета-распада. Но лишь несколько компаний в мире умеют растить их с высоким выходом, и секреты мастерства передаются десятилетиями.
В тёмной комнате на столе стоят лазерная указка, кусок стекла с тканью и обычная камера от телефона. Свет проходит сквозь образец, и на снимке появляются не клетки, а узор из светлых и тёмных полос — как тень от листвы на стене. По этому узору компьютер учится угадывать, сколько белка HER2 на поверхности раковых клеток груди.
Белок HER2 — как дверная ручка, за которую лекарство может ухватиться.
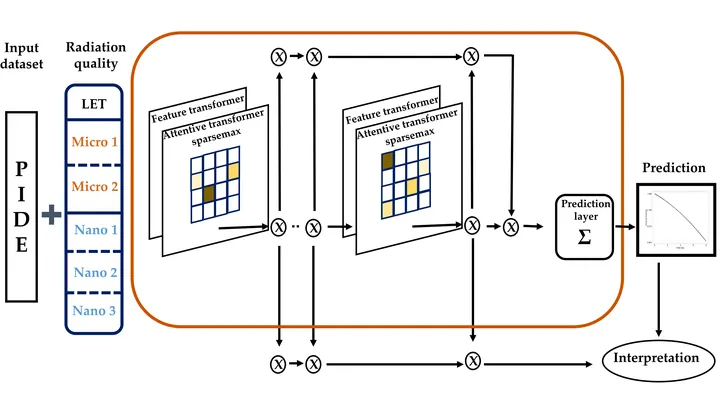
Клетка, попавшая под пучок протонов, напоминает город после точечной бомбардировки: где-то разрушены целые кварталы, а где-то лишь выбиты стёкла. Выживет ли город, зависит от того, какие именно здания задеты — и как распределились удары. Раньше врачи оценивали ущерб по общей мощности бомбёжки, но этого мало: две одинаковые дозы могут оставить совершенно разные разрушения.
Дообучение нейросети сродни попытке изменить чёрную дыру, не переступая её горизонта событий: корректировке подвергается лишь малая часть параметров. Заглянув во внутреннюю структуру, исследователи обнаружили любопытные паттерны — сильные корреляции между фрагментами модели, напоминающие квантовую запутанность.
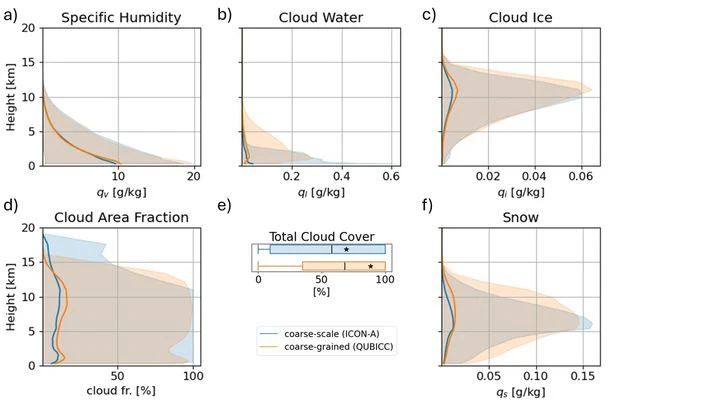
Прогноз климата напоминает сложный кулинарный рецепт: одна неверная щепотка — и всё блюдо испорчено. Так и с облаками — малыми, но решающими ингредиентами. Традиционные климатические модели разбивают атмосферу на ячейки размером 50–100 км и не различают отдельные облака. Это всё равно что сыпать перец горстями, когда рецепт требует аккуратную щепотку.