Экзамен для ИИ-учёного экспресс
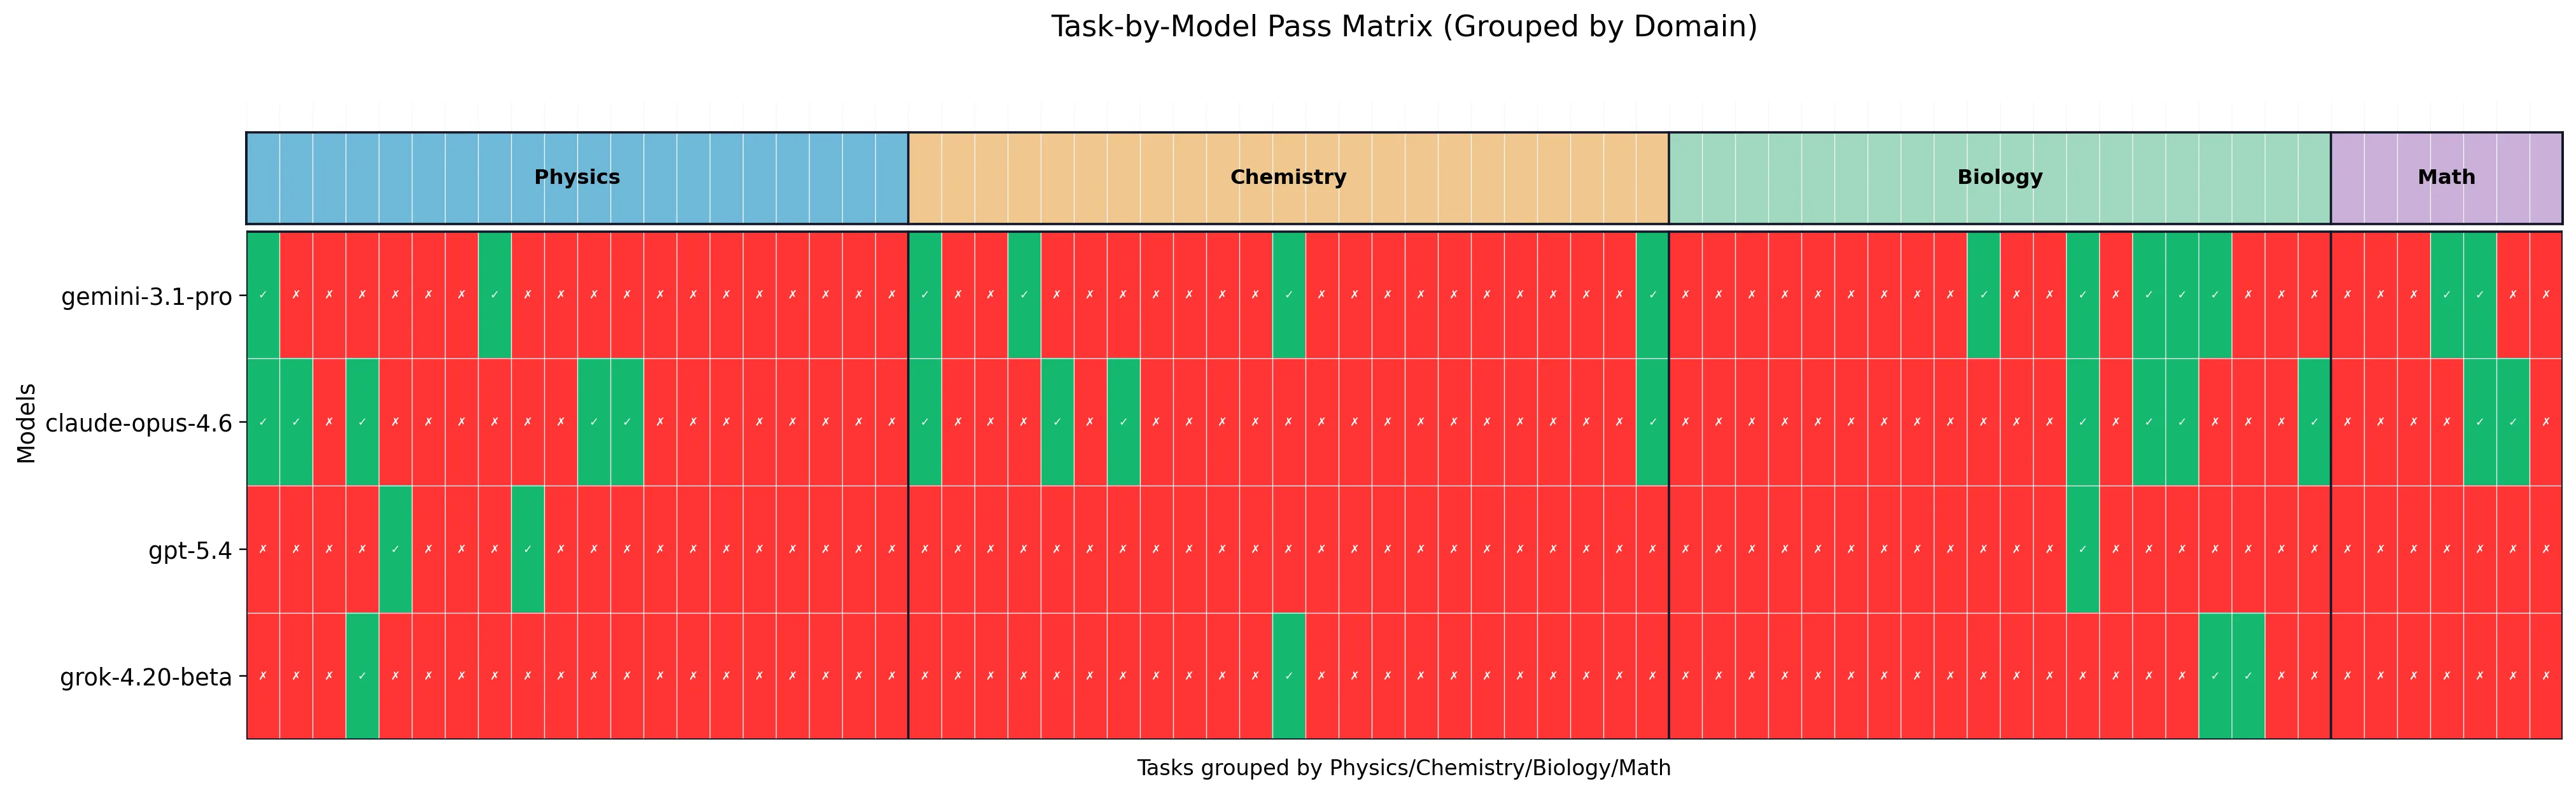
Лучший ИИ-помощник учёного справился с экзаменом хуже, чем троечник с контрольной. Всего 21% правильных ответов — и это потолок для четырёх сильнейших моделей. Задачи для нового теста писали не программисты, а аспиранты: люди, которые каждый день сталкиваются с настоящей наукой.
Тест назвали COMPOSITE-STEM. В нём 70 задач по физике, биологии, химии и математике. В отличие от школьных задачек, здесь нет единственного верного ответа — оценивается сам ход мысли. Например, нужно не просто вычислить число, а объяснить, почему выбран такой метод. Проверяют двумя способами: точным сравнением ответов и судом другой языковой модели.
Результат отрезвляет: даже лучшая модель решает лишь каждую пятую задачу. Значит, до настоящего помощника учёного ИИ ещё далеко. Но тест открыт для всех — любой разработчик может проверить свою модель и попытаться улучшить результат.
Оригинальная аннотация
как её написали авторы, на английском arXiv:2604.09836
AI agents hold growing promise for accelerating scientific discovery; yet, a lack of frontier evaluations hinders adoption into real workflows. Expert-written benchmarks have proven effective at measuring AI reasoning, but most at this stage have become saturated and only measure performance on constrained outputs. To help address this gap, we introduce COMPOSITE-STEM, a benchmark of 70 expert-written tasks in physics, biology, chemistry, and mathematics, curated by doctoral-level researchers. Our benchmark combines exact-match grading and criterion-based rubrics with an LLM-as-a-jury grading protocol, allowing more flexible assessment of scientifically meaningful outputs. Using an adapted multimodal Terminus-2 agent harness within the Harbor agentic evaluation framework, we evaluate four frontier models. The top-performing model achieves 21%, demonstrating that COMPOSITE-STEM captures capabilities beyond current agent reach. All tasks are open-sourced with contributor permission to support reproducibility and to promote additional research towards AI's acceleration of scientific progress in these domains.
Задачи для теста собирали у аспирантов — тех, кто ещё помнит, каково это: сидеть над уравнением до ночи и сомневаться в каждом шаге.