Сообщества по размеру: когда сети собирают как пазл экспресс
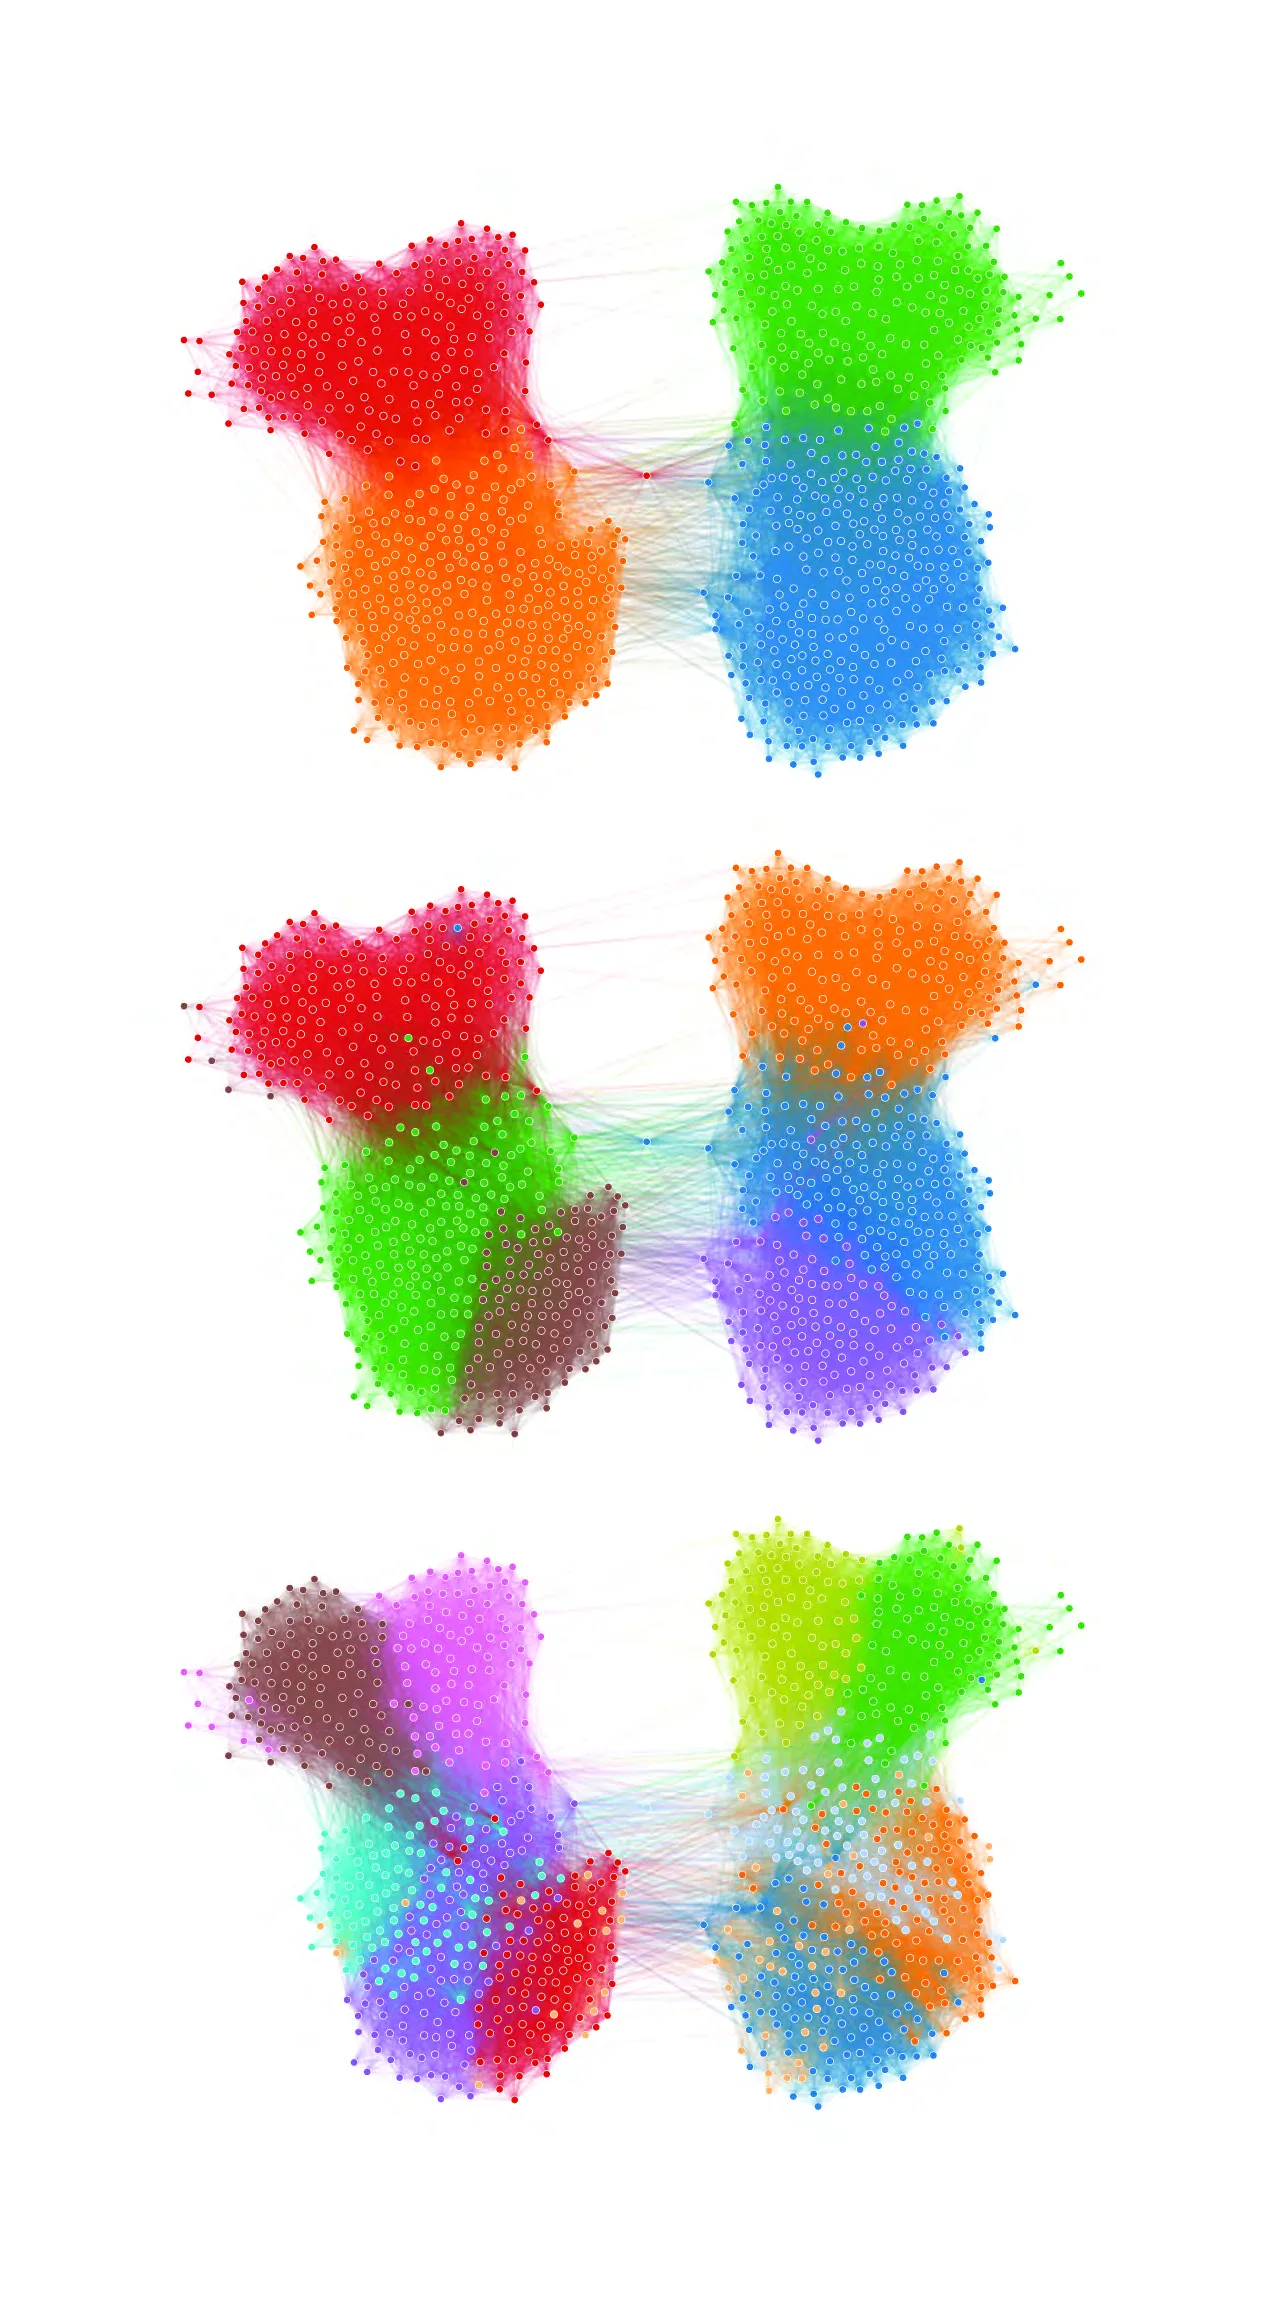
Социальная сеть похожа на город: есть районы-гиганты и крошечные переулки. Когда алгоритм ищет в ней сплочённые компании, он часто выделяет пару огромных групп и много мелких осколков. Но заказчику — например, муниципалитету — нужны районы примерно одного размера, чтобы равномерно распределить поликлиники или школы.
Обычный трюк — крутить одну ручку «разрешения», которая делает все сообщества в среднем крупнее или мельче. Это как менять фокус в бинокле: общая картина плывёт, но отдельные группы всё равно выходят кто слишком большими, кто слишком маленькими. Авторы работы пошли другим путём: они добавили в сам алгоритм сборки сети жёсткие рамки — минимальный и максимальный допустимый размер для каждого сообщества. Теперь программа не просто ищет тесные связи, но и следит, чтобы ни одна группа не вылезала за установленные границы, как пекарь, который формует булочки по одному шаблону.
Итог прост: если вам важно, чтобы группы в сети были не просто дружными, но и соразмерными, теперь есть инструмент, который умеет это делать сразу, без ручной доводки. Код уже встроен в пакет Leiden — один из самых ходовых инструментов для анализа графов.
Слово «сообщество» в анализе сетей не означает группу по интересам — это просто набор узлов, внутри которых связей больше, чем снаружи, как кучка муравьёв на одном куске сахара.