Самокоррекция ИИ — это способность систем искусственного интеллекта обнаруживать и исправлять собственные ошибки, как в процессе обучения, так и во время вывода. Эта способность критически важна для создания надежного ИИ в таких ответственных областях, как научные открытия, автономное вождение и медицинская диагностика, где ошибки могут быть дорогостоящими. Самокоррекция может происходить на нескольких уровнях: модель может уточнять свой вывод на основе обратной связи, корректировать свои внутренние параметры при поступлении новых данных или активно исследовать окружающую среду для проверки гипотез и исправления неверных представлений.
История
Концепция самокорректирующихся систем восходит к кибернетике 1940-х годов, но современная самокоррекция ИИ возникла с развитием глубокого обучения с подкреплением в 2010-х годах, особенно с появлением AlphaGo, которая научилась на основе собственных игр. Термин получил широкое распространение с появлением больших языковых моделей, которые можно попросить пересмотреть и улучшить свои собственные ответы.
Как это работает
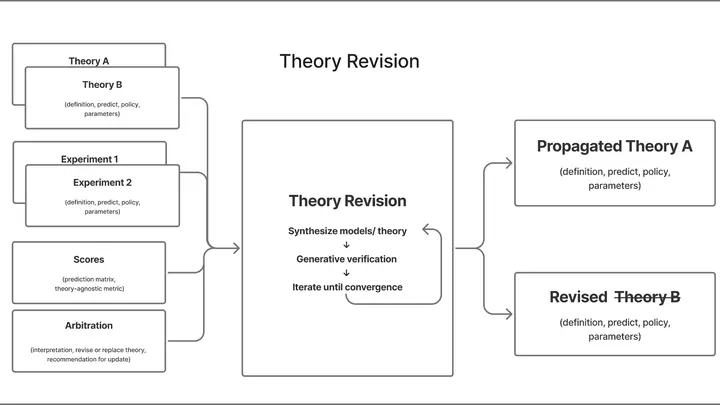
Один из распространенных механизмов — итеративное уточнение: модель генерирует первоначальный ответ, затем оценивает его по набору критериев или с помощью обученной функции вознаграждения и создает исправленную версию. Это может быть реализовано через обучение с подкреплением, где модель учится максимизировать сигнал вознаграждения, который штрафует за ошибки. Другой подход — метаобучение, когда модель обучается на распределении задач и учится быстро адаптироваться к новым задачам, распознавая и исправляя собственные ошибки. В научном ИИ самокоррекция часто включает циклыактивного обучения, где система предлагаетэксперименты, наблюдает результаты и обновляет свою внутреннюю модель мира.
Некоторые самокорректирующиеся системы ИИ могут превзойти свои собственные обучающие данные, открывая новые стратегии методом проб и ошибок, как это продемонстрировал знаменитый «ход 37» AlphaGo, который удивил даже опытных игроков-людей.
Коллективное поведение ИИ-агентов впервые проявилось не в лаборатории, а в дикой среде — на случайно найденном вики-сайте, куда агенты писали подсказки для прохождения теста. Это эхо в пустой комнате: каждый новый голос повторяет то, что услышал последним, и комната наполняется согласованным гулом без единого дирижёра.
Оркестр из сотни музыкантов играет без дирижёра. Каждый инструмент настроен идеально, но одна скрипка чуть сбилась, и гармония рассыпалась. Сложные лазерные системы в квантовых компьютерах ведут себя так же: десятки зеркал и линз должны стоять с точностью до долей миллиметра, а малейший перекос превращает чёткий луч в размытое пятно.
В девятиэтажном здании из тысячи комнат на каждом этаже кто-то шепчет, а кто-то кричит. Соседи передают слова дальше, но если все говорят слишком тихо, сообщение затухает уже на третьем этаже. Если слишком громко — к последнему этажу оно превращается в неразборчивый рёв. Между этими крайностями есть режим, когда шёпот доходит до конца без искажений.
Представьте склад с коробками яблок и груш. Яблок много, груш мало. Но когда кладовщик говорит «фрукт с гладкой кожурой», мы почему-то чаще вспоминаем редкую грушу, а не частое яблоко. Это проявление эффекта обратной базовой ставки — устойчивого когнитивного искажения, при котором мозг, разрешая неоднозначность между категориями, систематически переоценивает редкие варианты за счёт частых.
Нейросеть предсказывает будущее динамической системы — например, эволюцию плазмы в магнитном поле или изменение лица на видео. Ошибки неизбежны, и чем дальше модель заглядывает вперёд, тем больше их накапливается. Свериться с правильным ответом в момент работы невозможно: его просто не существует.
Авторы новой работы нашли простой, как всё гениальное, трюк: обучить одну модель двигаться и вперёд, и назад по времени.
Восстановить целостную картину по обрывкам — всё равно что расслышать мелодию оркестра в шумном зале. Такие задачи стоят в фотометрии — области, измеряющей поток излучения от небесных тел, где по слабому мерцанию восстанавливают яркость звезды. Традиционные методы требуют точных сведений о помехах, а они почти всегда неизвестны.
Классическая система слежения напоминает штурмана, прокладывающего курс по звёздам. Но стоит облакам закрыть небо — координаты начинают дрейфовать, а в данных нарастает энтропия — мера неопределённости. Новый алгоритм получает «второго пилота» — модуль, который непрерывно оценивает, насколько уверен основной навигатор в своих расчётах.
В спокойной воде маршрут ясен: достаточно держать курс на цель. Но в бурных, хаотичных потоках, где направление и сила течения постоянно меняются, роботу нужна принципиально иная стратегия. Обычные инженерные подходы предполагают построение точной карты течений, однако в реальности получить такую карту практически невозможно — турбулентная среда слишком сложна и изменчива.
В кастрюле с супом достаточно двух термометров, чтобы понять температуру везде — если знать, что тепло идёт кругами от дна. Так и в науке: по редким замерам нужно восстановить полную картину теплового поля.
Техногенные катастрофы, подобные Чернобыльской, редко возникают внезапно. Они вызревают годами: организации систематически игнорируют предупреждения, потому что их внутренняя сложность напоминает неумолимый рост энтропии — меры хаоса в системе, которая имеет свойство накапливаться незаметно, пока не обрушится лавиной отказов.
Традиционные слуховые аппараты напоминают повара, который готовит по рецепту вслепую. Они анализируют звуковой беспорядок с микрофона и на его основе усиливают речь. В шумном кафе такой подход часто ошибается. Новая система ведёт себя как опытный кулинар: сначала обрабатывает сигнал, а затем «пробует» результат.
Приготовление сложного блюда требует чёткого рецепта: сначала нарезать, потом обжарить, добавить специи в нужный момент. Химические превращения тоже идут по пошаговым рецептам — механизмам, где атомы углерода и водорода перестраиваются строго по очереди.
Раньше нейросети часто выдумывали несуществующие шаги, как повар-фантазёр, заменяющий соль сахаром.
Программные помощники для написания кода, или AI-ассистенты, часто действуют как повар, который ради варки одного яйца перечитывает всю кулинарную книгу. Получив задачу внести крошечное исправление, они заново открывают десятки файлов и проверяют давно известные связи.
Очистка речи от шумов напоминает настройку старого телевизора: перекрутишь ручку контрастности — и лица становятся неестественными. Исследователи применили метод, позволяющий раздельно регулировать амплитуду (громкость) и фазовый сдвиг (сдвиг по времени) для каждой частоты звука — это спектроскопия, разложение сигнала на частотные…
Представьте флот из множества кораблей, напоминающий галактику — огромную звёздную систему, где каждый элемент подчиняется общей динамике. Время от времени один из кораблей выходит из строя, взрываясь подобно сверхновой — катастрофическому событию, которое может нарушить целостность всего соединения. Если вовремя не заменить повреждённую единицу, флот теряет боеспособность.
Машинное обучение давно перестало быть просто инструментом — оно становится исследователем, самостоятельно выуживающим законы природы из данных. Но как кремниевый разум приходит к пониманию? Чтобы подсмотреть этот процесс, физики обратились к игрушечной, но глубокой модели — решётке Изинга, где спины танцуют под диктовку температуры.
Сборка светового чипа похожа на игру, где нужно провести луч через лабиринт из крошечных зеркал и светоделителей. Каждый такой элемент работает как стрелка на железной дороге: он либо пропускает свет прямо, либо направляет на соседний путь. Задача — получить на выходе строго определённый световой узор, потратив как можно меньше «стрелок».
Обычно инженеры годами ищут самый короткий маршрут для каждой задачи.
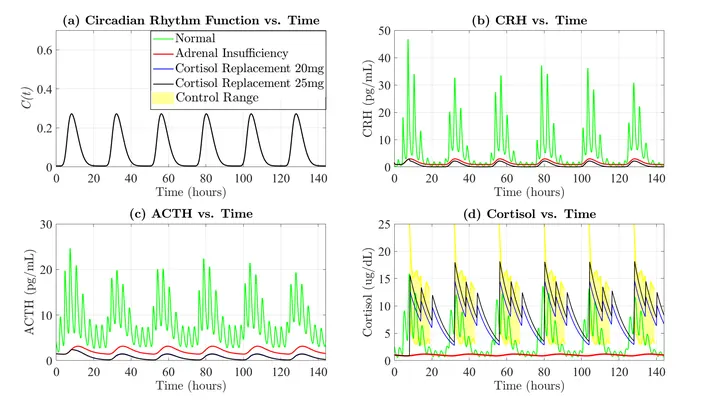
Внутри каждого из нас тикают невидимые часы. Они управляют выбросом кортизола — гормона, который помогает просыпаться по утрам, справляться с тревогой и держать иммунитет в тонусе. При надпочечниковой недостаточности эти часы ломаются: организм не может сам производить нужное количество кортизола.
На экране — результат сложнейшего моделирования: две планеты столкнулись, разлетается ударная волна. Пара кликов в редакторе — и резкие тени становятся мягче, шум сглаживается, фон темнеет. Такая цифровая ретушь (правка изображения для улучшения вида) давно вошла в арсенал учёных.
Золото не лежит на поверхности — оно спрятано в тоннах пустой породы. Чтобы добыть грамм драгоценного металла, старатели просеивают кубометры грунта. Примерно так же обучаются современные большие языковые модели: тысячи ответов-кандидатов прогоняются через дорогую модель-оценщик (оракул — модель, дающая точные оценки), чтобы выбрать один — лучший.
Замкнутый круг: машина выдвигает идею, проверяет её на людях, видит провалы и рождает новую, более точную догадку. Так работает AutoCog — автоматический когнитивный учёный. Раньше в науке о мышлении (когнитивной науке) самое сложное — придумать теорию — делали только люди. Данные собирали автоматы, модели считали компьютеры, а творческий шаг оставался за человеком. AutoCog впервые замыкает этот цикл целиком.
Танец сотен частиц: одни пары кружатся медленно и плавно, другие дёргаются в бешеном ритме. Чтобы понять суть танца, нужно следить именно за медленными движениями — они и есть главная хореография системы. В науке о молекулах такие медленные движения называют «медленными модами», и именно они определяют, как белок сворачивается в клубок или как лекарство связывается с мишенью.
Вы купили новые кухонные весы, но вместо точного веса они показывают только отклонение от какой-то «нормы». Чтобы узнать, сколько весит яблоко, приходится сначала взвесить десятки других яблок и вычислить среднее. Примерно так работают сегодняшние системы мониторинга здоровья: они неделями собирают данные о пульсе, давлении, сне, чтобы понять, что для вас обычно, а что — отклонение.
В водной среде на механическую рыбу воздействуют турбулентные вихри, сбивающие её с курса. Чтобы справиться с этой задачей, был создан ИИ-агент, действующий подобно повару-экспериментатору: он запускал множество симуляций, пробуя различные «рецепты» двигательных паттернов, и итеративно улучшал управляющую программу.
Переводчик сидит в зале совещаний и переводит каждое слово. Но вот он замечает, что его перевод можно улучшить, если он будет учиться на своих ошибках. Он начинает записывать, какие фразы вызвали непонимание, и корректирует их. Через час его перевод становится точнее, а совещание проходит быстрее.
Шеф-повар не тратит продукты, готовя всё блюдо, чтобы оценить вкус, — он пробует каплю соуса. Та же логика лежит в основе метода «информационного сопоставления» (information matching) для предсказания прочности металлов.
Лаборатория отправляет роботу список из тысячи молекул-кандидатов для нового лекарства. Робот-предсказатель, натренированный на старых данных, выдаёт для каждой оценку «подойдёт — не подойдёт». Но когда список приходит из незнакомой области — другого вируса или редкой опухоли — робот начинает путаться. Его уверенность остаётся высокой, а реальные попадания падают до нуля.
Фотокатализатор — это порошок, который, попав в воду на свету, разлагает её на пузырьки водорода и кислорода. Самый популярный материал для этого — диоксид титана, белый пигмент из красок и зубной пасты. Но чистый кристалл работает вяло: он поглощает только ультрафиолет, а таких лучей в солнечном спектре мало.
Каждое утро вы берёте в руки одну и ту же кружку, но кофе кажется то горьким, то в самый раз. Дело не в кофе — и не в вашем характере. Внутри нас постоянно сдвигается невидимый пульт с десятками ползунков: усталость, голод, тревога, уровень гормонов. В разное время дня они стоят в разных положениях, и один и тот же сигнал из внешнего мира даёт на выходе совсем другой результат.
Человек смотрит на дверной замок и видит щель для ключа. Он знает, что ключ вставляют и поворачивают. Но если вместо скважины — сенсорная панель, привычная рамка ломается. Человек не просто ошибается: он понимает, что привычный способ не годится, и может сказать: «Здесь нет места для ключа, нужен другой подход».
Такая честная остановка с объяснением — редкость для машин.
Социальная сеть похожа на город: есть районы-гиганты и крошечные переулки. Когда алгоритм ищет в ней сплочённые компании, он часто выделяет пару огромных групп и много мелких осколков. Но заказчику — например, муниципалитету — нужны районы примерно одного размера, чтобы равномерно распределить поликлиники или школы.
Камера делает снимок, но матрица шумит, оптика размывает, а часть пикселей засвечена. Восстановить исходную картинку — всё равно что угадать мелодию по испорченной пластинке: вариантов много, и какой из них правдив, неясно. В науке такие задачи называют обратными, и они повсюду — от медицинских томографов до радиотелескопов.
Ядро урана напоминает тугой кошелёк, защёлкнутый на две половинки. Чтобы он лопнул и высвободил энергию — то есть чтобы ядро разделилось, — нужно перевалить через энергетический барьер. Высота этого порога определяет, стабильно вещество или готово распасться в любой момент.
В лаборатории, где изучают кристаллы, лаборант смотрит на экран с россыпью светлых пятен и медленно поворачивает образец, добиваясь, чтобы пятна сложились в симметричный узор. Эта работа похожа на настройку старого радиоприёмника: крутишь ручку, пока шум не сменится чистым сигналом. Теперь эту ручку может крутить машина.
Переводчик, который никогда не был на совещании, переводит дословно — и теряет половину смысла. Он не знает, что кивок начальника означает «сделайте как в прошлый раз», а фраза «ну, посмотрим» — вежливый отказ. Так и языковая модель, которая пишет код по научной статье: уравнения она прочитает, а вот негласные договорённости — нет.
Разработка нового материала — например, прочного сплава — это марафон из тысяч компьютерных симуляций. Традиционно учёный вручную задаёт параметры каждого расчёта, отслеживает сбои и интерпретирует результаты.
Физик, который анализирует столкновения частиц, обычно тратит недели на скучную работу: вычистить шум из данных, прикинуть, сколько ложных сигналов проскочит, перепроверить каждую цифру. Теперь эту рутину можно отдать программе.
Кухонный нож и овощечистка по отдельности справляются с разными задачами, но когда повар учится новому рецепту, он часто хватается за один и тот же нож для всего. Похоже, так же поступает мозг, когда осваивает новый навык различения образов.
В эксперименте обезьяны неделями тренировались различать едва заметные отличия в сложных узорах.
Программист пишет код, запускает, видит ошибку и правит. Теперь этот процесс можно поручить самой программе. Машинное обучение уже умеет улучшать алгоритмы, но обычно требует много данных и готовых примеров.