Кластеризация методом k-средних — это алгоритм обучения без учителя, который разбивает набор данных на заданное число кластеров, каждый из которых представлен своим центроидом (средним значением своих точек). Цель — минимизировать внутрикластерную дисперсию, делая точки в одном кластере максимально похожими, а разные кластеры — различимыми. Это один из самых простых и широко используемых методов кластеризации, часто служащий базовым для более сложных подходов.
История
Термин «k-средних» впервые использовал Джеймс МакКуин в 1967 году, хотя основная идея восходит к Гуго Штейнгаузу (1956) и алгоритму Ллойда (1957) для импульсно-кодовой модуляции.
Как это работает
Алгоритм начинается со случайной инициализации k центроидов. Затем он итеративно выполняет два шага: (1) назначает каждую точку данных ближайшему центроиду и (2) пересчитывает каждый центроид как среднее всех точек, назначенных ему. Эти шаги повторяются, пока центроиды не перестанут существенно меняться. Результат зависит от начального размещения, поэтому обычно алгоритм запускают несколько раз с разными начальными значениями и выбирают лучший результат. Число кластеров k должно быть выбрано заранее, часто с помощью метода локтя или анализа силуэтов.
Где применяется
Метод k-средних используется для сегментации клиентов в маркетинге, сжатия изображений за счет уменьшения цветовой палитры и обнаружения аномалий путем выявления точек, далеких от любого центроида.
Любопытный факт
Метод k-средних настолько эффективен, что может кластеризовать миллионы точек за секунды, но он предполагает, что кластеры сферические и примерно одинакового размера, что редко встречается в реальных данных.
Два резервуара чернил стоят по разные стороны клеточного стыка. Из них на мембрану вытекают два типа мономеров, которые, встретившись, образуют вязкие капли комплексов. Капли почти не двигаются, а вот свободные мономеры шныряют быстро, как молекулы духов в комнате.
Переводчик в зале, где одновременно говорят на трёх языках, сначала слышит лишь общий шум. Но если он начнёт переспрашивать, вслушиваться в интонации и раз за разом уточнять, кто какой фразой ответил, постепенно из какофонии проступят отдельные голоса.
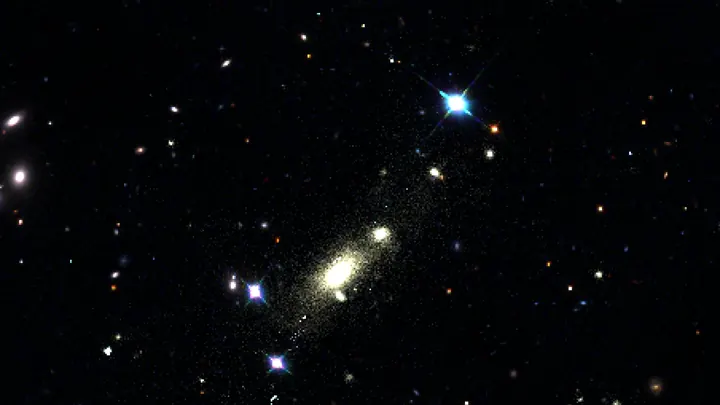
Галактика NGC 4254 удалена от центра скопления Девы на полтора миллиона световых лет. Она тащит за собой длинный шлейф остывающего водорода — признак того, что на полном ходу врезается в раскаленный газ. Потеря холодного топлива гасит рождение новых звезд.
Температура в центре скопления галактик достигает ста миллионов градусов. Эти крупнейшие гравитационно связанные системы — естественные лаборатории, где природа прячет 85% своей массы в невидимой тёмной материи.
Обычно сложность систем — от движения спутников до сердечных ритмов — оценивают усреднённой энтропией (мерой непредсказуемости, как её понимал Больцман). Но это похоже на оценку океана только по высоте волн: средняя цифра скрывает всё богатство подводных течений.
Метод CWMMSE ныряет глубже.
Обычные алгоритмы компьютерного зрения воспринимают медицинские изображения как набор несвязанных фрагментов — любые два несовпадающих снимка для них абсолютно различны. Это напоминает попытку отличить близнецов, не зная об их родстве. В медицине же пациенты с одним заболеванием часто выглядят на МРТ почти идентично, и алгоритм ошибается, путая «родственные» случаи.
Мозг общается короткими электрическими разрядами — потенциалами действия. Прежде расшифровка этого языка требовала тысяч размеченных примеров: экспериментатор сопоставлял сигнал с конкретным движением или словом. Метод MOJO предлагает иной подход — подобно изучению языка через погружение, он сначала вслушивается в «поток сознания» без всяких подсказок и самостоятельно выявляет повторяющиеся паттерны.
Ребёнок, осваивая незнакомую квартиру, ползает от предмета к предмету и запоминает, что видно из каждого угла. Так мозг строит мысленную карту — внутреннюю модель пространства. Алгоритм gradCSCG действует по тому же принципу: он получает видеопоток с камеры и самостоятельно рисует схему помещения, опираясь лишь на смену картинок.
Долгое время идентификация квантовых фаз напоминала допрос свидетеля: нужно было добраться до каждого уголка системы, чтобы выведать её тайну. В эпоху Ландау порядок связывали с нарушением симметрии и локальным параметром — всё как на ладони.
Гравитационное микролинзирование — удивительный космический эффект, предсказанный Эйнштейном и развитый Цвикки. Массивное тело, проходя между нами и далёкой звездой, искривляет её свет подобно линзе, создавая характерные усиления и искажения.
Многие передовые расчёты в физике упираются в каменную стену — их тормозит не недостаток идей, а арифметика. Речь об интегралах, которые выражают вероятность столкновения частиц или форму всплеска гравитационных волн. Чтобы получить число, эти интегралы нужно упростить — свести к горстке «мастер-интегралов», похожих на таблицу умножения.
Социальная сеть похожа на город: есть районы-гиганты и крошечные переулки. Когда алгоритм ищет в ней сплочённые компании, он часто выделяет пару огромных групп и много мелких осколков. Но заказчику — например, муниципалитету — нужны районы примерно одного размера, чтобы равномерно распределить поликлиники или школы.
Три человека сидят в трёх углах комнаты. Каждый получает по запечатанному конверту от невидимого курьера — но курьеры не сговариваются и никогда не встречались. Люди вскрывают конверты и видят записку с одним словом: «да» или «нет». Сами они ничего не выбирают — просто читают. Тысячи раундов спустя выясняется: сочетания ответов подчиняются такой статистике, которую невозможно получить без тайного сговора курьеров.
Если показать одну и ту же фотографию кота двум разным нейросетям, они часто приходят к похожему выводу: «кот». Но если спросить их подробнее, ответы могут разойтись. Одна модель обратит внимание на усы, другая — на окрас, третья — на позу. Получается, что даже внутри «зрительного» мира нейросетей нет полного единства.
Учёные придумали способ измерить это единство для каждой картинки отдельно.
Два почти одинаковых замка́ вскрывает одна и та же отмычка. Внешне они похожи, но внутри механизм разный. Примерно так же выглядят два главных типа немелкоклеточного рака лёгкого — аденокарцинома и плоскоклеточный рак. Под микроскопом их можно спутать, а лечение требуется разное. Тут-то и приходит на помощь квантовая «лупа».
В ускорителе частиц ядра разбиваются на осколки, как фарфоровая чашка при падении. Каждый осколок пролетает через кремниевые пластины — они регистрируют удар и его силу. Но чтобы отличить настоящий сигнал от случайного шума, нужно выставить порог: ниже него показания считаются помехой.
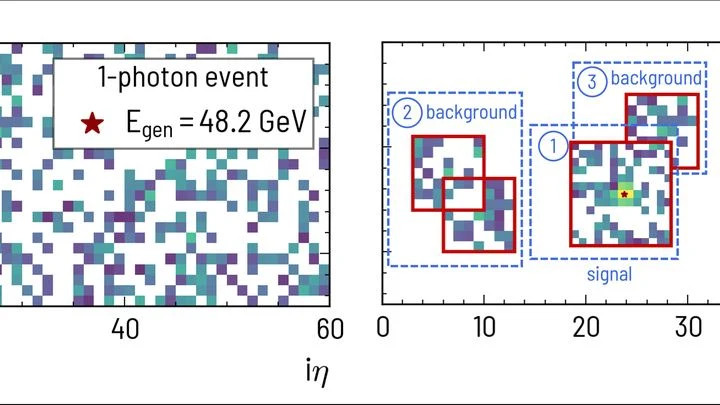
В детекторе Большого адронного коллайдера каждую секунду рождаются миллионы частиц. Их вспышки энергии в калориметре похожи на капли дождя на оконном стекле: отдельные капли видны, но когда их много и они сливаются, разглядеть каждую уже сложно. А физикам нужно знать точно, сколько энергии принесла каждая частица и куда она попала.
Снимки далёких галактик пестрят изогнутыми дугами и пятнами — это свет, искорёженный по пути к нам. Эффект, предсказанный Альбертом Эйнштейном в рамках общей теории относительности, работает как гигантское кривое зеркало: массивное скопление галактик своей гравитацией искажает изображения фоновых источников — явление, называемое…
Светящиеся точки на тёмном фоне — так выглядят снимки одиночных молекул, сделанные методом MINFLUX. Этот микроскоп умеет показывать детали размером меньше пяти нанометров: примерно в десять тысяч раз тоньше человеческого волоса. Но картинка получается не готовая, а как россыпь огоньков на новогодней гирлянде, где часть лампочек перегорела, а провода спутаны.
Квантовый компьютер плетёт из кубитов подобие нити, где каждый узел — частица, а связь между ними — переплетение. Когда физик измеряет кубит, нить меняется: где-то рвётся, где-то сшивается, а иногда на ней появляется закрутка. Авторы новой работы нашли точные правила этих превращений для самой простой цепочки — линейной, где кубиты выстроены в ряд.
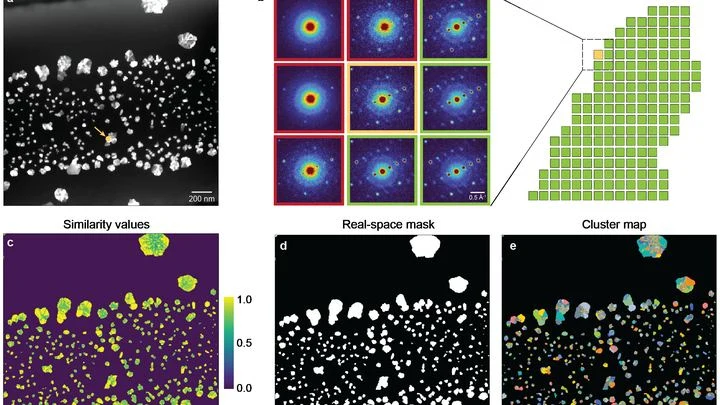
Электронный микроскоп сканирует образец и в каждой точке записывает, как электроны рассеиваются на атомах. Получается гигантская стопка снимков — по одному на каждую точку. В них зашифрована информация о том, как уложены атомы: ровными рядами или с перекосом, куда повёрнута кристаллическая решётка, есть ли внутренние напряжения.
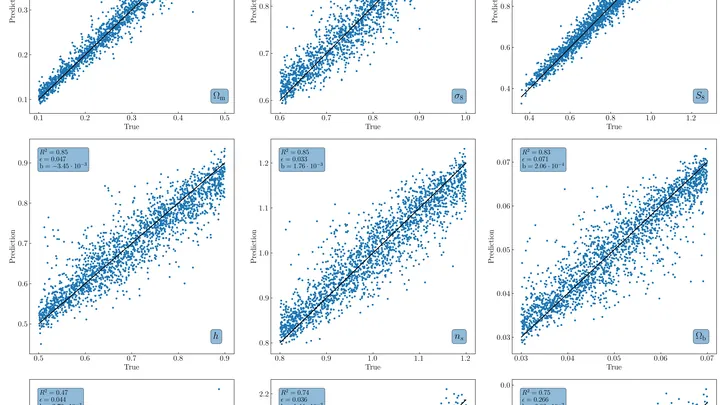
Тысячи вселенных родились в компьютере, чтобы однажды рассказать о нашей. Каждая — со своими скоплениями галактик, расставленными по законам гравитации, как горошины в банке, которую встряхнули с разной силой. По тому, как легли горошины, можно понять, что за рука трясла банку.
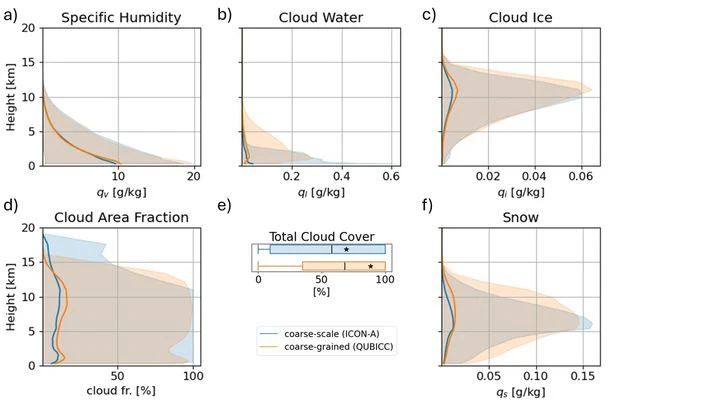
Прогноз климата напоминает сложный кулинарный рецепт: одна неверная щепотка — и всё блюдо испорчено. Так и с облаками — малыми, но решающими ингредиентами. Традиционные климатические модели разбивают атмосферу на ячейки размером 50–100 км и не различают отдельные облака. Это всё равно что сыпать перец горстями, когда рецепт требует аккуратную щепотку.
Оптик крутит оправу, ловит фокус, и размытое пятно становится чёткой картинкой. Примерно так же работает новый алгоритм GOAL: он поворачивает облако данных, сжимает лишние измерения и наводит резкость на то, что действительно важно.
Когда признаков больше, чем наблюдений, стандартные методы напоминают попытку разглядеть лицо через запотевшее стекло: шум забивает сигнал. GOAL действует иначе.
Представьте себе пограничную реку, которая разделяет две страны. На одном берегу живут одни люди, на другом — другие. Граница между ними не всегда очевидна: где-то река широкая и спокойная, а где-то узкая и бурная. Но именно в тех местах, где течение резко меняется, граница становится особенно заметной.