Космос натренировали предсказывать экспресс
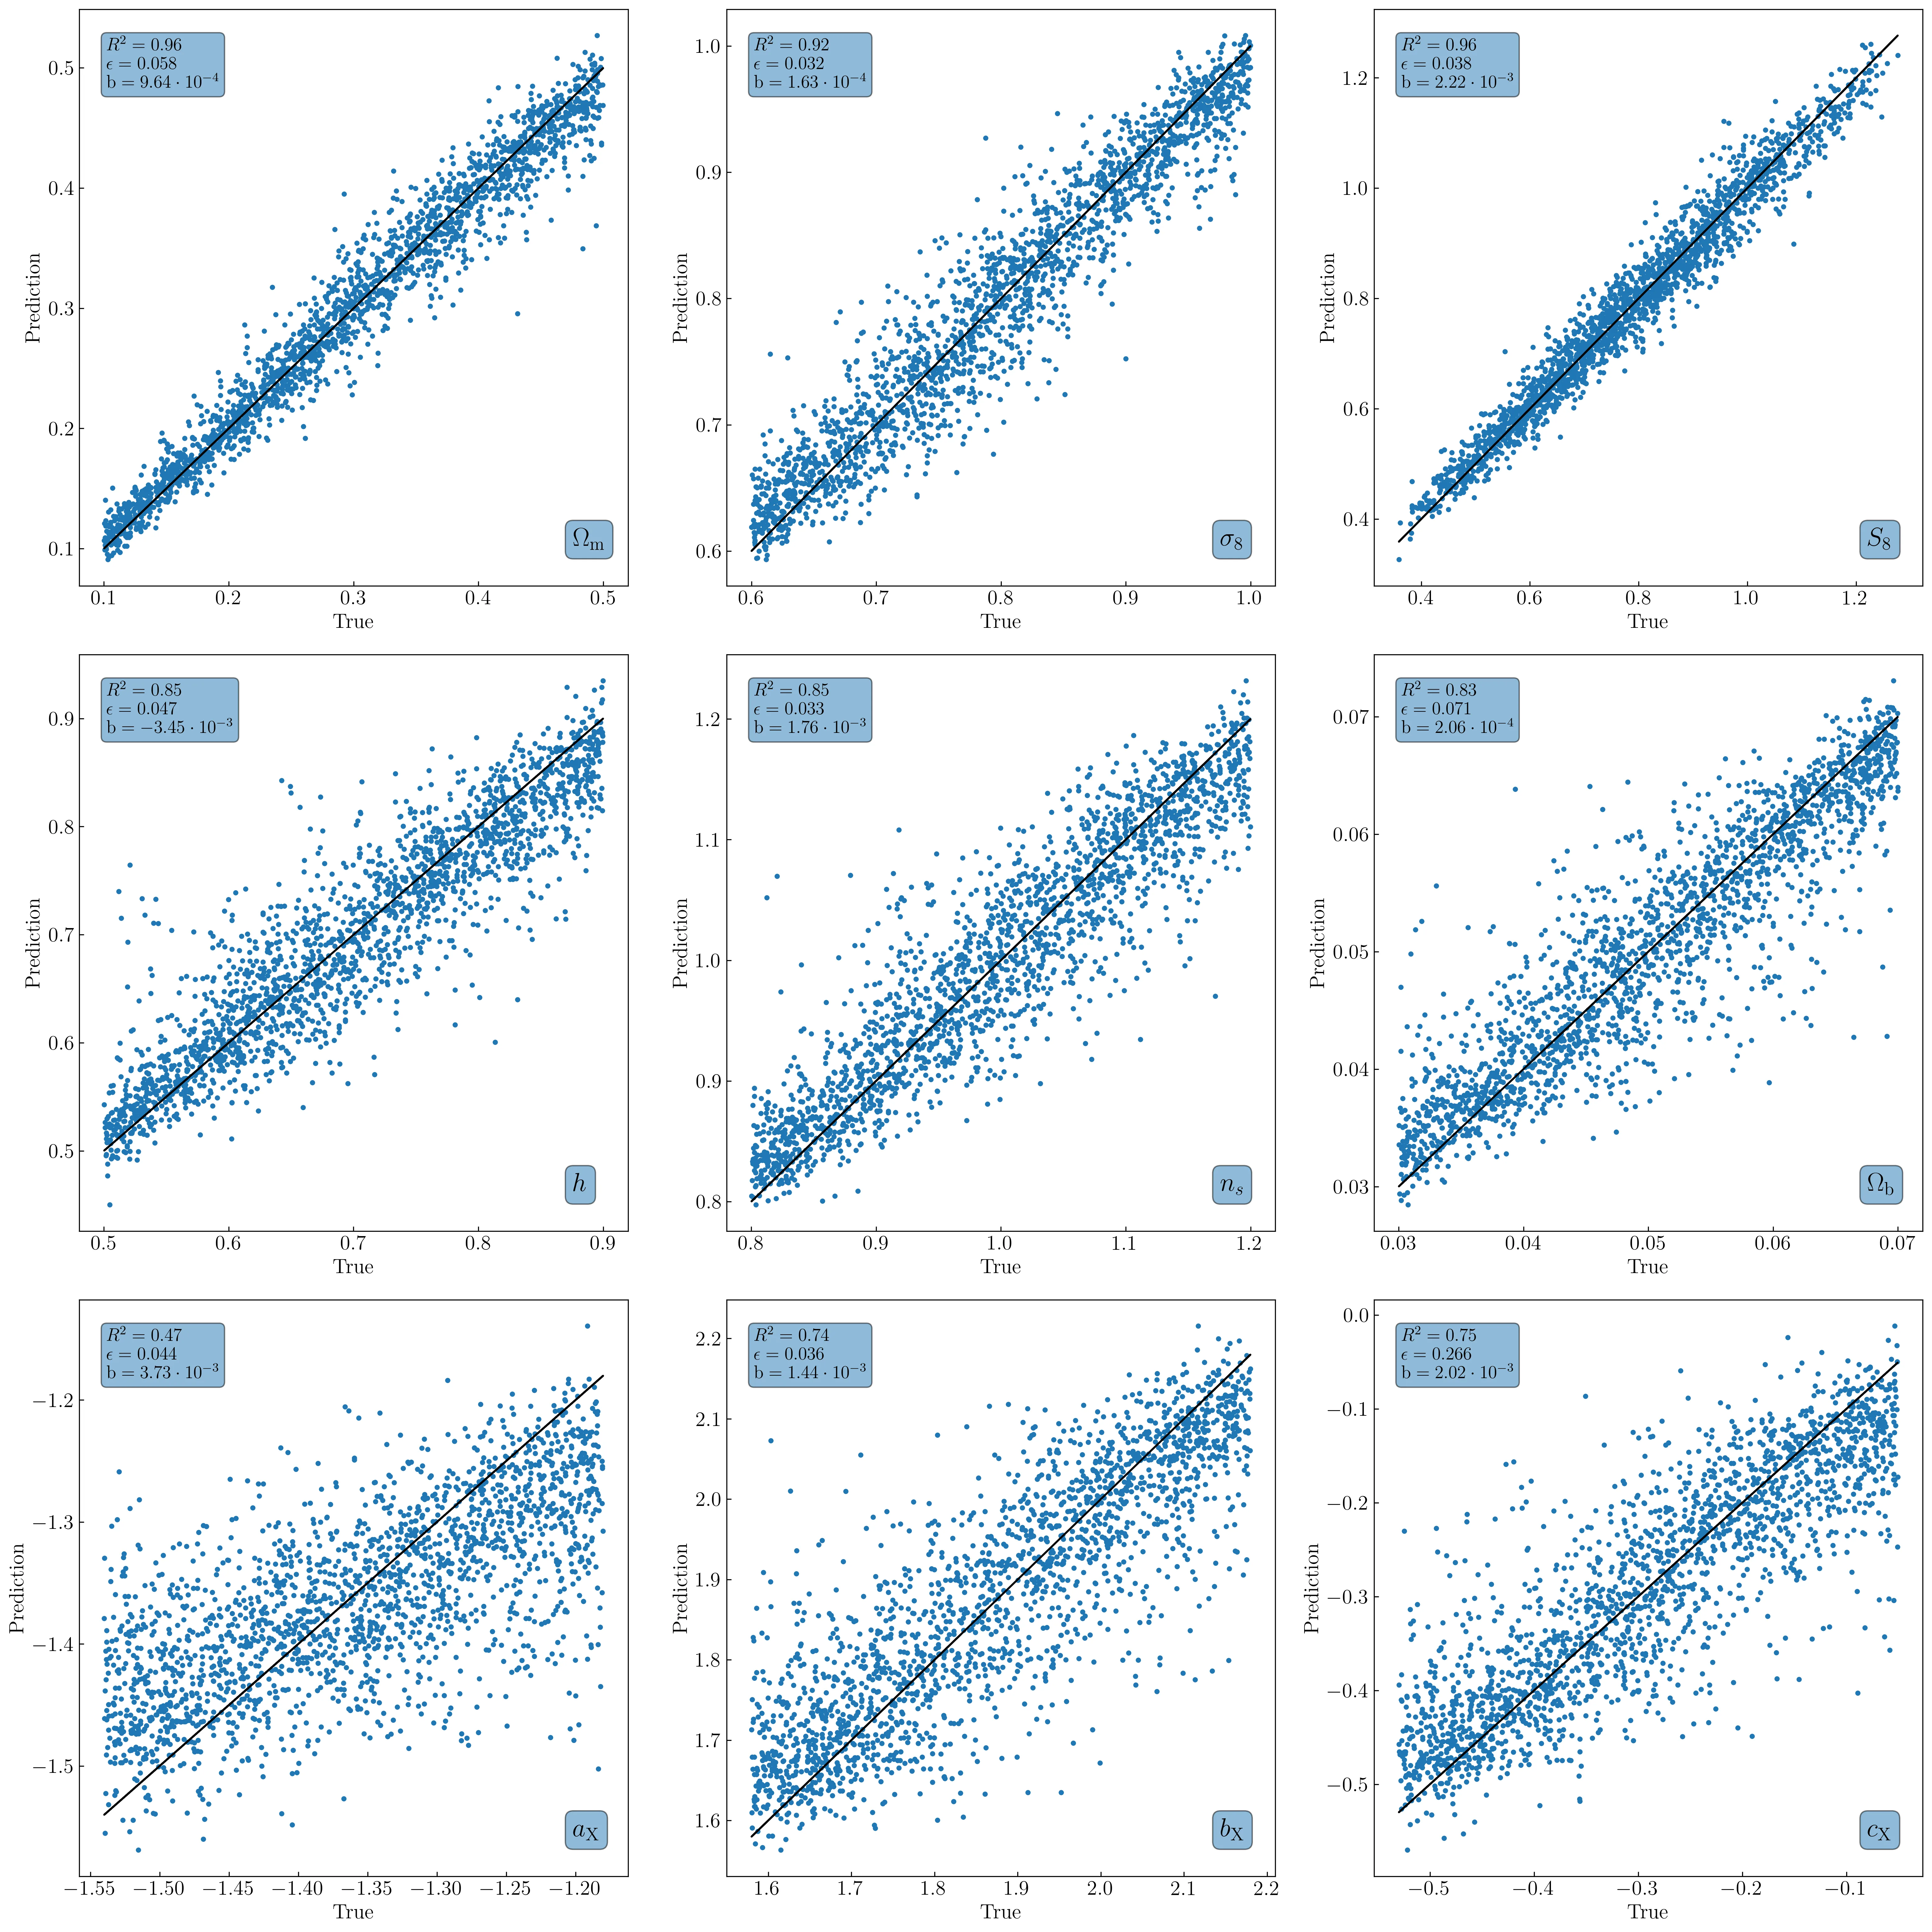
Тысячи вселенных родились в компьютере, чтобы однажды рассказать о нашей. Каждая — со своими скоплениями галактик, расставленными по законам гравитации, как горошины в банке, которую встряхнули с разной силой. По тому, как легли горошины, можно понять, что за рука трясла банку. Так и здесь: по узору из скоплений учёные хотят определить, сколько во Вселенной тёмной материи и как быстро она собиралась в комки.
Раньше из этих узоров доставали лишь пару чисел — сколько скоплений всего и насколько они любят держаться на определённых расстояниях. Это как судить о картине по среднему цвету и количеству мазков. Теперь же нейросеть смотрит на всю картину целиком: трёхмерную карту, где каждая точка — скопление галактик. И учится на тридцати двух тысячах таких картин, сгенерированных по разным сценариям.
Результат обнадёживает: новый подход ошибается в оценке плотности материи на десять процентов меньше старого, а в оценке комковатости — на двадцать. Если же нейросети дополнительно сообщают яркость каждого скопления, точность вырастает ещё вдвое. Яркость здесь — как размер горошины: она тоже зависит от того, сколько вокруг тёмной материи.
Так компьютерные вселенные становятся учебником для чтения нашей собственной. Чем лучше учебник, тем точнее мы узнаем, из чего сделан космос и куда он движется.
Оригинальная аннотация
как её написали авторы, на английском arXiv:2601.03894
The possibility to constrain cosmological parameters from galaxy surveys using field-level machine learning methods that bypass traditional summary statistics analyses, depends crucially on our ability to generate simulated training sets. The latter need to be both realistic, as to reproduce the key features of the real data, and produced in large numbers, as to allow us to refine the precision of the training process. The analysis presented in this paper is an attempt to respond to these needs by (a) using clusters of galaxies as tracers of large-scale structure, together with (b) adopting a 3LPT code (Pinocchio) to generate a large training set of $$32\,768$$ mock X-ray cluster catalogues. X-ray luminosities are stochastically assigned to dark matter haloes using an empirical $$M-L_X$$ scaling relation. Using this training set, we test the ability and performances of a 3D convolutional neural network (CNN) to predict the cosmological parameters, based on an input overdensity field derived from the cluster distribution. We perform a comparison with a neural network trained on traditional summary statistics, that is, the abundance of clusters and their power spectrum. Our results show that the field-level analysis combined with the cluster abundance yields a mean absolute relative error on the predicted values of $$\Omega_{\rm m}$$ and $$\sigma_8$$ that is a factor of $$\sim 10 \%$$ and $$\sim 20\%$$ better than that obtained from the summary statistics. Furthermore, when information about the individual luminosity of each cluster is passed to the CNN, the gain in precision exceeds $$50\%$$.
В обучающей выборке было 32 768 виртуальных вселенных — это ровно 2 в 15-й степени, компьютерное «круглое» число.