Обобщение — это способность модели, будь то нейронная сеть или биологический мозг, хорошо работать на новых, ранее не встречавшихся данных, а не просто запоминать примеры, на которых она обучалась. Это основная цель любой обучающейся системы: модель, которая работает только на своей обучающей выборке, не по-настоящему выучила лежащую в основе закономерность, а вместо этого переобучилась на шум или специфические особенности данных. В физике и машинном обучении обобщение позволяет сети, обученной на ограниченном наборе измерений, предсказывать результаты для совершенно новых условий, например, восстанавливать распределение тёмной материи по гравитационному линзированию или предсказывать поведение квантовых состояний света.
История
Концепция была формализована в 1960-х и 1970-х годах в рамках статистической теории обучения, в частности Владимиром Вапником и Алексеем Червоненкисом, которые ввели размерность Вапника — Червоненкиса (VC-размерность) для количественной оценки способности модели к обобщению.
Как это работает
Обобщение возникает, когда модель улавливает основные закономерности данных, а не их поверхностные детали. Это достигается с помощью таких методов, как регуляризация, кросс-валидация и обучение на разнообразных наборах данных, которые вынуждают модель находить компактные и многократно используемые представления. В мозге обобщение, как считается, опирается на формирование абстрактных карт или схем, которые можно гибко применять к новым ситуациям, как показывают исследования того, как мозг переносит прошлый опыт на новые контексты. Ключевой момент — модель должна выучивать признаки, которые действительно предсказательны для широкого диапазона входных данных, а не только те, что случайно подходят к обучающим примерам.
Где применяется
Обобщение делает нейронные сети полезными в физике — от предсказания карт гравитационного линзирования до классификации квантовых состояний света, а также в медицине, где модели, обученные на неполных данных, должны давать точные прогнозы для новых пациентов.
Любопытный факт
Модель, которая идеально запоминает свои обучающие данные, почти всегда будет работать хуже на новых данных, чем более простая модель, допускающая некоторые ошибки на обучающей выборке, — это явление известно как компромисс между смещением и дисперсией.
Представьте интерферометр как гигантское ухо, слушающее радиошёпот далёкой галактики. Три антенны, расставленные по континентам, ловят сигнал, и разность их фаз складывается в величину, не зависящую от дрожания атмосферы. Эту величину называют фазой замыкания. Раньше её читали примитивно: ноль — источник симметричен, не ноль — асимметричен.
Белковый инженер похож на повара, который пытается сделать блюдо одновременно вкусным, полезным и дешёвым. Изменяя один ингредиент, он рискует испортить другой. Раньше компьютерные помощники умели оценивать свойства белков только по отдельности, не видя, как они связаны между собой.
Переводчик отвлекается на каждый шорох в зале — и час совещания превращается в два. Так и молекулярные фундаментальные модели: они выучивают язык молекул на гигантских корпусах, но для каждого нового разговора требуют настройки. Monroe меняет правила: она не учит новый язык, а мгновенно находит общий смысл по нескольким примерам.
Прогноз выхода химической реакции — это попытка предсказать урожай, зная лишь состав почвы. Долгое время химики опирались на длинные колонки чисел, так называемые квантовые дескрипторы, которые описывают энергию электронов, но умалчивают о форме молекулы.
Четыре слабых штриха на снимке — всё, что видит астроном. Так скульптор по четырём теням восстанавливает форму невидимого стекла. Около ста лет назад Альберт Эйнштейн предсказал, а Фриц Цвикки предложил использовать гравитационные линзы — естественные телескопы из тёмной материи, усиливающие свет далёких…
В 2019 году на установке LIGO зафиксировали гравитационную волну — рябь в ткани пространства-времени, — чья частотно-временная карта напоминала причудливый гребень. Каждый такой сигнал от слияния чёрных дыр оставляет уникальный узор, похожий на отпечатки пальцев.
Радиосигналы в замкнутом пространстве ведут себя подобно акустическим волнам в концертном зале: многократно отражаясь от стен, мебели и других поверхностей, они формируют уникальную интерференционную картину — своего рода безмолвную «мелодию» каждого места. Смартфон, оснащённый приёмником, подобно чуткому уху, регистрирует эту картину через анализ помех и искажений сигнала.
Мозг общается короткими электрическими разрядами — потенциалами действия. Прежде расшифровка этого языка требовала тысяч размеченных примеров: экспериментатор сопоставлял сигнал с конкретным движением или словом. Метод MOJO предлагает иной подход — подобно изучению языка через погружение, он сначала вслушивается в «поток сознания» без всяких подсказок и самостоятельно выявляет повторяющиеся паттерны.
Данные о работе генов обычно выглядят как длинная строка чисел, напоминающая радужную полоску (спектр) без видимых связей. В модели scVision эти числа преобразуют в осмысленное изображение — не список ингредиентов, а фото готового блюда.
Нейтронные звёзды — последние сгустки видимой материи перед падением в чёрную дыру. В их недрах материя сжата до триллионных плотностей. Здесь ядерные силы и гравитация сплетаются в экзотическую субстанцию, недоступную никакому земному ускорителю.
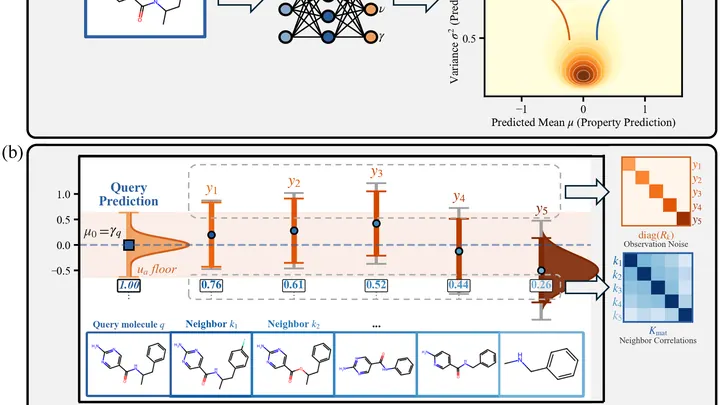
Предсказать свойства новой молекулы — сродни попытке угадать вкус незнакомого блюда. Программа работает как опытный повар: она «пробует» похожие молекулы, чьи свойства уже известны, и на основе их «вкуса» уточняет свою догадку. Например, для воды или углекислого газа алгоритм находит изученные аналоги и корректирует температуру кипения или растворимость.
Крупная нейросеть, такая как Whisper, владеющая сотнями языков, напоминает стандартную модель физики элементарных частиц — стройную систему, где всё находится в тонком равновесии.
Машинное обучение давно перестало быть просто инструментом — оно становится исследователем, самостоятельно выуживающим законы природы из данных. Но как кремниевый разум приходит к пониманию? Чтобы подсмотреть этот процесс, физики обратились к игрушечной, но глубокой модели — решётке Изинга, где спины танцуют под диктовку температуры.
Снежинка растёт, нефтяное пятно растекается, толпа движется — уравнения для каждого случая свои. Но финал часто один и тот же: форма, скорость, узор подчиняются простой, повторяющей себя на разных масштабах схеме. Это и есть универсальность — когда за деталями прячется общий закон.
Гравитационные сигналы от умирающих массивных звёзд — это шёпот, долетающий до нас из самых жестоких лабораторий Вселенной. Эйнштейн предсказал эти гравитационные волны более века назад, но лишь сегодня, с детекторами вроде LIGO, мы начинаем их слышать.
Классический нейрон — камерный музыкант, извлекающий лишь одну ноту из каждой струны: он берёт взвешенную сумму входов, добавляет смещение и пропускает через нелинейность. Но стоит провести каноническое квантование — процедуру, рождённую гением Поля Дирака для создания квантовой механики, — и солист превращается в филармонию.
С тех пор как Эйнштейн предсказал гравитационное линзирование, а гравитационные волны были впервые услышаны детекторами LIGO, физики мечтали поймать линзированное эхо — повторяющийся сигнал одного слияния, размноженный гравитацией массивного тела.
Спустя почти век после того, как Фриц Цвикки заподозрил неладное в движении галактик скопления Волос Вероники, а Вера Рубин измерила звёздные скорости в спиральных рукавах, природа тёмной материи остаётся одной из самых мучительных загадок.
60 мышей, 1980 образцов, 234 пациента с раком лёгкого. За каждым числом — тысячи генов. Их активность измеряют, чтобы понять болезнь. Но данные не однородны: у одного больного оценивают уровень белка (непрерывное число), ставят диагноз (да/нет) и определяют подтип опухоли (категория). Смешать их в одной модели — как сложить градусы Цельсия и километры.
Когда-то Ричард Фейнман увидел в квантовых системах вызов для классических компьютеров. Теперь мы стоим перед обратной задачей: понять, что именно смоделировал квантовый процессор. Среди рождённых им состояний есть настоящие «чёрные ящики» — топологические фазы материи.
Обычные нейросети учатся на примерах, как человек, заучивающий мелодии на слух: они накапливают статистические закономерности, но не понимают глубинных правил. Иной подход — физически-информированные нейронные сети, в архитектуру которых изначально встроены фундаментальные законы физики, такие как уравнения сохранения энергии или уравнения движения.
Иммунная система напоминает неутомимого редактора, который правит черновик антител, делая их всё более цепкими к вирусам и бактериям. Этот процесс называется созреванием антител: в генах возникают случайные опечатки (мутации), а естественный отбор сохраняет те, что улучшают захват цели.
Рентгеновские детекторы устроены подобно пчелиным сотам: в шестиугольных ячейках то здесь, то там регистрируются вспышки — следы попадания отдельных фотонов. Традиционные алгоритмы вынуждены растягивать эту естественную гексагональную структуру на прямоугольную сетку, что порождает артефакты — ложные призраки поляризации, искажающие реальную картину.
Горсть песка падает на стол — и каждая песчинка скатывается вниз, пока не замрёт в углублении. Так работает потенциал: поверхность стола подсказывает частицам, куда двигаться. Но в реке с водоворотами нет одной-единственной впадины, куда всё стремится. Вода кружится, возвращается, петляет. Для таких систем обычная карта «ям и холмов» не годится.
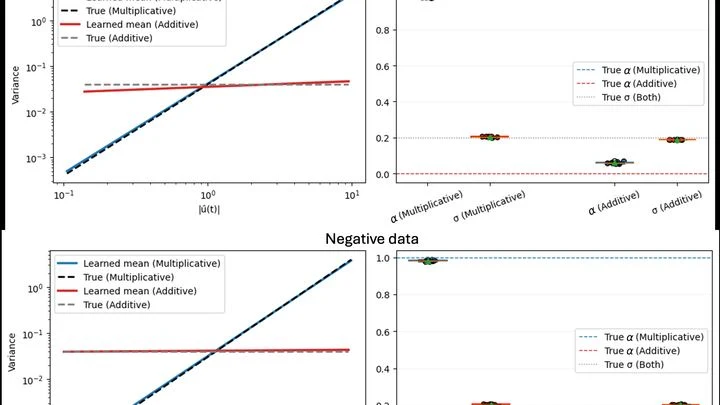
Рост популяции со стороны похож на разгоняющийся поезд: сначала еле ползёт, потом набирает ход. Но стоит вглядеться в данные — и картинка расплывается. В одном замере десяток особей, в другом сразу сотня. Классические модели смахивают этот разброс как досадную грязь с объектива. Они считают, что шум везде одинаковый, и просто не обращают на него внимания.
Кассир в супермаркете в час пик не запоминает каждую пробитую покупку — он держит в голове общую сумму и следит за очередью. Примерно так же мозг распределяет свои силы: дорогая и точная кора (то, что отвечает за обдумывание) и более простые, экономные подкорковые ядра (где живут привычки) работают в паре.
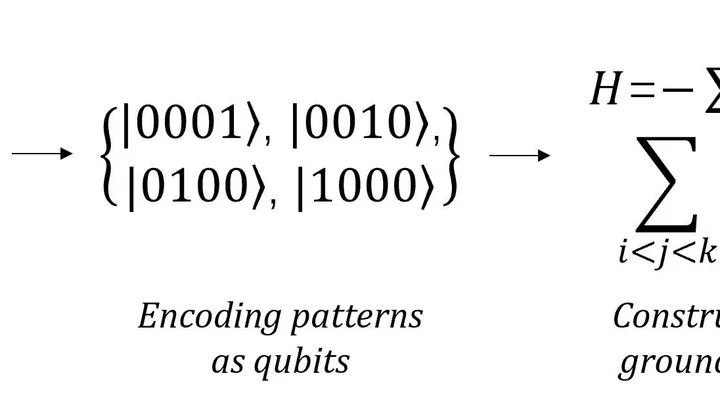
Классические нейросети требуют тысяч примеров, часов обучения и гигаватты энергии. Физики предложили квантовый обходной путь, опирающийся на фундаментальные принципы. Ещё Макс Планк установил дискретность энергии — её квантование, и сегодня это позволяет генерировать образы без этапа обучения.
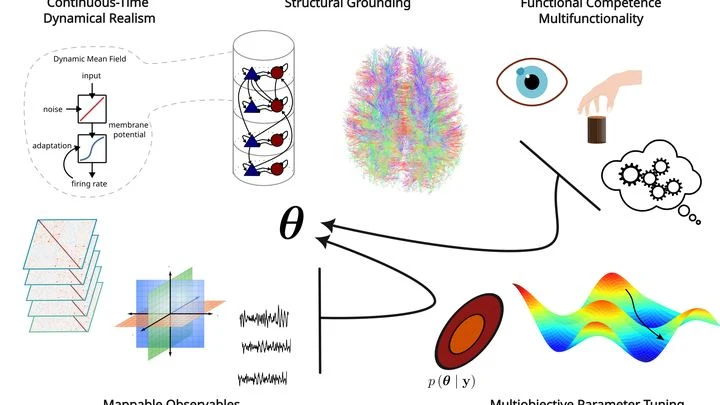
Инженеры строят автомобиль. Одни собирают точную копию двигателя, каждый поршень и свечу, но машина не едет — нет руля и колёс. Другие создают быстрый самоуправляемый карт, однако его мотор из пластилина не похож на настоящий. Примерно так же обстоят дела в науке о мозге.
На вечеринке гости не просто болтают парами, а собираются в кружки по интересам: трое обсуждают кино, четверо — спорт. Обычная схема знакомств, как список контактов в телефоне, такое не ухватит — она видит только связи «один на один». А ведь жизнь состоит из групповых взаимодействий: нейроны в мозгу срабатывают ансамблями, виды в экосистеме влияют друг на друга целыми сообществами.
Симфония звучит, но в партитуру вкралась едва заметная фальшивая нота. Примерно так физики ищут отклонения от общей теории относительности в «звуках» Вселенной — гравитационных волнах от слияния чёрных дыр. Эти волны, словно круги на воде от брошенного камня, расходятся по ткани пространства-времени и доходят до детекторов на Земле.
Каждый атом углерода в молекуле носит при себе паспорт — энергию, с которой его самые глубокие электроны сидят на своих орбитах. Эта энергия чутко отзывается на соседей: появился рядом кислород или двойная связь — и цифра в паспорте меняется. Химики давно измеряют такие энергии с помощью рентгена, но расчёт для каждой новой молекулы отнимает часы машинного времени.
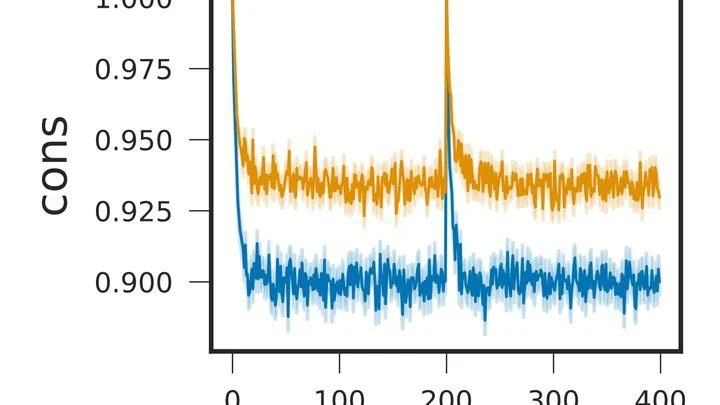
Если показать одну и ту же фотографию кота двум разным нейросетям, они часто приходят к похожему выводу: «кот». Но если спросить их подробнее, ответы могут разойтись. Одна модель обратит внимание на усы, другая — на окрас, третья — на позу. Получается, что даже внутри «зрительного» мира нейросетей нет полного единства.
Учёные придумали способ измерить это единство для каждой картинки отдельно.
Камешек падает в пруд — и по воде разбегаются ровные круги. Но дно пруда усеяно стёклышками-невидимками: каждое чуть задерживает волну, где-то рассеивает, где-то меняет её шаг. Примерно так гравитационные волны — дрожь самого пространства — проходят сквозь далёкие галактики и тёмные сгустки материи. Эти сгустки работают как линзы, только не световые, а гравитационные.
Нейросеть, натренированная на столкновениях протонов и электронов, перенесла свои навыки на совсем другой эксперимент — ловлю нейтрино. Словно повар, который учился готовить французскую кухню, а потом без подготовки испёк отличный узбекский плов.
Сейсмологи слушают Землю, как врач слушает сердце. Поверхностные волны от землетрясений расходятся по планете, и по их скорости можно судить о том, что скрыто под ногами — твёрдая порода, расплав или вода. Обычно для этого строят сложные физические модели.
Обычная медицинская нейросеть видит пациента как точку на карте: есть рост, давление, анализ крови — и модель ставит одну метку «здоров» или «болен». Но в реальной больнице карта всегда рваная. Один анализ сдан в понедельник, другой — через месяц, а томограф вообще другой марки. Точка на такой карте — самообман.
Новая модель работает иначе.
Мозг человека с болезнью Паркинсона работает как оркестр, в котором дирижёр то замирает, то размахивает палочкой невпопад. Лекарства помогают не всем, и тогда врачи предлагают стимуляцию — слабые электрические импульсы, которые возвращают ритм. Но у каждого мозг устроен по-своему: одному подходит один способ, другому — второй.
Когда нейтрон или протон влетает в атомное ядро, он ведёт себя как мяч, ударяющийся о неровную стену: отскочить может по-разному, в зависимости от того, куда попал. Физики описывают такие столкновения с помощью «оптической модели» — она заменяет сложное ядро на эффективный потенциал, как если бы мы описывали стену одной средней высотой, а не каждой выемкой.
Когда массивная звезда исчерпывает ядерное топливо и схлопывается в сверхновую, рождается нейтронная звезда — объект диаметром с небольшой город, но с массой, сравнимой с солнечной. Её вещество сжато до такой степени, что одна чайная ложка этого материала весила бы больше, чем гора Эверест.
В недрах каждого жёсткого диска или флешки прячется материал, который умеет «запоминать» электрическое поле. Такой материал называют сегнетоэлектриком. Если приложить к нему напряжение, внутри кристалла развернутся крошечные области — домены, как стрелки компаса. Повернул стрелку — записал единицу, повернул обратно — ноль.