El cosmos se entrena para predecir exprés
Miles de universos nacieron en un ordenador para contarnos algún día sobre el nuestro. Cada uno con sus cúmulos de galaxias, dispuestos según las leyes de la gravedad, como guisantes en un frasco que se agita con distinta fuerza. Según cómo queden los guisantes, se puede deducir qué mano agitó el frasco. Así también aquí: por el patrón de los cúmulos, los científicos quieren determinar cuánta materia oscura hay en el universo y con qué rapidez se fue agrupando en grumos.
Antes, de estos patrones solo se extraían un par de números: cuántos cúmulos hay en total y cuánto tienden a mantenerse a ciertas distancias. Es como juzgar un cuadro por el color medio y el número de pinceladas. Ahora, la red neuronal observa el cuadro completo: un mapa tridimensional donde cada punto es un cúmulo de galaxias. Y aprende con treinta y dos mil de estas imágenes, generadas según distintos escenarios.
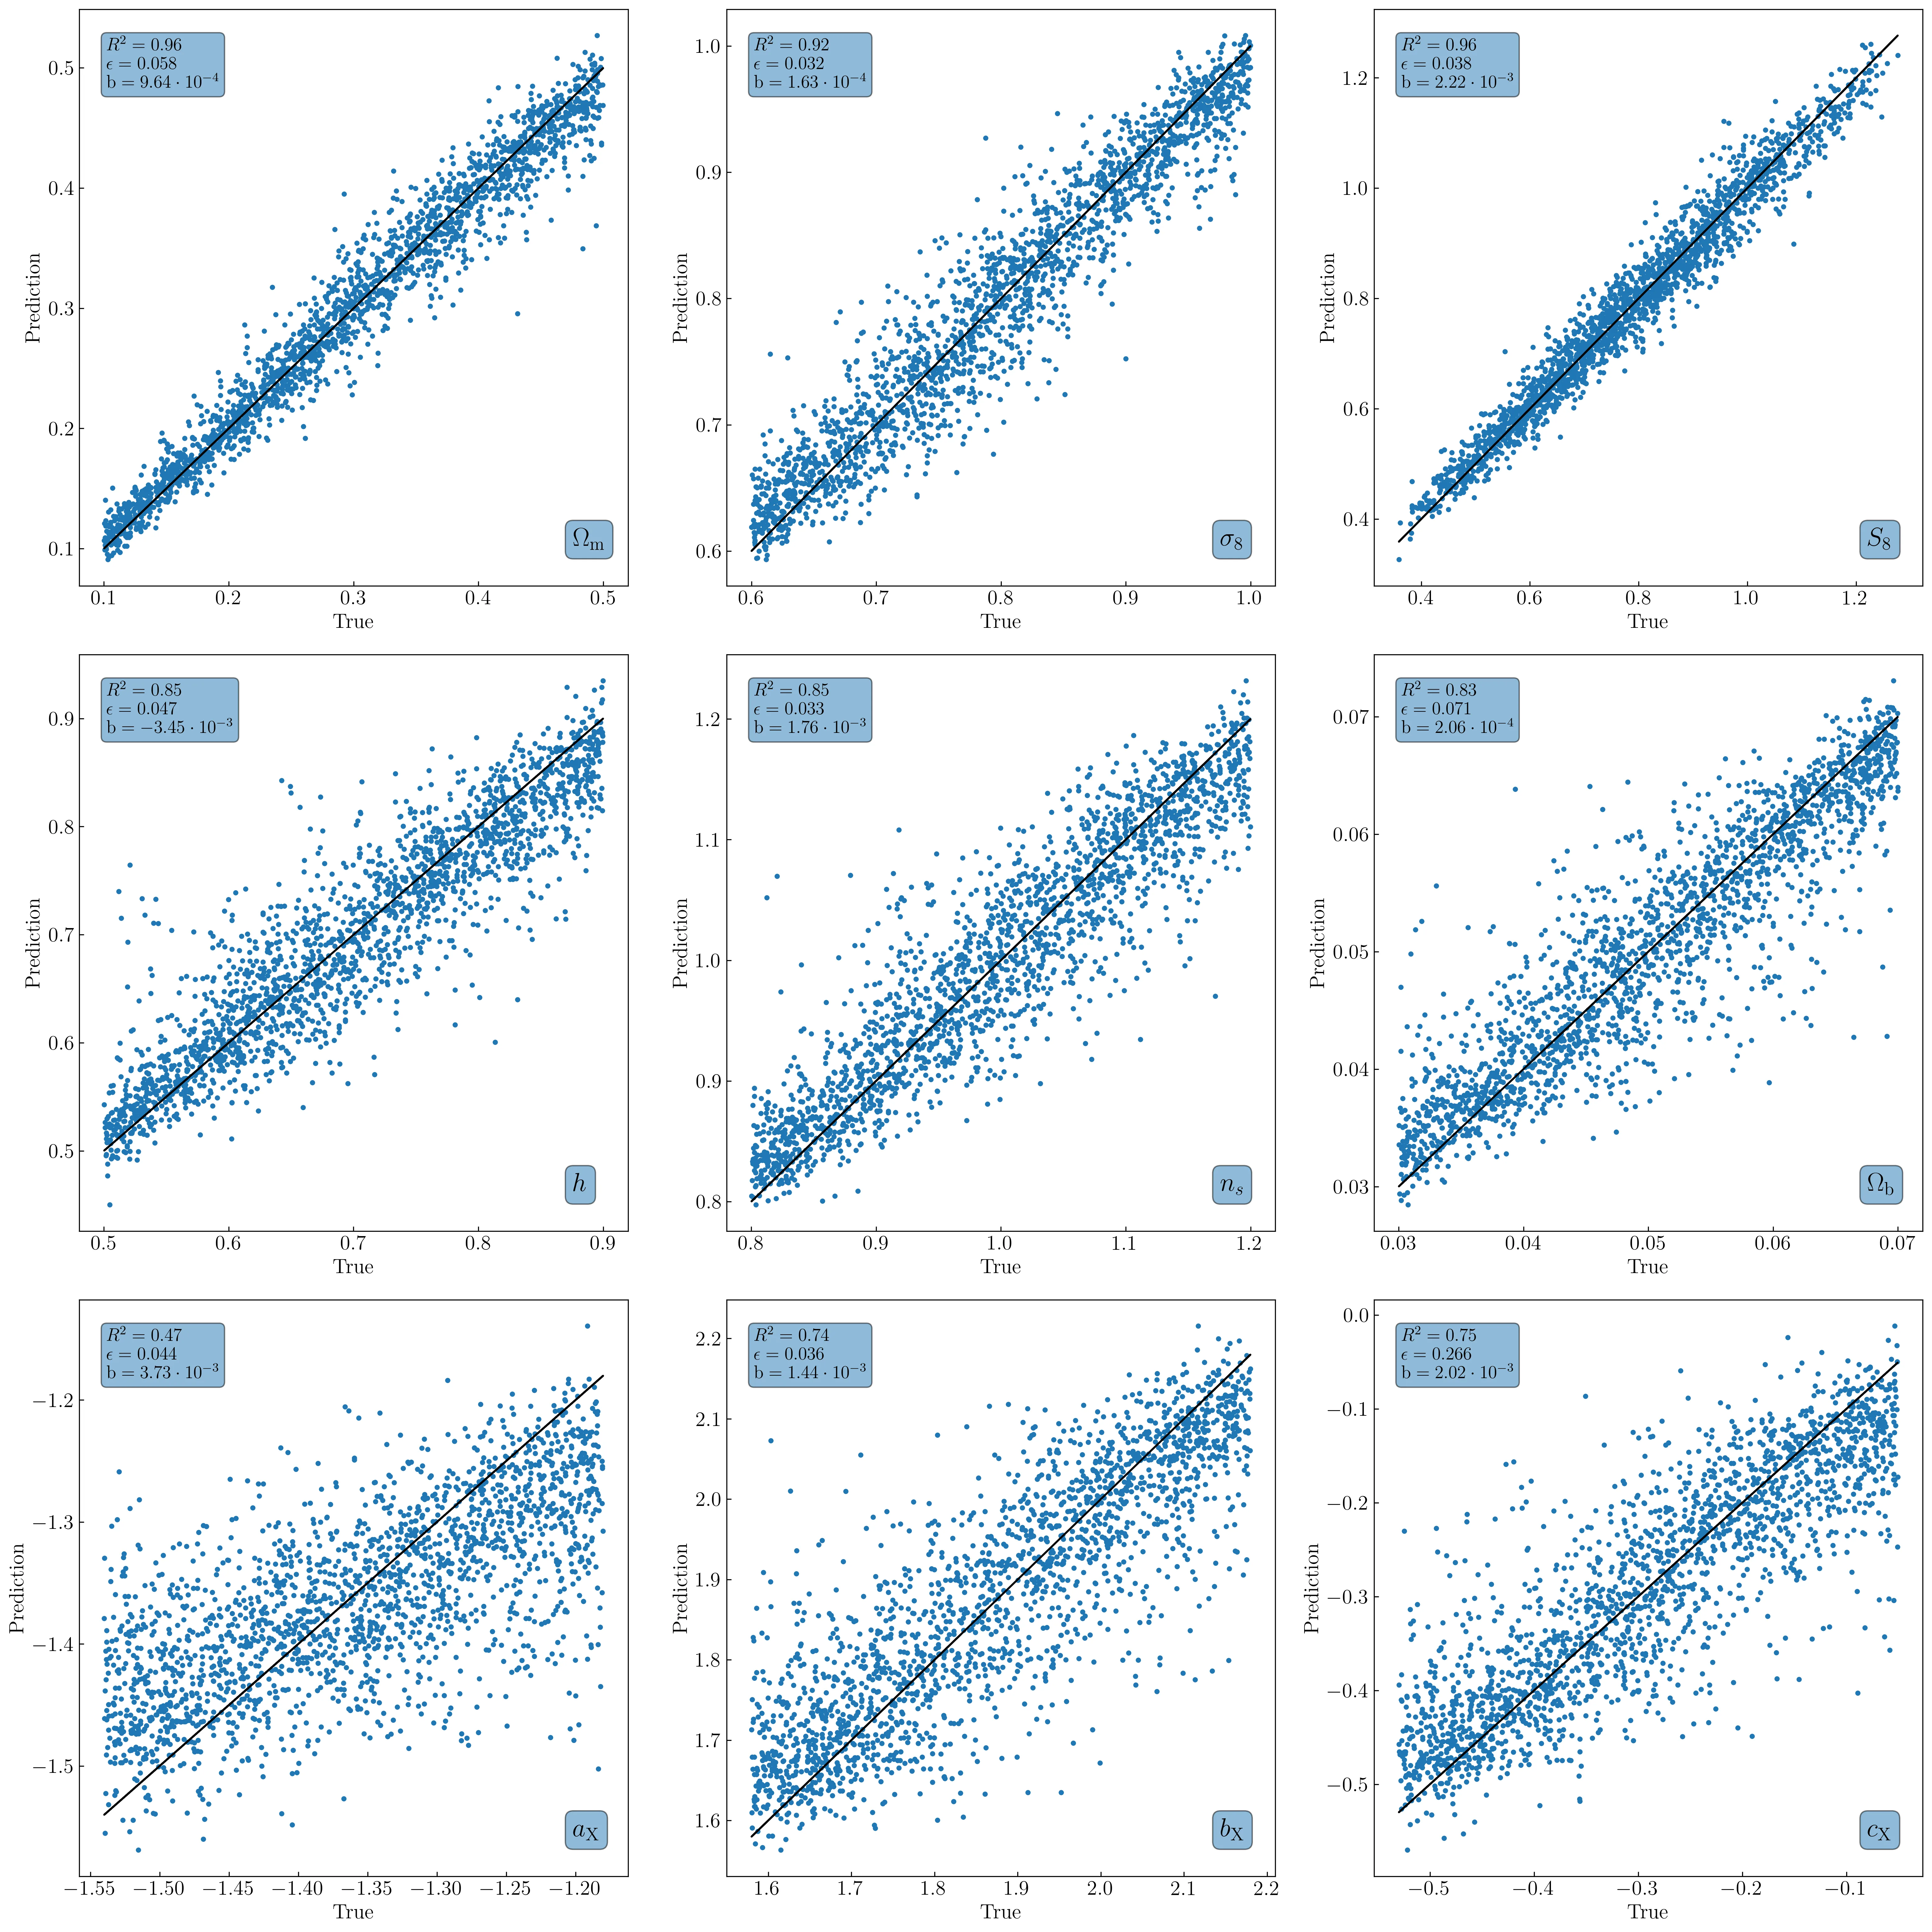
El resultado es esperanzador: el nuevo enfoque se equivoca en la estimación de la densidad de materia un diez por ciento menos que el anterior, y en la estimación de la aglomeración, un veinte por ciento. Si además se le comunica a la red neuronal el brillo de cada cúmulo, la precisión aumenta el doble. El brillo aquí es como el tamaño del guisante: también depende de cuánta materia oscura haya alrededor.
Así, los universos simulados se convierten en un libro de texto para leer el nuestro. Cuanto mejor sea el libro, con más precisión sabremos de qué está hecho el cosmos y hacia dónde se dirige.
Resumen original
tal como lo escribieron los autores, en inglés arXiv:2601.03894
The possibility to constrain cosmological parameters from galaxy surveys using field-level machine learning methods that bypass traditional summary statistics analyses, depends crucially on our ability to generate simulated training sets. The latter need to be both realistic, as to reproduce the key features of the real data, and produced in large numbers, as to allow us to refine the precision of the training process. The analysis presented in this paper is an attempt to respond to these needs by (a) using clusters of galaxies as tracers of large-scale structure, together with (b) adopting a 3LPT code (Pinocchio) to generate a large training set of $$32\,768$$ mock X-ray cluster catalogues. X-ray luminosities are stochastically assigned to dark matter haloes using an empirical $$M-L_X$$ scaling relation. Using this training set, we test the ability and performances of a 3D convolutional neural network (CNN) to predict the cosmological parameters, based on an input overdensity field derived from the cluster distribution. We perform a comparison with a neural network trained on traditional summary statistics, that is, the abundance of clusters and their power spectrum. Our results show that the field-level analysis combined with the cluster abundance yields a mean absolute relative error on the predicted values of $$\Omega_{\rm m}$$ and $$\sigma_8$$ that is a factor of $$\sim 10 \%$$ and $$\sim 20\%$$ better than that obtained from the summary statistics. Furthermore, when information about the individual luminosity of each cluster is passed to the CNN, the gain in precision exceeds $$50\%$$.
En el conjunto de entrenamiento había 32 768 universos virtuales, que es exactamente 2 elevado a la 15, un número "redondo" para los ordenadores.