La agrupación (clustering) es una técnica de análisis de datos que se utiliza para agrupar un conjunto de objetos de manera que los objetos del mismo grupo (llamado conglomerado) sean más similares entre sí que con los de otros grupos. Es una forma de aprendizaje no supervisado, lo que significa que encuentra patrones ocultos en los datos sin etiquetas previas. La agrupación se usa ampliamente para explorar datos, identificar agrupaciones naturales y reducir la complejidad resumiendo grandes conjuntos de datos en conglomerados representativos.
Historia
El concepto de agrupación se remonta a la década de 1930 en antropología y psicología, pero el primer algoritmo formal, k-medias, fue introducido por Stuart Lloyd en 1957 (aunque se publicó más tarde). Los métodos de agrupación jerárquica se desarrollaron en la década de 1960.
Cómo funciona
Los algoritmos de agrupación funcionan definiendo una medida de similitud (por ejemplo, distancia euclidiana, correlación) entre los puntos de datos y luego asignando iterativamente puntos a los conglomerados para optimizar algún criterio, como minimizar la varianza dentro del conglomerado (como en k-medias) o maximizar la densidad de puntos (como en DBSCAN). La elección del algoritmo y de la medida de similitud depende del tipo de datos y de la forma deseada del conglomerado. Una vez formados los conglomerados, se pueden visualizar, analizar o utilizar como características para modelos posteriores.
En la práctica
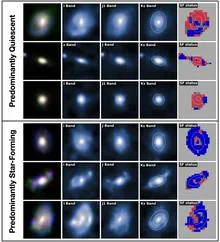
La agrupación se utiliza en astronomía para clasificar galaxias, en biología para agrupar genes con patrones de expresión similares, en marketing para segmentar clientes y en análisis de imágenes para comprimir o segmentar imágenes.
Dato curioso
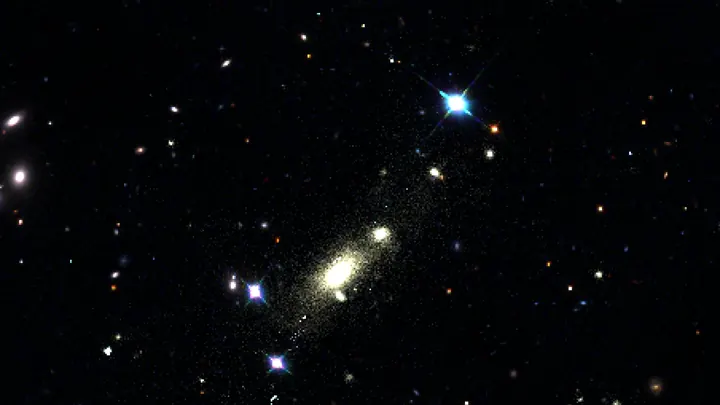
En astronomía, los algoritmos de agrupación ayudaron a descubrir que las galaxias no se distribuyen al azar, sino que forman una vasta red cósmica de filamentos y vacíos, revelando la estructura a gran escala del universo.
Una imagen de una galaxia lejana tomada desde la Tierra se asemeja a mirar a través de un vidrio esmerilado: la atmósfera desenfoca los detalles y la estructura interna permanece oculta.
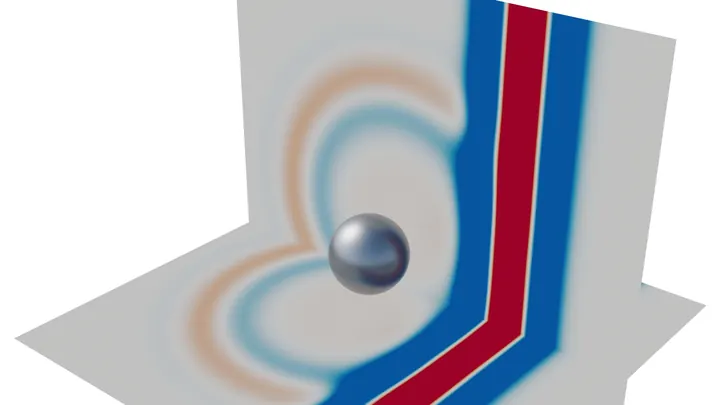
Dos depósitos de tinta se encuentran a ambos lados de la unión celular. De ellos fluyen hacia la membrana dos tipos de monómeros que, al encontrarse, forman gotas viscosas de complejos. Las gotas apenas se mueven, mientras que los monómeros libres se desplazan rápidamente, como moléculas de perfume en una habitación.
Imagina una bandada de pájaros que se reúne alrededor de un comedero que nadie construyó. Cada pájaro busca comida para sí mismo, pero al final terminan juntos. Por lo general, ese comportamiento se explica por un instinto social: los pájaros quieren estar cerca de sus congéneres. Pero, ¿y si la bandada es solo un efecto secundario de la codicia?
La galaxia NGC 4254 se encuentra a un millón y medio de años luz del centro del cúmulo de galaxias de Virgo. Arrastra tras de sí una larga cola de hidrógeno que se enfría, una señal de que se está precipitando a toda velocidad en el medio interestelar caliente.
Doscientas cuarenta y dos mil trescientas veintisiete galaxias — como granos de arena en una playa. Pero los astrónomos convirtieron este caos en un mapa: el algoritmo UMAP (método de aprendizaje automático) tomó de cada galaxia once parámetros — siete colores desde el óptico hasta el infrarrojo medio (esto es…
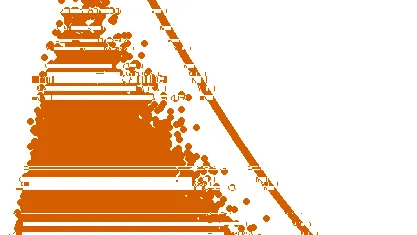
Las gotas de agua salen de la boquilla una tras otra, como ciclistas en una pista estrecha. Las que vuelan más rápido alcanzan a las lentas y se fusionan con ellas formando gotas más grandes. Este mecanismo simple se llama agregación balística y hasta ahora solo se había observado a escalas cósmicas: así se unen las partículas de polvo para formar planetas.
La temperatura en el centro de un cúmulo de galaxias alcanza los cien millones de grados. Estos sistemas, los más grandes ligados gravitacionalmente, son laboratorios naturales donde la naturaleza esconde el 85% de su masa en la invisible materia oscura.
Normalmente la complejidad de los sistemas –desde el movimiento de satélites hasta los ritmos cardíacos– se evalúa con la entropía promedio (medida de imprevisibilidad, tal como la entendía Boltzmann).
En una sopa hirviendo, las moléculas chocan caóticamente y reaccionan. Pero si medimos cómo cambian sus concentraciones, emergen patrones. Así funcionan las redes químicas de carbono: mezclas de moléculas que espontáneamente «cocinan» información, convirtiendo cada reacción en un cálculo elemental. Antes solo se usaban para modelar la naturaleza.
Un radar normal se parece a un micrófono en una multitud ruidosa: los sonidos individuales se mezclan en un caos. PiVoT funciona como un director de orquesta que, en medio del caos de la afinación, reconoce al instante cada instrumento.
El cerebro se comunica con breves chasquidos eléctricos. Antes, para aprender este lenguaje, se necesitaban miles de ejemplos traducidos por un experimentador. El método MOJO sigue otro camino: como cuando se aprende un idioma por inmersión, primero escucha el 'flujo de conciencia' sin pistas y encuentra por sí mismo patrones repetitivos.
Un niño que explora un apartamento desconocido gatea de un objeto a otro y recuerda lo que se ve desde cada rincón. Así, el cerebro construye un mapa mental: un modelo interno del espacio. El algoritmo gradCSCG funciona con el mismo principio: recibe un flujo de video de una cámara y dibuja de forma autónoma el esquema de la habitación, basándose únicamente en el cambio de las imágenes.
El oído humano está diseñado de tal manera que el cerebro destaca principalmente los patrones conocidos: la voz del interlocutor, el ruido de la lluvia, la bocina de un coche. Sin embargo, el nuevo sistema funciona con un principio diferente: detecta cualquier ráfaga sonora, incluso una que nunca antes se haya encontrado.
Los científicos tomaron 16 actividades cotidianas — desde lavar platos hasta hacer sentadillas — y descompusieron los movimientos en componentes elementales, como un espectroscopio descompone la luz en un espectro. Comparando tres enfoques, encontraron una clave inesperada para el reconocimiento: basta con un fotograma congelado promediado.
En el Universo joven, hace unos diez mil millones de años, las galaxias parecían campos ilimitados después de una tormenta: por todas partes brotaban gigantescos grumos de formación estelar de miles de años luz, donde las estrellas jóvenes nacían con una energía desenfrenada. Hoy esas regiones casi han desaparecido: en las galaxias cercanas, los focos intensos son raros.
El núcleo de carbono se representó durante mucho tiempo como una esfera homogénea de protones y neutrones, uniformemente mezclados como una masa. Pero el físico George Gamow sospechaba algo distinto: las partículas en su interior podrían agruparse en diminutos bloques muy compactos, los núcleos de helio, o partículas alfa.
Las profundidades del cosmos no callan: están llenas de mensajes cifrados. Cada estrella, cada cuásar emite su propio código de luz titilante: rítmico, como el morse de una cefeida, o caótico, como un cifrado hackeado de una supernova. Los astrónomos interceptan estas señales por millones cada noche, pero ¿cómo leerlas sin una clave?
Los cúmulos de galaxias son los mayores conjuntos gravitacionales del Universo. En el resplandor de rayos X, generado por el plasma caliente, está codificada la historia de la expansión del cosmos, la materia oscura oculta y la enigmática energía oscura.
Danza de cientos de partículas: algunos pares giran lenta y suavemente, otros se sacuden a un ritmo frenético. Para entender la esencia del baile, hay que fijarse en los movimientos lentos: son la coreografía principal del sistema.
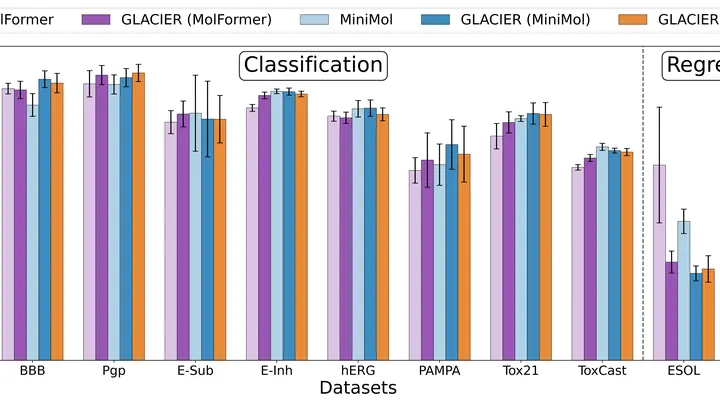
Buscar la molécula adecuada entre miles de millones de opciones es como buscar un grano de arroz en un saco lleno. Para no revisarlo todo a mano, los químicos recurren cada vez más a las redes neuronales. Pero los modelos grandes requieren ordenadores potentes, y a los pequeños a menudo les falta visión de conjunto.
Si aplaudes en una habitación vacía, el eco revelará su tamaño y forma. Cada objeto —una silla, un libro, una persona— añade su propia firma a ese eco: el sonido se refleja en él de una manera particular. Los autores del artículo han ideado cómo reescribir por completo esa firma sonora. Rodearon una región del espacio con una superficie cerrada de micrófonos y altavoces.
El espacio-tiempo a menudo se representa como una tela lisa. Pero en el nivel más microscópico, esta tela podría no ser continua, sino estar formada por "átomos" individuales: eventos conectados por causalidad. Esta imagen del mundo se llama teoría de conjuntos causales.
Una red social se parece a una ciudad: hay barrios gigantes y callejones diminutos. Cuando un algoritmo busca grupos cohesionados, a menudo identifica un par de grupos enormes y muchos fragmentos pequeños. Pero el cliente —por ejemplo, un municipio— necesita barrios de tamaño similar para distribuir uniformemente centros de salud o escuelas.
Dos fotones entrelazados se separan en direcciones opuestas, pero siguen comportándose como un todo: la medición de uno determina instantáneamente el estado del otro. Esto es el entrelazamiento cuántico. Sin embargo, a veces se parece a un espía experimentado: no deja rastros visibles en una inspección ordinaria.
Suena una melodía y el cerebro no se limita a escuchar nota tras nota. Actúa como un director de orquesta que ya conoce la partitura: cada nota siguiente es esperada porque las anteriores aún resuenan en la memoria. Pero, ¿cómo mantienen las neuronas ese eco?
Cada vez que dudas ante un paso arriesgado —si invertir en acciones o esperar—, en tu cabeza se desarrolla un diálogo interno. Normalmente, los científicos intentan reconstruir el curso de ese diálogo basándose únicamente en la elección final, como si un detective reconstruyera una conversación entre dos personas mirando una foto del lugar del encuentro.
Tras una partida de Scrabble, el tablero parece un mosaico: las fichas están dispersas, pero forman un patrón conectado: islas de palabras en medio de un mar de casillas vacías. Ese patrón puede describirse matemáticamente, pero normalmente requiere reglas complejas.
En los márgenes del sistema solar, mucho más allá de Neptuno, orbitan cientos de bloques de hielo. Algunos se mueven como si una mano invisible hubiera alineado sus órbitas, como agujas de brújula. Hace diez años, esto llevó a los astrónomos a pensar que allí se esconde un planeta masivo, unas diez veces más pesado que la Tierra.
Los detectores de partículas, como las cámaras planas resistivas (RPC), funcionan como trampas sensibles: cuando una partícula cargada los atraviesa, se genera una señal eléctrica. Pero a veces la cámara produce un rastro falso, como si alguien invisible hubiera pulsado el timbre.
En un acelerador de partículas, los núcleos se rompen en fragmentos, como una taza de porcelana al caer. Cada fragmento atraviesa láminas de silicio, que registran el impacto y su intensidad.
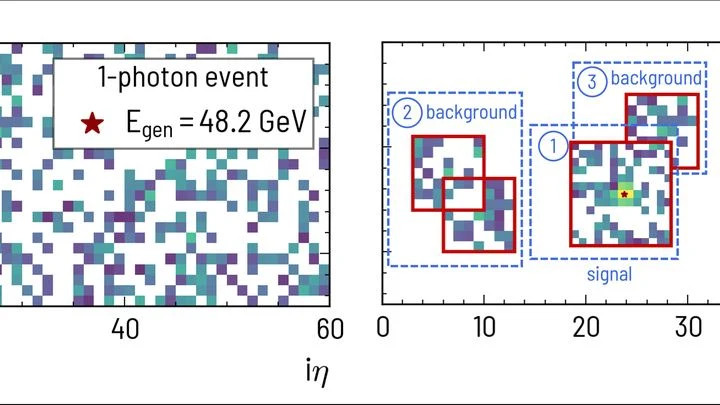
En el detector del Gran Colisionador de Hadrones nacen millones de partículas cada segundo. Sus destellos de energía en el calorímetro se parecen a las gotas de lluvia en el cristal de una ventana: las gotas individuales se ven, pero cuando son muchas y se fusionan, distinguir cada una resulta difícil.
Las imágenes de galaxias lejanas están salpicadas de arcos curvos y manchas: es la luz distorsionada en su camino hacia nosotros. El efecto, predicho por Albert Einstein, funciona como un espejo curvo gigante: un cúmulo masivo de galaxias distorsiona las imágenes de las fuentes de fondo.
Una computadora normal, cuando busca una ley de la naturaleza a partir de datos, intenta adivinar una fórmula completa de una sola vez. Es como si un cocinero, sin conocer la receta, echara todos los ingredientes a la vez en la olla y esperara que saliera una sopa. La mayoría de las veces sale una papilla incomible: la fórmula es larga pero sin sentido, y con datos nuevos se equivoca.
Los cúmulos globulares son densos archivos estelares donde está inscrita la juventud de la Galaxia. Pero leer esa crónica era difícil por cronómetros imprecisos: las estimaciones de edad divergían en mil millones de años.
Imagina el murmullo de una plaza abarrotada: así suena el fondo de ondas gravitacionales del universo, captado por una red de púlsares —estrellas de neutrones que emiten pulsos de radio regulares con la precisión de relojes atómicos.
Las comunidades microbianas se parecen a una orquesta ruidosa: miles de instrumentos y no se sabe quién lleva la melodía principal. En el intestino, el océano o el suelo viven millones de especies de bacterias, y los científicos necesitan averiguar cuáles son realmente importantes para la salud humana o la fertilidad de la tierra.
La ciencia se parece a una ciudad donde las calles las trazan los propios habitantes. Donde ya hay senderos pisoteados se construyen casas nuevas, mientras que los solares vírgenes pasan desapercibidos, no porque no se pueda construir allí, sino porque nadie se acerca a mirarlos.
El cerebro se parece a una gran ciudad: los distritos (las regiones) se comunican entre sí a través de calles (las vías nerviosas). Si los semáforos de un cruce se estropean, el tráfico se detiene. Lo mismo ocurre en el cerebro: si los haces de fibras nerviosas (la sustancia blanca) funcionan mal, las regiones distantes dejan de actuar de manera coordinada y el pensamiento se atasca.
Puntos luminosos sobre un fondo oscuro: así se ven las imágenes de moléculas individuales tomadas con el método MINFLUX. Este microscopio puede mostrar detalles de menos de cinco nanómetros, unas diez mil veces más delgado que un cabello humano.
Cuando los químicos observan cómo cambian las concentraciones de las sustancias, necesitan entender qué reacciones están detrás de esos cambios. Es como intentar reconstruir la receta de un plato a partir de fotografías de los platos en diferentes momentos de la comida. Antes, para esto se solían usar derivadas, es decir, las velocidades instantáneas de cambio de las concentraciones.