El agrupamiento por k-medias es un algoritmo de aprendizaje no supervisado que divide un conjunto de datos en un número predefinido de grupos, cada uno representado por su centroide (la media de sus puntos). El objetivo es minimizar la varianza dentro de cada grupo, haciendo que los puntos del mismo grupo sean lo más similares posible mientras se mantienen distintos los diferentes grupos. Es uno de los métodos de agrupamiento más simples y más utilizados, y a menudo sirve como referencia para enfoques más complejos.
Historia
El término 'k-medias' fue utilizado por primera vez por James MacQueen en 1967, aunque la idea central se remonta a Hugo Steinhaus en 1956 y al algoritmo de Lloyd (1957) para la modulación por impulsos codificados.
Cómo funciona
El algoritmo comienza inicializando aleatoriamente k centroides. Luego itera dos pasos: (1) asignar cada punto de datos al centroide más cercano, y (2) recalcular cada centroide como la media de todos los puntos asignados a él. Estos pasos se repiten hasta que los centroides dejan de cambiar significativamente. El resultado depende de la colocación inicial, por lo que es común ejecutar el algoritmo varias veces con diferentes semillas y elegir el mejor resultado. El número de grupos k debe elegirse de antemano, a menudo usando el método del codo o el análisis de silueta.
En la práctica
Las k-medias se utilizan para la segmentación de clientes en marketing, la compresión de imágenes reduciendo las paletas de colores y la detección de anomalías identificando puntos lejanos de cualquier centroide.
Dato curioso
Las k-medias son tan eficientes que pueden agrupar millones de puntos en segundos, pero asumen que los grupos son esféricos y de tamaño similar, lo cual rara vez es cierto en datos reales.
Dos depósitos de tinta se encuentran a ambos lados de la unión celular. De ellos fluyen hacia la membrana dos tipos de monómeros que, al encontrarse, forman gotas viscosas de complejos. Las gotas apenas se mueven, mientras que los monómeros libres se desplazan rápidamente, como moléculas de perfume en una habitación.
Un intérprete en una sala donde se hablan tres idiomas a la vez al principio solo oye un ruido general. Pero si empieza a repreguntar, a prestar atención a las entonaciones y a precisar una y otra vez quién respondió con qué frase, poco a poco las voces individuales emergen de la cacofonía.
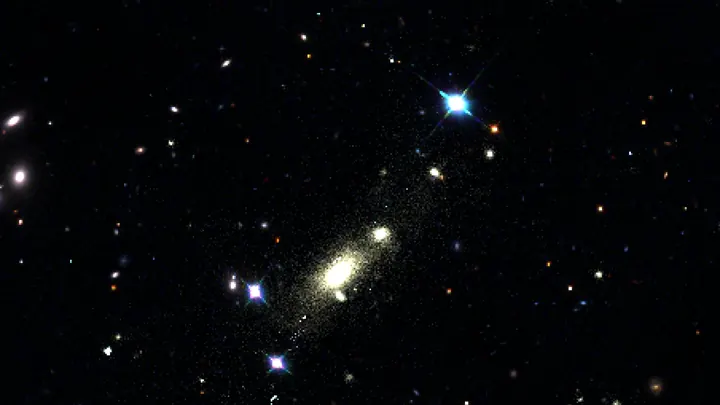
La galaxia NGC 4254 se encuentra a un millón y medio de años luz del centro del cúmulo de galaxias de Virgo. Arrastra tras de sí una larga cola de hidrógeno que se enfría, una señal de que se está precipitando a toda velocidad en el medio interestelar caliente.
La temperatura en el centro de un cúmulo de galaxias alcanza los cien millones de grados. Estos sistemas, los más grandes ligados gravitacionalmente, son laboratorios naturales donde la naturaleza esconde el 85% de su masa en la invisible materia oscura.
Normalmente la complejidad de los sistemas –desde el movimiento de satélites hasta los ritmos cardíacos– se evalúa con la entropía promedio (medida de imprevisibilidad, tal como la entendía Boltzmann).
Un IA común ve las imágenes médicas como rompecabezas de fragmentos desconocidos: dos imágenes no emparejadas las considera completamente diferentes. Es como intentar distinguir a gemelos sin saber que son familia. En medicina, los pacientes con la misma enfermedad se ven casi iguales en la resonancia, y el algoritmo se equivoca al confundir a los «parientes».
El cerebro se comunica con breves chasquidos eléctricos. Antes, para aprender este lenguaje, se necesitaban miles de ejemplos traducidos por un experimentador. El método MOJO sigue otro camino: como cuando se aprende un idioma por inmersión, primero escucha el 'flujo de conciencia' sin pistas y encuentra por sí mismo patrones repetitivos.
Un niño que explora un apartamento desconocido gatea de un objeto a otro y recuerda lo que se ve desde cada rincón. Así, el cerebro construye un mapa mental: un modelo interno del espacio. El algoritmo gradCSCG funciona con el mismo principio: recibe un flujo de video de una cámara y dibuja de forma autónoma el esquema de la habitación, basándose únicamente en el cambio de las imágenes.
Durante mucho tiempo, identificar fases cuánticas era como interrogar a un testigo: había que acceder a cada rincón del sistema para arrancarle su secreto. En la época de Landau, el orden se asociaba con la ruptura de simetría y un parámetro local, todo a la vista.
El microlente gravitacional es un asombroso efecto cósmico, predicho por Einstein y desarrollado por Zwicky. Un cuerpo masivo que pasa entre nosotros y una estrella lejana curva su luz como una lente, creando amplificaciones y distorsiones características.
Muchos cálculos avanzados en física chocan contra un muro de piedra: no los frena la falta de ideas, sino la aritmética. Hablamos de integrales que expresan la probabilidad de colisión de partículas o la forma de un pulso de ondas gravitacionales.
Una red social se parece a una ciudad: hay barrios gigantes y callejones diminutos. Cuando un algoritmo busca grupos cohesionados, a menudo identifica un par de grupos enormes y muchos fragmentos pequeños. Pero el cliente —por ejemplo, un municipio— necesita barrios de tamaño similar para distribuir uniformemente centros de salud o escuelas.
Tres personas están sentadas en tres esquinas de una habitación. Cada una recibe un sobre sellado de un mensajero invisible, pero los mensajeros no se coordinan y nunca se han conocido. Las personas abren los sobres y ven una nota con una sola palabra: «sí» o «no». Ellos no eligen nada, solo leen.
Si le muestras la misma foto de un gato a dos redes neuronales diferentes, a menudo llegan a una conclusión similar: «gato». Pero si les preguntas con más detalle, las respuestas pueden divergir. Un modelo se fijará en los bigotes, otro en el pelaje, un tercero en la postura. Resulta que incluso dentro del mundo «visual» de las redes neuronales no hay una unidad total.
Dos cerraduras casi idénticas se abren con la misma ganzúa. Por fuera parecen iguales, pero por dentro el mecanismo es distinto. Así se ven los dos principales tipos de cáncer de pulmón de células no pequeñas: el adenocarcinoma y el carcinoma de células escamosas. Al microscopio se pueden confundir, pero el tratamiento que requieren es diferente.
En un acelerador de partículas, los núcleos se rompen en fragmentos, como una taza de porcelana al caer. Cada fragmento atraviesa láminas de silicio, que registran el impacto y su intensidad.
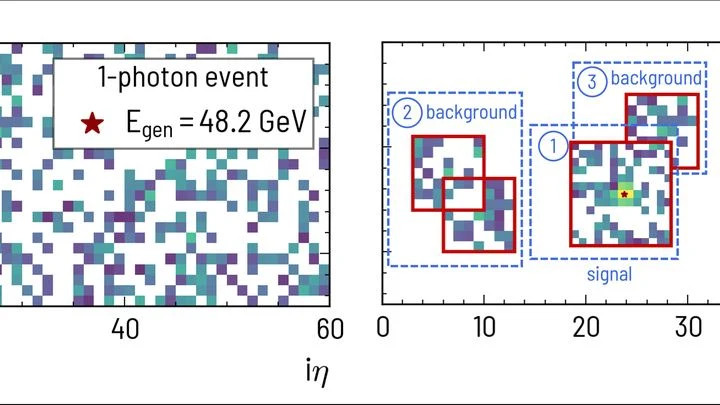
En el detector del Gran Colisionador de Hadrones nacen millones de partículas cada segundo. Sus destellos de energía en el calorímetro se parecen a las gotas de lluvia en el cristal de una ventana: las gotas individuales se ven, pero cuando son muchas y se fusionan, distinguir cada una resulta difícil.
Las imágenes de galaxias lejanas están salpicadas de arcos curvos y manchas: es la luz distorsionada en su camino hacia nosotros. El efecto, predicho por Albert Einstein, funciona como un espejo curvo gigante: un cúmulo masivo de galaxias distorsiona las imágenes de las fuentes de fondo.
Puntos luminosos sobre un fondo oscuro: así se ven las imágenes de moléculas individuales tomadas con el método MINFLUX. Este microscopio puede mostrar detalles de menos de cinco nanómetros, unas diez mil veces más delgado que un cabello humano.
Una computadora cuántica teje con los qubits algo parecido a un hilo, donde cada nudo es una partícula y la conexión entre ellos es un entrelazamiento. Cuando un físico mide un qubit, el hilo cambia: en algún lugar se rompe, en otro se cose, y a veces aparece un giro.
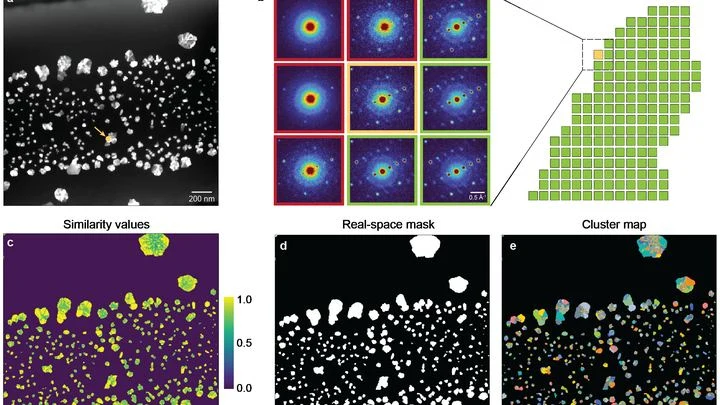
El microscopio electrónico escanea la muestra y en cada punto registra cómo se dispersan los electrones en los átomos. El resultado es una pila gigante de imágenes, una por cada punto. En ellas está codificada la información sobre cómo se ordenan los átomos: en filas regulares o con desviación, hacia dónde está girada la red cristalina, si hay tensiones internas.
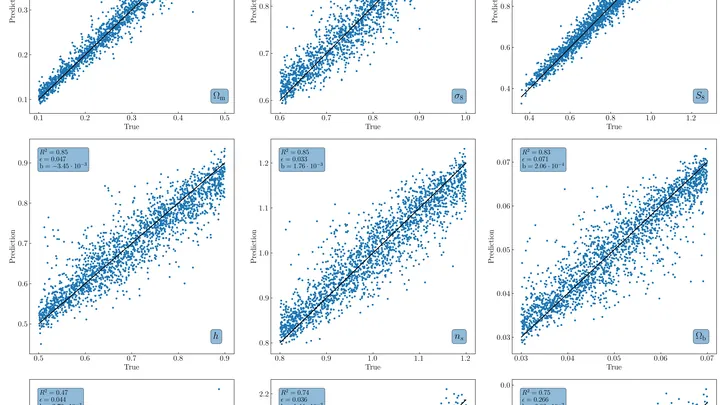
Miles de universos nacieron en un ordenador para contarnos algún día sobre el nuestro. Cada uno con sus cúmulos de galaxias, dispuestos según las leyes de la gravedad, como guisantes en un frasco que se agita con distinta fuerza. Según cómo queden los guisantes, se puede deducir qué mano agitó el frasco.
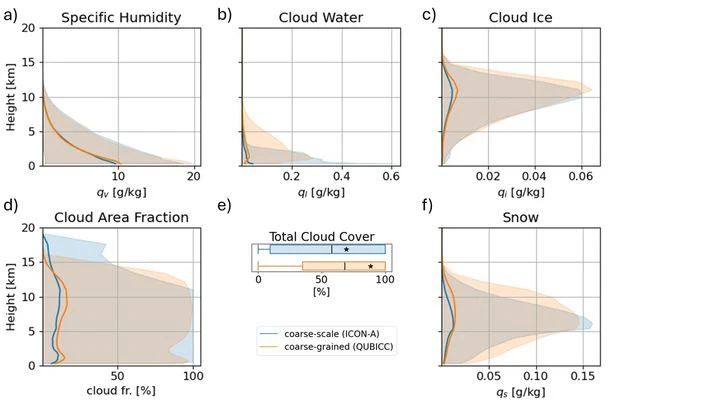
El pronóstico del clima se parece a una receta compleja: una pizca equivocada y todo el plato se arruina. Así pasa con las nubes: pequeñas pero decisivas. Los modelos climáticos dividen el cielo en celdas de 50 a 100 km y no ven las nubes individuales. Es como echar pimienta a puñados cuando la receta pide una pizca.