Connexions denses contre résiduelles : comment DenseNet-121 surpasse ResNet-50 dans la détection du cancer du cerveau ✛
L'épaisseur d'une coupe de tissu cérébral n'est que de 5 microns, soit vingt fois plus fine qu'un cheveu humain. Sur une telle coupe, le pathologiste recherche des signes de tumeur : forme anormale des noyaux, densité cellulaire accrue, vaisseaux anormaux. C'est un travail minutieux, et deux spécialistes peuvent avoir des avis divergents sur la même image. Dans ce contexte, le réseau de neurones n'est pas un substitut au médecin, mais un second regard qui examine l'image avec l'infatigabilité d'une machine et une précision mesurée au dixième de pour cent près.
Un réseau à connexions denses, c'est une équipe où chaque couche entend toutes les précédentes, et pas seulement son voisin immédiat. Dans DenseNet-121, chaque bloc reçoit en entrée non seulement le résultat du bloc précédent, mais aussi toutes les cartes de caractéristiques plus anciennes. L'information ne se perd pas en chemin, comme dans le jeu du téléphone arabe, mais s'accumule pour former une image globale. Dans ResNet-50, les connexions sont plus courtes : les chemins de contournement sautent par-dessus une ou deux couches, et les voisins éloignés doivent transmettre leurs messages par l'intermédiaire d'autres. Lors du transfert de connaissances d'une grande tâche vers une petite, c'est-à-dire l'apprentissage par transfert, l'équipe dense se montre plus soudée : elle trouve plus rapidement les régularités dans le petit ensemble de 2931 images.
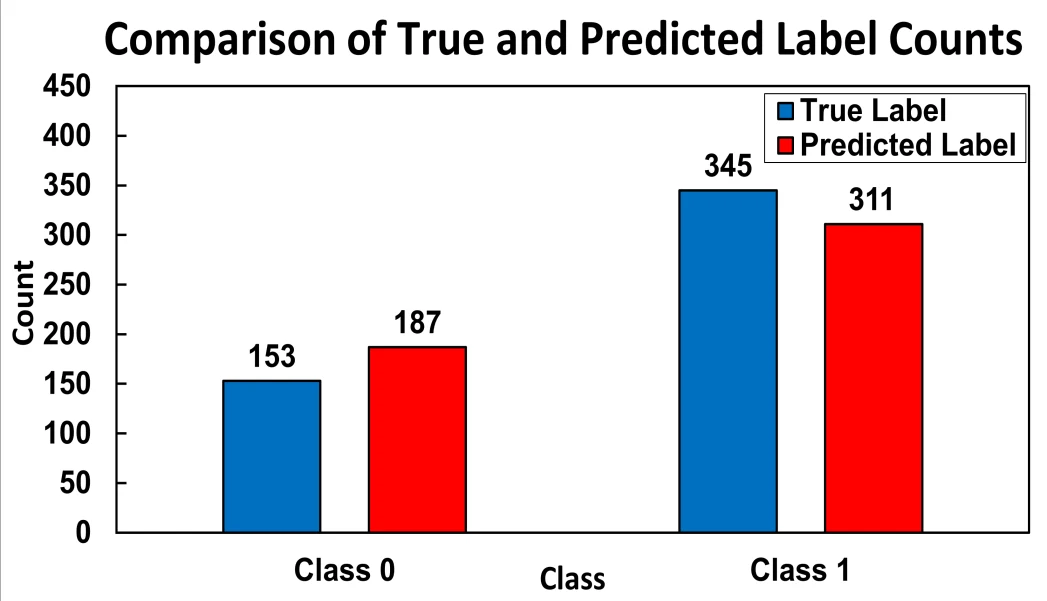
L'affinage en deux étapes, avec gel puis dégel des blocs profonds, ainsi qu'une augmentation des données agressive, c'est-à-dire l'extension artificielle de l'ensemble par des rotations, réflexions et décalages aléatoires, ont permis d'éviter le sur-apprentissage. Le réseau a appris non pas à mémoriser des images spécifiques, mais à extraire des caractéristiques stables de la maladie. Sur l'ensemble de test réservé, DenseNet-121 a atteint une précision de 88,35 %, contre 82,12 % pour ResNet-50. La différence de 6,23 points de pourcentage est statistiquement significative : la probabilité d'un écart aléatoire est inférieure à un demi pour cent.
Qu'est-ce que cela change pour la pratique ? Auparavant, on ne savait pas laquelle des architectures populaires convenait le mieux à la classification d'images de tissu cérébral avec un ensemble de données annotées limité. Désormais, c'est clair : les connexions denses offrent un avantage. Le protocole d'apprentissage peut être directement transposé à d'autres tâches de classification binaire d'images histologiques, par exemple la recherche de métastases dans les ganglions lymphatiques ou l'évaluation du degré de malignité d'une tumeur. La prochaine étape est la gradation multi-classes et les cartes d'explicabilité, qui montreront au médecin sur quelles zones de l'image le réseau s'est appuyé. Ainsi, le second regard deviendra non seulement précis, mais aussi transparent.
L'épaisseur des coupes de tissu cérébral dans l'étude n'est que de 5 microns, soit environ 20 fois plus fine qu'un cheveu humain. Pourtant, le réseau DenseNet-121 contient environ 8 millions de paramètres entraînables, soit un paramètre pour chaque 0,37 image de l'ensemble de données.