Connexions denses contre résiduelles : comment DenseNet-121 surpasse ResNet-50 dans la reconnaissance du cancer du cerveau ✛
Contexte
L'interprétation manuelle des images de biopsies cérébrales est laborieuse et souffre de divergences entre spécialistes : un même échantillon peut être évalué différemment par différents médecins. Autour de ce problème s'est déjà constitué tout un pan de travaux : les études voisines dans nos archives utilisent des réseaux de neurones pour la segmentation des tumeurs, la synthèse d'images et l'évaluation de la confiance des modèles. Cet article s'inscrit dans la même veine d'automatisation de l'analyse d'images médicales, mais se concentre sur la comparaison directe de deux architectures populaires de réseaux convolutifs pour la classification d'images de tissu cérébral. Ce n'est pas une tâche nouvelle, mais la comparaison systématique sur un même ensemble de données avec un contrôle minutieux du surapprentissage comble une lacune dans la base de preuves pour le choix de l'architecture.
Méthodes
Nous avons utilisé une puce tissulaire commerciale (TMA) avec 24 échantillons ronds de tissu cérébral de 5 microns d'épaisseur, scannée sur un microscope Olympus BX61 avec un objectif ×40 en mode de balayage automatique (environ 100 points en 6 minutes). Sur les 2931 images, 1996 ont été attribuées à l'entraînement, 437 à la validation et 498 au test, en séparant par patient pour éviter les fuites de données. Chaque image a été redimensionnée à 256×256 pixels et normalisée selon la moyenne et la variance de l'ensemble d'entraînement. Nous avons pris deux réseaux pré-entraînés sur ImageNet, ResNet-50 et DenseNet-121, et remplacé la dernière couche par un classifieur à deux sorties. L'affinage s'est fait en deux étapes : d'abord 10 époques avec uniquement le nouveau classifieur, les couches convolutives étant gelées, puis 20 époques supplémentaires avec les deux derniers blocs dégelés et un taux d'apprentissage réduit. Nous avons appliqué des rotations aléatoires, des réflexions, des translations et des changements de luminosité, ainsi qu'un arrêt précoce en l'absence d'amélioration de l'erreur de validation pendant 5 époques.
Résultats
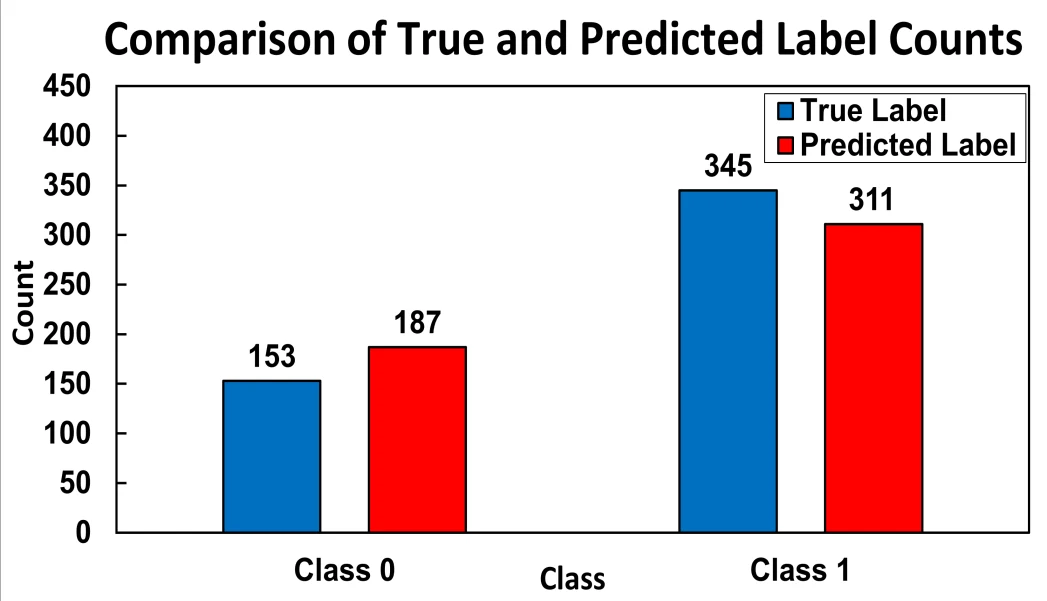
Sur l'ensemble de test réservé de 498 échantillons, DenseNet-121 a montré une précision de 88,35 % (intervalle de confiance à 95 % ±1,28 %), une précision de classe « cancer » de 0,9614, un rappel de 0,8667 et un score F1 de 0,9116. ResNet-50 a atteint 82,12 % (±1,75 %), une précision de 0,9035, un rappel de 0,8142 et un score F1 de 0,8563. La différence de précision de 6,23 points de pourcentage est statistiquement significative (p=0,004 selon le test de McNemar). La matrice de confusion de DenseNet-121 montre 299 vrais positifs, 141 vrais négatifs, 46 faux négatifs et seulement 12 faux positifs : la faible proportion de fausses alertes (7,9 %) est cruciale en clinique. Le réseau surestime légèrement la classe « pas de cancer » (187 contre 153) et sous-estime « cancer » (311 contre 345), ce qui peut être corrigé par un pondération des classes.
Implications
Ce travail démontre que les connexions denses entre les couches (comme dans DenseNet) sont plus efficaces que les chemins résiduels (comme dans ResNet) pour le transfert de connaissances vers de petits ensembles de données médicales. Par rapport aux études voisines qui utilisent souvent une seule architecture ou résolvent une tâche de segmentation, ici une comparaison directe de deux réseaux avec le même protocole d'apprentissage et une vérification statistique de significativité a été réalisée. Cela donne une recommandation pratique : pour la classification d'images de tissus avec un nombre limité d'exemples, il convient de préférer les architectures de type DenseNet. La méthode d'affinage en deux étapes avec augmentation agressive est reproductible et peut servir de modèle pour d'autres tâches de classification binaire en pathologie.
Développements futurs
Une extension naturelle est le passage de la classification binaire à une gradation multiclasse des tumeurs (faible, intermédiaire, haut degré de malignité) en utilisant des fonctions de perte ordinales. Une autre direction est la combinaison de plusieurs modalités d'images (par exemple, différentes colorations ou microscopie à contraste de phase) pour une caractérisation plus complète du tissu. Pour renforcer la confiance des médecins, des méthodes d'explicabilité telles que les cartes de saillance Grad-CAM, montrant sur quelles zones de l'image le réseau s'appuie, sont nécessaires. Enfin, l'apprentissage fédéré permettra d'entraîner des modèles sur des données provenant de différents hôpitaux sans les centraliser, améliorant ainsi la généralisabilité.
Impact
Les résultats pourraient accélérer l'adoption du dépistage automatique des biopsies cérébrales en pratique clinique, réduisant la charge de travail des pathologistes et améliorant la reproductibilité des diagnostics. La méthodologie est applicable à d'autres types de tissus et à d'autres tâches de classification en pathologie numérique.
Prochaines étapes
Tester le protocole proposé sur des ensembles de données indépendants provenant de différents hôpitaux pour confirmer la généralisabilité. Implémenter la classification multiclasse et intégrer des cartes d'explicabilité dans le flux de travail du pathologiste.
Problèmes ouverts clés
Pour l'imagerie médicale, le problème de la pénurie de données annotées reste non résolu : l'annotation d'images nécessite un travail coûteux d'experts. Ce travail montre qu'un transfert judicieux de modèles pré-entraînés avec une augmentation agressive compense partiellement ce déficit, mais ne résout pas la question des biais systématiques dans les ensembles d'entraînement. Le lien avec le problème fondamental de l'interprétabilité des modèles reste également ouvert : une haute précision ne garantit pas que le réseau s'appuie sur des caractéristiques cliniquement significatives plutôt que sur des artefacts de coloration ou de prise de vue.
Le regard de la machine du savoir
Cette section s'adresse à l'auteur du travail et à ses collègues. Les travaux voisins ont été trouvés par une recherche sémantique dans notre archive, et non par correspondance de mots. Nous n'évaluons pas : nous montrons le champ autour.
Ce que fait ce travail
Cette étude compare directement ResNet-50 et DenseNet-121 pour la classification binaire de coupes de tissu cérébral sur un ensemble de 2931 images. Un apprentissage en deux étapes avec gel et dégel des blocs, une augmentation agressive et un arrêt précoce ont été utilisés. DenseNet-121 a atteint une précision de 88,35 % et un F1 de 0,9116, surpassant significativement ResNet-50.
Où est sa force
La comparaison systématique de deux architectures populaires sur un même ensemble de données, avec un contrôle minutieux du surapprentissage, fournit des chiffres concrets pour guider le choix de l'architecture. Le faible taux de faux positifs (7,9 %) de DenseNet-121 souligne son utilité pratique.
Vers où avancer
- À proximité se trouve un travail sur l'évaluation de la confiance des réseaux de neurones sur des images de tumeurs cérébrales. Il pourrait être intéressant d'examiner comment ajouter le calibrage des prédictions à l'architecture choisie afin d'écarter les cas où le modèle hésite.appui : Tumeur cérébrale sur les images : où s'arrête la certitude arXiv:2601.17504
- Dans les archives, il y a une étude sur l'élagage des réseaux sans perte de précision. Il pourrait être utile d'appliquer ces méthodes à DenseNet-121 pour réduire la charge de calcul en vue d'une utilisation clinique potentielle.appui : Comment éclaircir un réseau sans le déchirer arXiv:2603.14564
- Un autre travail voisin est consacré à l'amélioration des images médicales à l'aide d'un modèle physique. Il serait intéressant de vérifier si un prétraitement des images de cette manière peut améliorer la qualité de la classification sur votre ensemble de données.appui : La géométrie de l'eau améliore les images médicales arXiv:2607.12586
À essayer
- Essayer le calibrage des probabilités (par exemple, le temperature scaling) sur la sortie de DenseNet-121 et évaluer comment la proportion d'erreurs confiantes change.
- Appliquer l'élagage à DenseNet-121 entraînée et comparer la précision et la vitesse d'inférence avec le réseau d'origine.
- Faire passer les images à travers un modèle d'amélioration basé sur la physique de l'eau et vérifier si la précision sur l'ensemble de test augmente.
Pourquoi cela peut compter
Si l'on parvient à combiner la précision de DenseNet-121 avec une confiance calibrée et des exigences de calcul réduites, cela rapprocherait la classification automatique des coupes cérébrales de la pratique clinique réelle, où la fiabilité et la rapidité sont toutes deux importantes.
Travaux voisins dans notre archive
- Une oreille artificielle pour capter l'énergie des particulesproximité 0.53
- Deux yeux valent mieux qu'un : quand le réseau de neurones apprend à voir la tumeurproximité 0.53
- Comment les graphes détectent le mélanome sur la peauproximité 0.53
- Tumeur cérébrale sur les images : où s'arrête la certitudeproximité 0.53
- La géométrie de l'eau améliore les images médicalesproximité 0.51
- Comment éclaircir un réseau sans le déchirerproximité 0.51
L'archive est vide autour de ce travail : l'analyse la plus proche n'est qu'à 0.53, contre 0,64 d'ordinaire. Il semble qu'on ait peu foré à côté.
L'épaisseur des coupes de tissu cérébral dans l'étude n'est que de 5 microns, soit environ 20 fois plus fine qu'un cheveu humain. Pourtant, le réseau DenseNet-121 contient environ 8 millions de paramètres entraînables, soit un paramètre pour chaque 0,37 image de l'ensemble de données.
Chiffres clés
- précision de DenseNet-121: 88,35 %
- précision de ResNet-50: 82,12 %
- score F1 de DenseNet-121: 0,9116
- nombre d'images: 2931
- cas faux positifs: 12 sur 498