Как языковые модели узнают повторы в белках экспресс
Белки — это цепочки аминокислот, и в них часто встречаются повторяющиеся куски. Иногда повторы точные, как одна и та же фраза, сказанная дважды. Иногда — с опечатками: пара букв заменена, но смысл тот же. Такие повторы важны: они помогают белку сворачиваться в нужную форму и выполнять свою работу.
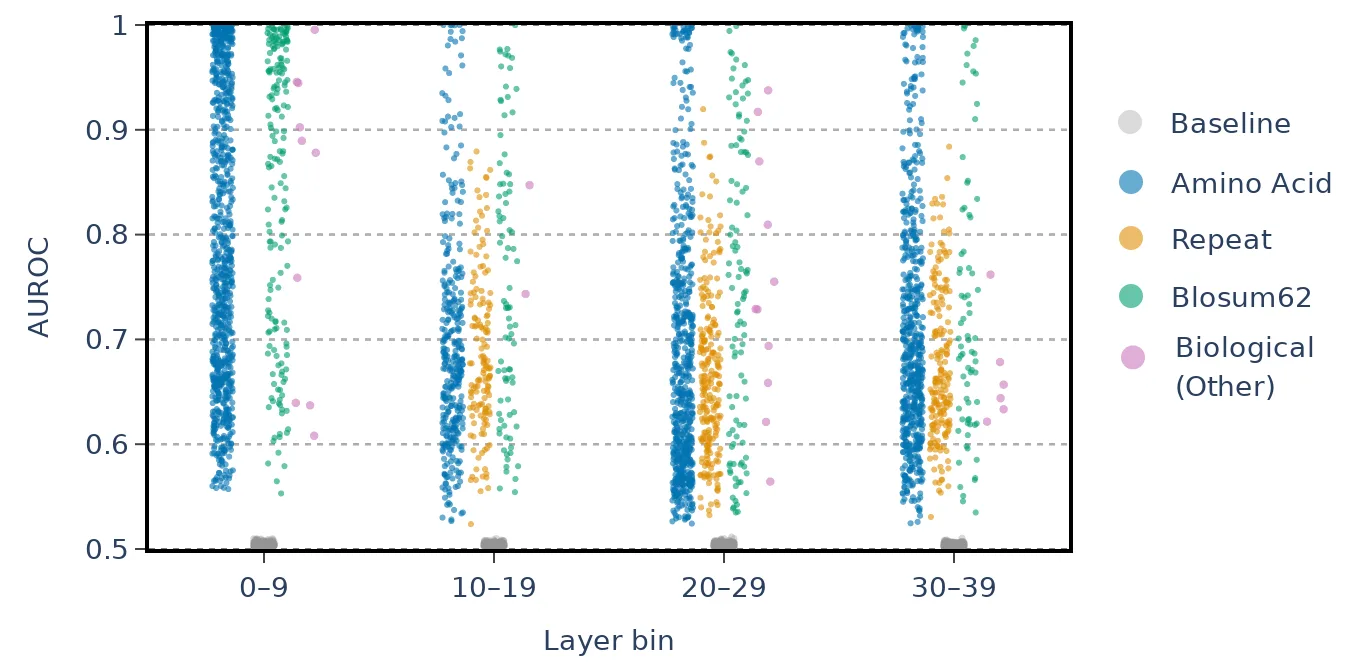
Учёные уже знали, что языковые модели, обученные на миллионах белковых последовательностей, умеют находить эти повторы. Но как именно они это делают, оставалось загадкой. В новом исследовании авторы заглянули внутрь модели и проследили её работу шаг за шагом. Оказалось, что механизм для неточных повторов — более общий: он включает в себя и механизм для точных повторов, как если бы умение читать текст с опечатками автоматически давало умение читать текст без них.
После этого так называемые «индукционные головы» внимания находят одинаковые или похожие куски в разных местах цепочки и переносят информацию между ними. Это помогает модели предсказать, какая аминокислота должна стоять на месте пропуска. Так языковая модель сочетает общий механизм поиска паттернов с биологическими знаниями о свойствах аминокислот.
Это открытие — ступенька к пониманию того, как модели могут улавливать более сложные эволюционные процессы, записанные в белковых последовательностях. А значит, в будущем они смогут лучше предсказывать структуру и функцию белков, что важно для разработки лекарств и биотехнологий.
Оригинальная аннотация
как её написали авторы, на английском arXiv:2602.23179
Protein sequences are abundant in repeating segments, both as exact copies and as approximate segments with mutations. These repeats are important for protein structure and function, motivating decades of algorithmic work on repeat identification. Recent work has shown that protein language models (PLMs) identify repeats, by examining their behavior in masked-token prediction. To elucidate their internal mechanisms, we investigate how PLMs detect both exact and approximate repeats. We find that the mechanism for approximate repeats functionally subsumes that of exact repeats. We then characterize this mechanism, revealing two main stages: PLMs first build feature representations using both general positional attention heads and biologically specialized components, such as neurons that encode amino-acid similarity. Then, induction heads attend to aligned tokens across repeated segments, promoting the correct answer. Our results reveal how PLMs solve this biological task by combining language-based pattern matching with specialized biological knowledge, thereby establishing a basis for studying more complex evolutionary processes in PLMs.
В белках повторы могут быть очень длинными — например, белок титин, который придаёт мышцам упругость, содержит сотни повторяющихся доменов, похожих на звенья цепи.